같은 모델을 써도 어떤 에이전트는 일을 끝내고 어떤 에이전트는 엉뚱한 파일을 고친다. 차이는 대개 모델이 아니라 "이번 호출에 무엇을 넣었는가"에서 난다. 이 글은 컨텍스트 창을 작업대로 보고 지침·절차·장기 기억·외부 지식을 계층으로 나눠 필요할 때만 불러오는 설계, 그리고 실제로 쓰는 Claude Code 환경에서 그 계층이 어떻게 생겼는지를 정리한 것이다.
한눈에 보기
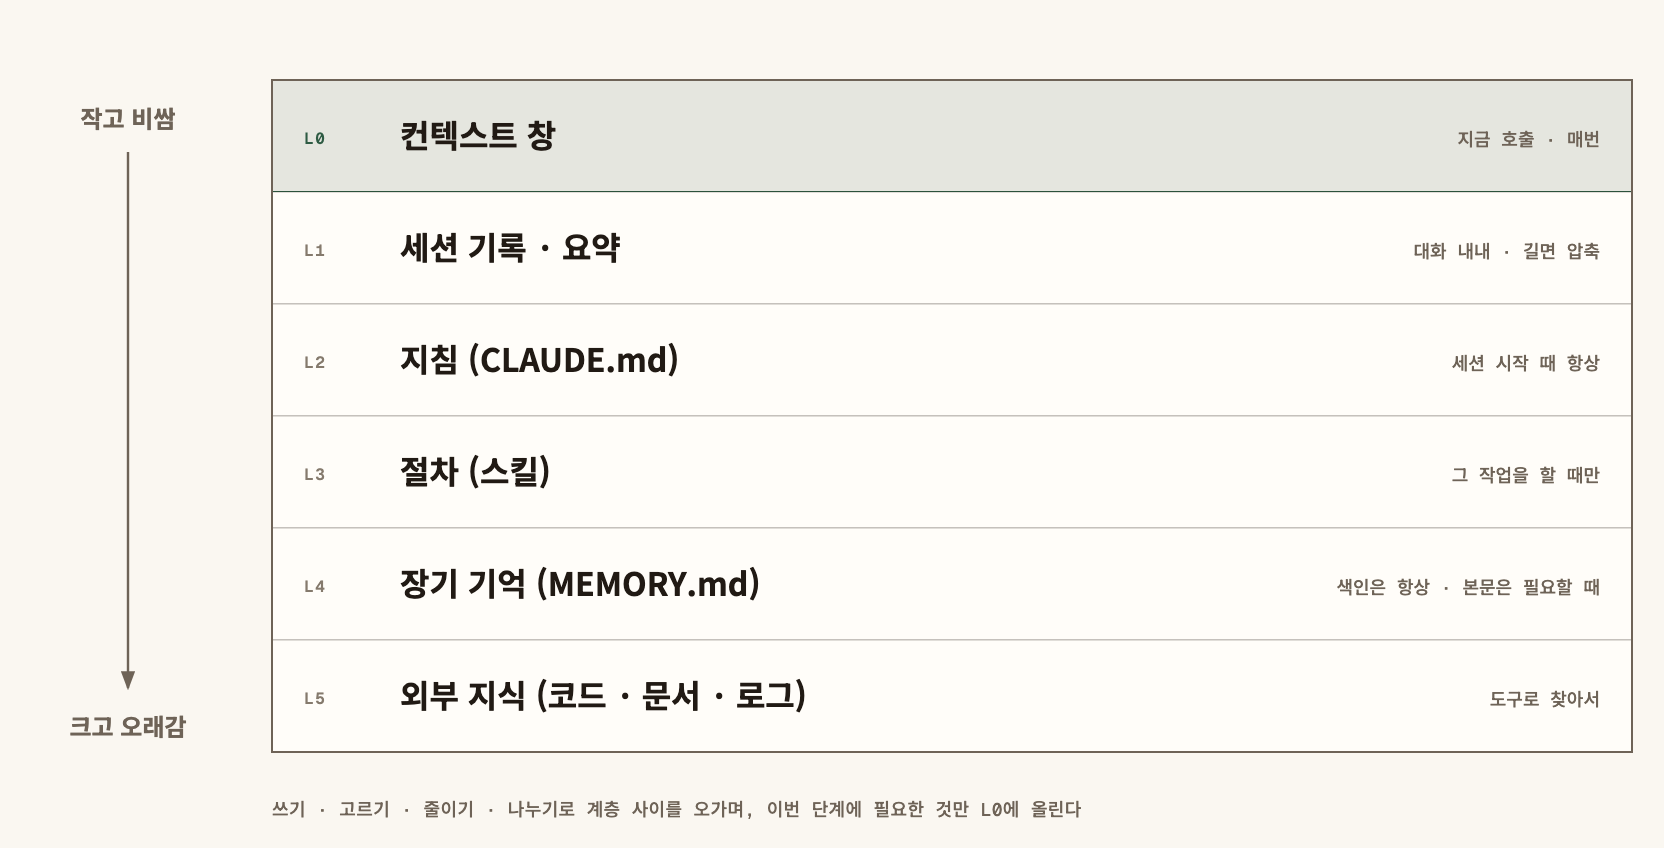
| 계층 | 담는 것 | 언제 창에 들어오나 | 수명 |
|---|---|---|---|
| L0 컨텍스트 창 | 지금 작업에 필요한 것만 | 매 호출 | 호출 한 번 |
| L1 세션 기록·요약 | 이번 대화의 결정, 남은 일 | 대화 내내, 길어지면 요약으로 | 세션 |
| L2 지침 | 프로젝트 규칙, 명령, 금지 사항 | 세션 시작 때 항상 | 저장소와 함께 |
| L3 절차(스킬) | 작업별 단계와 참고 자료 | 그 작업을 할 때만 | 수정할 때까지 |
| L4 장기 기억 | 사용자 선호, 지난 교훈, 진행 중인 일 | 색인은 항상, 본문은 필요할 때 | 지우거나 고칠 때까지 |
| L5 외부 지식 | 코드, 문서, 로그, 검색 결과 | 도구로 찾아서 | 원본에 따라 |
컨텍스트 창은 작업대다
컨텍스트 창은 모델이 한 번에 보는 전부다. 창이 커졌어도 아무거나 넣으면 안 되는 이유가 세 가지 있다.
- 많이 넣을수록 놓친다. 긴 입력의 중간에 있는 정보를 모델이 잘 쓰지 못하는 현상이 연구로 보고돼 있다("Lost in the Middle", Liu 외, 2023). 필요한 규칙이 로그 수천 줄 사이에 묻히면 지켜지지 않는다.
- 오래된 정보가 새 정보와 싸운다. 세 번 전 시도의 실패한 코드가 창에 남아 있으면 모델이 그 코드를 다시 고치려 든다.
- 비용과 지연이 커진다. 호출마다 창 전체를 다시 읽으므로, 쓸모없는 1만 토큰은 매 호출 1만 토큰의 비용이다.
그래서 context engineering은 "더 넣기"가 아니라 "이번 단계에 필요한 것만 고르기"다. 작업대에는 지금 쓰는 도구만 올리고 나머지는 선반에 둔다.
네 가지 동작: 쓰기·고르기·줄이기·나누기
계층을 오가는 동작은 네 가지로 정리된다.
- 쓰기(write): 창 밖에 적어 둔다. 계획 파일, 메모리 파일, 작업 로그. 창이 비워져도 남는다.
- 고르기(select): 필요한 것만 불러온다. 스킬 본문, 관련 메모리 한 건, 검색한 코드 몇 줄.
- 줄이기(compress): 길어진 기록을 요약한다. 대화 압축, 도구 출력 요약.
- 나누기(isolate): 별도 창에서 일하게 한다. 하위 에이전트가 넓게 탐색하고 결론만 돌려준다.
설계할 때는 계층마다 "누가 쓰고, 누가 고르고, 언제 줄이는가"를 정한다. 이 셋이 정해지지 않은 계층은 결국 창에 통째로 들어간다.
L2 지침: 짧고, 이유가 있고, 읽지 말 것을 적는다
지침은 세션마다 항상 들어가므로 가장 비싼 계층이다. 한 줄마다 "이것이 없으면 모델이 틀리는가"를 묻는다.
이 블로그 저장소의 CLAUDE.md는 명령, 완료 기준, 구조를 짧게 적고, 따로 "토큰을 아끼려면 건너뛸 것"이라는 절을 둔다.
## Token-saving: skip these

- `static/reports/` (46MB generated report files), `src/lib/reports.json` (generated), `local.db`, `.svelte-kit/`, `.vercel/`, `node_modules/`.
- `REVIEW.md` is a past review snapshot (2026-10-27); read only when asked about known issues.
- 읽지 말 것 목록은 모델이 생성 파일 46MB를 열어 창을 채우는 일을 막는다.
- 규칙에는 이유를 붙인다. "관리자 액션마다 권한 검사를 반복한다, 라우트 그룹 가드가 없으므로"처럼 이유가 있으면 처음 보는 경우에도 맞게 판단한다.
- 코드에서 알 수 있는 것은 쓰지 않는다. 파일 목록, 함수 설명은 도구로 찾으면 된다. 지침에 옮기면 코드가 바뀔 때 거짓이 된다.
L3 절차: 스킬은 단계적으로 펼친다
작업별 절차는 항상 넣지 않는다. 필요할 때만 펼치도록 세 겹으로 나눈다.
- 목록: 스킬 이름과 설명 한 줄만 항상 창에 있다. 모델은 이 줄을 보고 쓸지 정한다.
- 본문: 스킬을 부르면
SKILL.md본문이 들어온다. 단계, 끝 기준, 절대 규칙. - 참고 자료: 본문이 "이 단계에서 이 파일을 읽는다"고 할 때만 읽는다.
이 글을 쓴 글쓰기 스킬이 그 예다. 본문에는 단계만 있고, 문체 규칙은 references/writing.md, 기준 글은 references/example-*.md 두 편에 따로 둔다. 원고를 쓰는 단계에서 "주제가 가까운 예시 글 하나"만 읽으라고 적어 두어서, 두 편을 다 넣지 않는다. 다이어그램 규칙도 그림을 그리는 단계에서야 불러온다.
설명 한 줄이 곧 검색어다. "언제 쓰는가"를 사용자가 실제로 하는 말로 적어야 맞는 순간에 불린다.
L4 장기 기억: 한 파일에 한 사실, 색인은 한 줄
장기 기억은 세션을 넘어 남는 사실이다. 모델이 직접 쓰고 고치므로 형식이 엄격해야 한다. 아래는 이 환경의 실제 메모리 파일 하나를 줄인 것이다(세션 ID 같은 관리용 필드는 뺐다).
---
name: blog-posts-in-korean
description: "Posts published to the my-blog site must be written entirely in Korean, slug included"
metadata:
  type: feedback
---
Blog posts on my-blog (용데브) go up in Korean: title, body, excerpt and the slug ...

**Why:** The user said "블로그 글 올릴때는 한글로 올려야 돼" when asked to publish the 2026-10-28 dev log.
**How to apply:** When drafting or publishing a post, write Korean and do not pass an English slug. ... See [[my-blog-deploy-and-cache]].
규칙 한 줄, 그 규칙이 생긴 이유(사용자가 한 말 원문), 적용할 때, 관련 기억으로 가는 링크가 한 파일에 있다.
- 한 파일에 한 사실. 여러 사실을 한 파일에 쌓으면 일부만 틀려져도 파일 전체를 믿지 못한다.
- 색인(
MEMORY.md)은 한 줄 요약만. 색인은 항상 창에 들어가고, 본문은 관련 있을 때만 읽는다. 지금 이 환경의 색인은 여섯 줄이다. - 종류를 나눈다. 사용자에 대한 사실(user), 일하는 방식에 대한 교정(feedback), 진행 중인 일(project), 외부 자료 위치(reference).
- 저장하지 않을 것을 정한다. 코드와 git 기록으로 알 수 있는 것, 이번 대화에서만 쓰는 것은 저장하지 않는다. 쌓이기만 하는 메모리는 L0을 다시 어지럽힌다.
- 기억은 그때의 사실이다. 메모리에 적힌 파일이나 옵션 이름은 쓰기 전에 지금도 있는지 확인한다. 고친 사실은 새 파일을 만들지 말고 원래 파일을 고친다.
L1 압축과 하위 에이전트
대화 압축
세션이 길어지면 앞부분을 요약해 창을 비운다. 요약이 무엇을 남기느냐가 그 뒤의 품질을 정한다.
- 남길 것: 내린 결정과 그 이유, 남은 일, 실패한 시도와 실패 원인, 사용자가 한 말 원문.
- 버릴 것: 도구의 원시 출력, 이미 반영된 중간 코드, 탐색하다 버린 경로.
- 결정을 요약에서 다시 뒤집지 않도록, 결정은 파일(계획, 메모리)에도 쓴다. 요약은 줄어들어도 파일은 남는다.
하위 에이전트로 나누기
넓은 탐색(여러 디렉터리 훑기, 문서 수십 쪽 읽기)은 하위 에이전트에게 맡기고 결론만 받는다. 주 창에는 파일 덤프 대신 결론 몇 줄이 들어온다.
대가도 있다. 하위 에이전트는 지시문에 쓴 것만 알고, 주 에이전트는 요약만 본다. 그래서 지시문에는 목표, 이미 배제한 것, 볼 파일, 돌려받을 형식을 적는다. 몇 번의 도구 호출로 끝나는 일은 직접 하는 편이 정확하다.
L5 외부 지식: 도구 출력은 창 밖에서 걸러 들인다
코드, 로그, 검색 결과는 크기가 정해져 있지 않다. 원본을 창에 쏟지 않는다.
- 큰 출력은 파일로 저장하고 필요한 줄만 검색해 읽는다.
- 로그는 통째로 읽지 않고 오류 줄과 앞뒤 몇 줄만 꺼낸다.
- 분석이 목적이면 코드로 세고 걸러 결과만 창에 들인다. 이 환경에는 명령 출력을 별도 저장소에 색인하고 질문에 맞는 부분만 돌려주는 플러그인이 붙어 있다.
- 웹 문서는 원문 대신 질문에 필요한 단락만 가져온다.
계층을 왜 나누는가
| 계층 | 누가 쓰나 | 없거나 섞이면 생기는 일 |
|---|---|---|
| L0 창 관리 | 에이전트 | 규칙이 로그 사이에 묻혀 지켜지지 않음 |
| L1 요약 | 에이전트 | 긴 세션 끝에 앞의 결정을 잊고 뒤집음 |
| L2 지침 | 사람 | 매 세션 같은 설명을 반복, 생성 파일을 읽느라 창 소모 |
| L3 스킬 | 사람, 에이전트 | 모든 절차가 항상 들어가 창이 비대해짐 |
| L4 장기 기억 | 에이전트 | 같은 교정을 세션마다 다시 해야 함 |
| L5 외부 지식 | 도구 | 원시 출력이 창을 채워 판단할 자리가 없음 |
자주 하는 실수
- 지침에 모든 것을 적는다. 항상 들어가는 계층이 커지면 정작 이번 작업에 필요한 정보가 밀려난다.
- 메모리에 무엇이든 저장한다. 코드로 알 수 있는 사실까지 쌓이면 색인이 길어지고, 코드가 바뀌면 거짓 기억이 된다.
- 오래된 기억을 확인 없이 쓴다. 이름이 바뀐 함수를 기억대로 부르면 그럴듯한 오류가 난다.
- 도구 출력을 통째로 넣는다. 한 번의 빌드 로그가 창의 절반을 쓰고 그 뒤 판단이 흐려진다.
- 하위 에이전트에게 맥락 없이 일을 넘긴다. 이미 배제한 가설을 다시 확인해 오고, 주 에이전트는 그 요약을 그대로 믿는다.
설계 점검표
- 계층마다 담는 것, 불러오는 시점, 쓰는 주체가 정해져 있다
- 지침 파일에 읽지 말아야 할 큰 파일·생성 폴더 목록이 있다
- 지침의 규칙마다 이유가 한 줄 붙어 있다
- 스킬 설명 한 줄에 언제 쓰는지가 사용자 말투로 적혀 있다
- 스킬 참고 자료는 본문이 지시한 단계에서만 읽는다
- 장기 기억은 한 파일 한 사실이고 색인은 한 줄씩이다
- 저장하지 않을 정보의 기준이 있다
- 기억 속 파일·옵션 이름은 쓰기 전에 존재를 확인한다
- 결정과 남은 일은 요약뿐 아니라 파일에도 남는다
- 큰 도구 출력은 창 밖에서 걸러 필요한 부분만 들인다
Context engineering은 큰 창을 채우는 기술이 아니라, 지침·절차·기억·외부 지식을 계층으로 나눠 두고 이번 단계에 필요한 것만 작업대에 올리는 설계다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.