복제된 데이터를 쓰는 시스템은 언젠가 노드 사이 통신이 끊기고, 그 순간 "그래도 응답할 것인가, 틀릴 수 있으니 거절할 것인가"를 고르게 된다. CAP은 이 선택이 피할 수 없다는 것을, PACELC는 장애가 없는 평상시에도 지연과 일관성 사이의 선택이 계속된다는 것을 알려 준다. 이 글은 두 이론이 실제로 말하는 범위를 짚고, 데이터 종류별로 선택을 정해 설정과 장애 시험까지 옮기는 순서를 정리한 것이다.
한눈에 보기
| 상황 | 질문 | 고르는 것 | 설정으로 나타나는 곳 |
|---|---|---|---|
| 네트워크 분할(P) | 끊긴 쪽 노드가 요청을 받으면? | 가용성(A) 또는 일관성(C) | 쓰기 정족수, 리더 선출, 장애 조치 정책 |
| 평상시(E) | 복제가 끝나기 전에 응답할까? | 지연(L) 또는 일관성(C) | 동기·비동기 복제, 읽기 일관성 수준 |
| 데이터별 | 이 데이터가 잠깐 틀리면 무슨 일이 생기나? | 데이터마다 다른 조합 | 테이블·키스페이스·API 단위 설정 |
CAP이 실제로 말하는 것
CAP은 Eric Brewer가 2000년 PODC 기조연설에서 추측으로 내놓았고, 2002년 Seth Gilbert와 Nancy Lynch가 정리 형태로 증명했다. 증명에서 세 글자의 뜻은 좁다.
- C(Consistency): 모든 읽기가 가장 최근에 완료된 쓰기를 본다. 데이터베이스 ACID의 C가 아니라 선형화 가능성(linearizability)에 가깝다.
- A(Availability): 장애가 나지 않은 노드에 온 요청은 모두 결국 응답을 받는다. "99.9% 가동"이 아니라 "살아 있는 노드는 거절하지 않는다"는 뜻이다.
- P(Partition tolerance): 노드 사이 메시지가 임의로 사라져도 시스템이 동작을 계속한다.
흔히 "셋 중 둘을 고른다"고 말하지만 실무에서 P는 고를 수 있는 항목이 아니다. 여러 노드가 네트워크로 연결되는 순간 분할은 생긴다. 그래서 CAP의 실제 질문은 "분할이 났을 때 C와 A 중 무엇을 포기하나"이다. CA 시스템이라는 말은 분할이 없다고 가정한 단일 노드나 한 장비 안의 시스템에만 맞는다.
CAP이 말하지 않는 것도 분명히 해 둔다. 분할이 없을 때의 동작, 응답 시간, 부분적인 일관성 수준은 CAP의 범위 밖이다.
CAP만으로 부족한 이유: 평상시의 지연
분할은 드물다. 대부분의 시간에 시스템은 정상이고, 그때도 매 요청마다 선택이 있다. 쓰기를 받은 노드가 다른 복제본에 전달이 끝날 때까지 기다리면 일관성은 지키지만 응답이 느려진다. 기다리지 않고 바로 응답하면 빠르지만, 직후 다른 복제본에서 읽은 사용자는 옛 값을 본다.
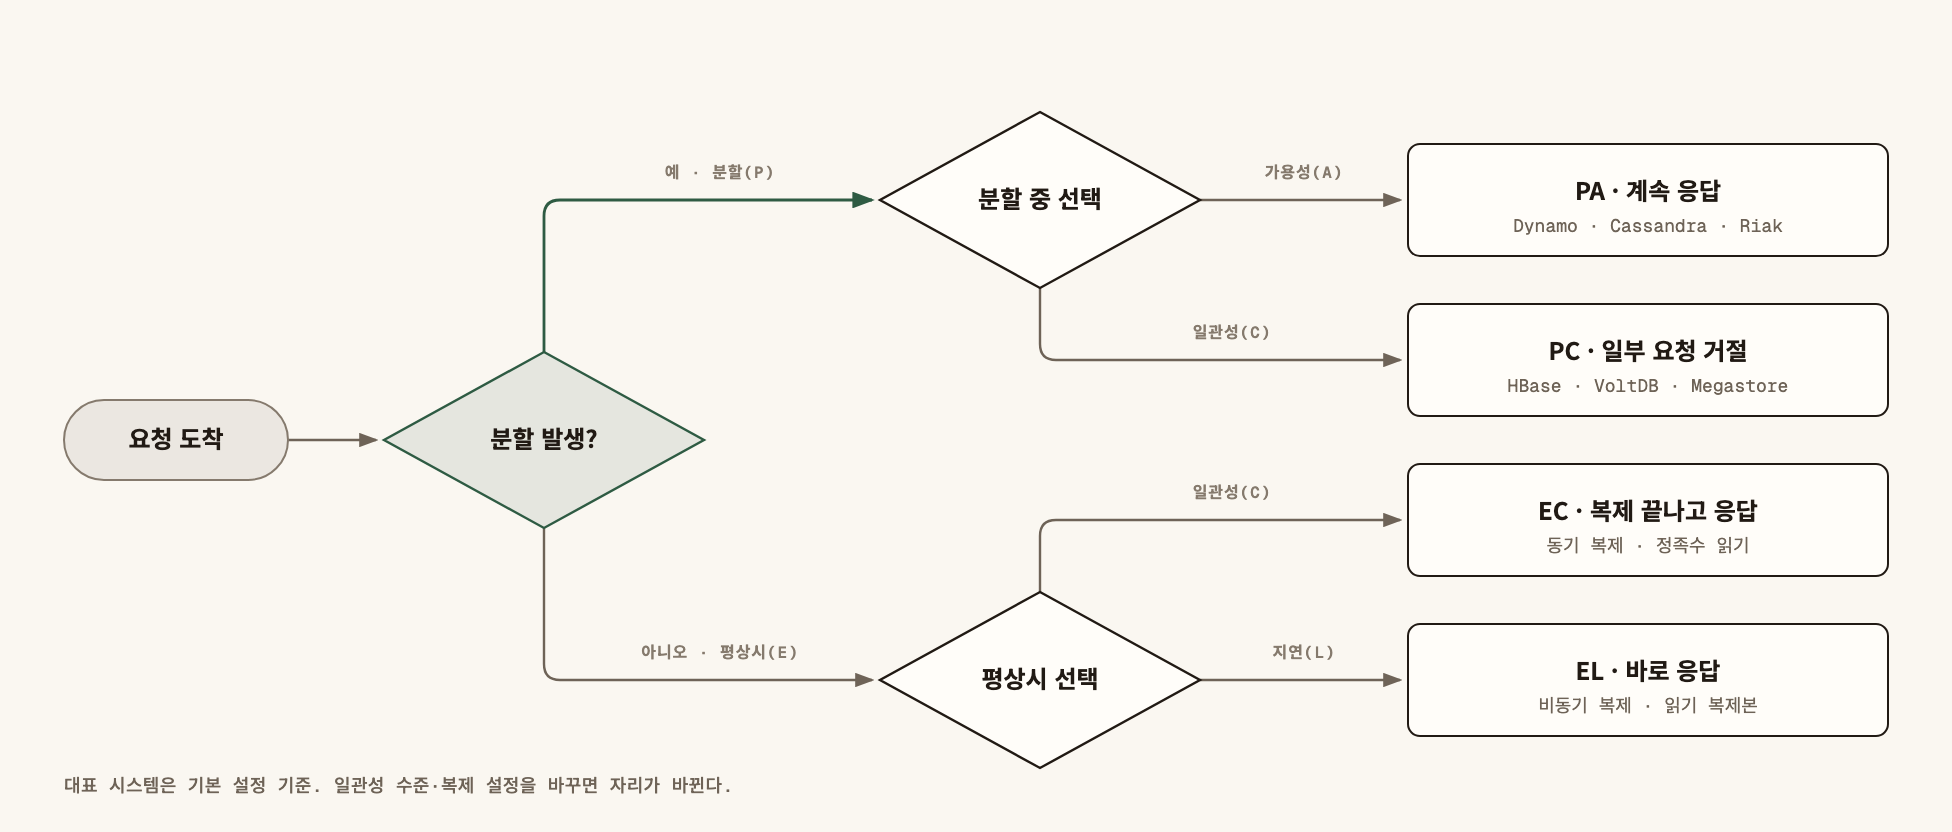
Daniel Abadi는 이 빈틈을 PACELC로 정리했다(2010년 블로그 글, 2012년 IEEE Computer 논문). 읽는 법은 다음과 같다.
분할(P)이 있으면 가용성(A)과 일관성(C) 중 하나를, 그렇지 않으면(E, Else) 지연(L)과 일관성(C) 중 하나를 고른다.
이 틀의 쓸모는 평상시 선택이 응답 시간이라는 숫자로 바로 드러난다는 데 있다. 동기 복제 대상이 다른 데이터센터에 있으면 쓰기마다 그 왕복 시간이 더해진다.
PACELC 네 조합과 대표 시스템
| 조합 | 분할 시 | 평상시 | Abadi 2012 논문의 예 |
|---|---|---|---|
| PA/EL | 응답 계속 | 빠른 응답 우선 | Dynamo, Cassandra, Riak |
| PC/EC | 일부 요청 거절 | 동기 복제 | BigTable·HBase, VoltDB/H-Store, Megastore |
| PA/EC | 응답 계속 | 동기 복제 | MongoDB |
| PC/EL | 일부 요청 거절 | 빠른 응답 우선 | PNUTS |
이 분류는 논문 당시의 기본 설정 기준이다. 같은 제품도 설정에 따라 자리가 바뀐다. Cassandra는 읽기·쓰기 일관성 수준을 ONE에서 QUORUM이나 ALL로 올리면 평상시 C 쪽으로 움직인다. 단일 리더 RDBMS도 비동기 복제 읽기 복제본을 붙이면 그 읽기 경로는 EL이 된다. 그래서 "우리 DB는 CP다"라고 말하기보다 "이 테이블의 이 경로는 PC/EC로 설정했다"라고 말해야 정확하다.
1단계: 데이터마다 잠깐 틀렸을 때의 비용을 적는다
한 시스템 안에서도 데이터마다 답이 다르다. 먼저 데이터를 나누고, 각 데이터가 몇 초 동안 옛 값을 보여 주면 무슨 일이 생기는지 적는다.
- 계좌 잔액, 재고 차감, 좌석 예약: 옛 값으로 결정하면 두 번 팔리거나 음수 잔액이 생긴다. PC/EC 후보다.
- 장바구니, 좋아요 수, 조회 수: 잠깐 틀려도 나중에 합치면 된다. 응답이 끊기는 쪽이 손해가 크다. PA/EL 후보다.
- 사용자 프로필, 설정값: 본인은 방금 바꾼 값을 봐야 하지만 다른 사람은 몇 초 늦어도 된다. "본인 쓰기 후 읽기(read-your-writes)"만 보장하는 중간 지점이 맞다.
이 표를 업무 담당자와 같이 쓴다. "몇 초까지 틀려도 되나"는 기술이 아니라 업무가 정하는 값이고, 그 답이 없으면 개발자가 아무렇게나 정하게 된다.
2단계: 분할 시 동작을 결정 기록으로 남긴다
분할 시 동작은 장애가 난 뒤에 정하면 늦다. 데이터 묶음마다 ADR 한 장으로 남긴다.
# ADR-014 재고 차감의 분할 시 동작

## 결정
재고 차감은 PC/EC로 운영한다. 쓰기는 과반수 노드 확인 후 성공으로 본다.
과반수에 닿지 못하면 "잠시 후 다시 시도" 오류를 돌려주고 주문을 보류한다.

## 이유
초과 판매 1건의 환불·보상 비용이 주문 지연보다 크다.

## 감수하는 것
- 분할 중 소수 쪽 데이터센터의 주문은 거절된다.
- 평상시 쓰기 지연이 복제 왕복 시간만큼 늘어난다.

## 확인 방법
분기마다 노드 하나를 격리하는 장애 시험에서 초과 판매 0건, 거절 응답 확인.
"감수하는 것"이 가장 중요한 칸이다. 포기한 쪽을 적어 두지 않으면 장애 때 거절 응답을 버그로 보고 고치려 든다.
3단계: 평상시 선택을 설정값으로 옮긴다
결정은 설정에 반영돼야 의미가 있다. 복제본 3개(N=3)인 Cassandra라면 쓰기 정족수 W와 읽기 정족수 R을 고른다. R + W > N이면 읽기와 쓰기 대상이 최소 한 노드 겹쳐서 직전 쓰기를 읽을 수 있다.
-- cqlsh: 재고 경로는 겹치게(W=2, R=2), 조회 수 경로는 빠르게(W=1, R=1)
CONSISTENCY QUORUM;
UPDATE inventory SET qty = 41 WHERE sku = 'A-100';

CONSISTENCY ONE;
-- page_views는 counter 열을 가진 테이블
UPDATE page_views SET hits = hits + 1 WHERE page = '/home';
정족수 겹침만으로 선형화가 보장되지는 않는다. 동시 쓰기 충돌은 마지막 쓰기 시각으로 정리되므로, 재고처럼 조건부 갱신이 필요하면 경량 트랜잭션(IF qty > 0) 같은 별도 장치가 필요하다.
PostgreSQL 단일 리더 구성에서는 동기 복제 대상 수로 EC와 EL을 고른다.
# postgresql.conf: 대기 서버 두 대 중 한 대가 확인해야 커밋 완료
synchronous_commit = on
synchronous_standby_names = 'ANY 1 (standby_a, standby_b)'
이렇게 두면 쓰기는 대기 서버 한 대의 확인을 기다린다. 두 대가 모두 끊기면 커밋이 멈추는데, 이것이 PC를 고른 대가다. 읽기 복제본으로 보내는 조회는 여전히 비동기라 EL이므로, 1단계 표에서 "본인 쓰기 후 읽기"가 필요한 화면은 리더에서 읽게 라우팅한다.
4단계: 장애 시험으로 선택이 지켜지는지 본다
설정은 시험하지 않으면 믿을 수 없다. 운영과 같은 구성의 시험 환경에서 노드 하나를 네트워크에서 떼어 놓고 다음을 본다.
- PC로 정한 경로가 소수 쪽에서 거절 응답을 내는가, 아니면 조용히 쓰기를 받는가.
- PA로 정한 경로가 분할 중에도 응답하는가, 분할이 풀린 뒤 값이 합쳐지는가.
- 리더가 바뀌는 동안 이미 성공 응답을 받은 쓰기가 사라지지 않는가.
방화벽 규칙으로 노드 간 포트를 막는 정도로 시작해도 된다. 분산 DB의 일관성 주장을 검증하는 공개 도구로는 Jepsen이 널리 알려져 있고, 제품별 분석 보고서도 공개돼 있어 도입 전에 읽어 볼 만하다.
정리: 데이터별 선택표
| 데이터 | 선택 | 분할 시 사용자가 보는 것 | 반대로 골랐을 때 생기는 일 |
|---|---|---|---|
| 재고·잔액 | PC/EC | "잠시 후 다시 시도" | 초과 판매, 음수 잔액 |
| 장바구니 | PA/EL | 정상 응답, 나중에 병합 | 장애 때 담기 실패로 이탈 |
| 프로필 | PA/EL + 본인은 리더 읽기 | 남에게는 몇 초 늦게 보임 | 본인이 바꾼 값이 안 보여 재시도 |
| 조회 수 | PA/EL | 숫자가 잠깐 덜 오름 | 조회마다 복제 대기로 느려짐 |
자주 하는 실수
- P를 빼고 CA를 골랐다고 말한다. 네트워크로 묶인 순간 분할은 생기므로, CA라는 말은 분할 시 동작을 정하지 않았다는 뜻이 된다.
- 제품 이름으로 CP·AP를 단정한다. 같은 제품도 일관성 수준과 복제 설정에 따라 자리가 바뀌어, 실제 동작과 문서가 어긋난다.
- 시스템 전체에 한 가지 선택을 적용한다. 조회 수까지 동기 복제하면 느려지고, 재고까지 비동기로 두면 초과 판매가 난다.
- 평상시 지연을 계산에 넣지 않는다. 데이터센터를 넘는 동기 복제는 쓰기마다 왕복 시간을 더해 응답 목표를 넘기기 쉽다.
- 분할 시 거절 응답을 화면에서 처리하지 않는다. PC를 골랐다면 사용자에게 보일 문구와 재시도 흐름이 같이 있어야 한다.
점검표
- 데이터 묶음마다 "몇 초까지 옛 값이 허용되는지"를 업무 담당자와 함께 적었다.
- 데이터 묶음마다 PACELC 조합을 하나씩 정했다.
- 분할 시 동작과 감수하는 것을 ADR로 남겼다.
- 쓰기·읽기 정족수 또는 동기 복제 대상 수가 결정과 맞게 설정돼 있다.
- 읽기 복제본으로 가는 조회 중 본인 쓰기 후 읽기가 필요한 화면을 리더로 라우팅했다.
- 동시 쓰기 충돌을 어떻게 정리하는지(마지막 쓰기, 조건부 갱신)를 확인했다.
- PC 경로의 거절 응답에 대한 화면 문구와 재시도 흐름이 있다.
- 노드 하나를 격리하는 장애 시험을 정기적으로 돌리고 결과를 기록한다.
CAP은 분할 때 무엇을 포기할지, PACELC는 평상시에 무엇을 포기할지를 묻는 질문이고, 그 답을 데이터마다 정해 설정과 장애 시험으로 확인하는 것이 분산 시스템 설계의 실제 작업이다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.