CUBRID HA는 master 노드가 죽으면 slave를 master로 올려 DB를 살려 두지만, 애플리케이션까지 저절로 살아나지는 않는다. 전환되는 몇십 초 동안 진행 중이던 트랜잭션은 롤백되고, 풀에 남은 연결은 죽은 채 남으며, 재시도를 잘못 넣으면 같은 거래가 두 번 들어간다. 이 글은 CUBRID HA의 전환 과정을 애플리케이션 쪽에서 보고, JDBC URL·커넥션 풀·재시도·배치·페일백을 어떻게 준비할지 정리한 것이다.
한눈에 보기
장애 전환은 세 계층에서 따로 일어난다. 계층마다 장애를 넘기는 장치가 다르고, 애플리케이션이 맡아야 할 몫도 다르다.
| 계층 | 장애 때 일어나는 일 | 넘기는 장치 | 애플리케이션 몫 |
|---|---|---|---|
| DB 서버 | master가 죽고 slave가 master로 승격 | cub_master 하트비트, copylogdb·applylogdb 복제 |
롤백된 트랜잭션 다시 실행 |
| 브로커 | 연결된 DB가 바뀌거나 브로커 자체가 죽음 | databases.txt의 호스트 목록, ACCESS_MODE |
끊긴 연결 버리기 |
| 애플리케이션 | 풀의 연결이 죽고 요청이 오류로 끝남 | JDBC altHosts, 풀 검증, 재시도 |
멱등성, 재시작 지점, 경보 |
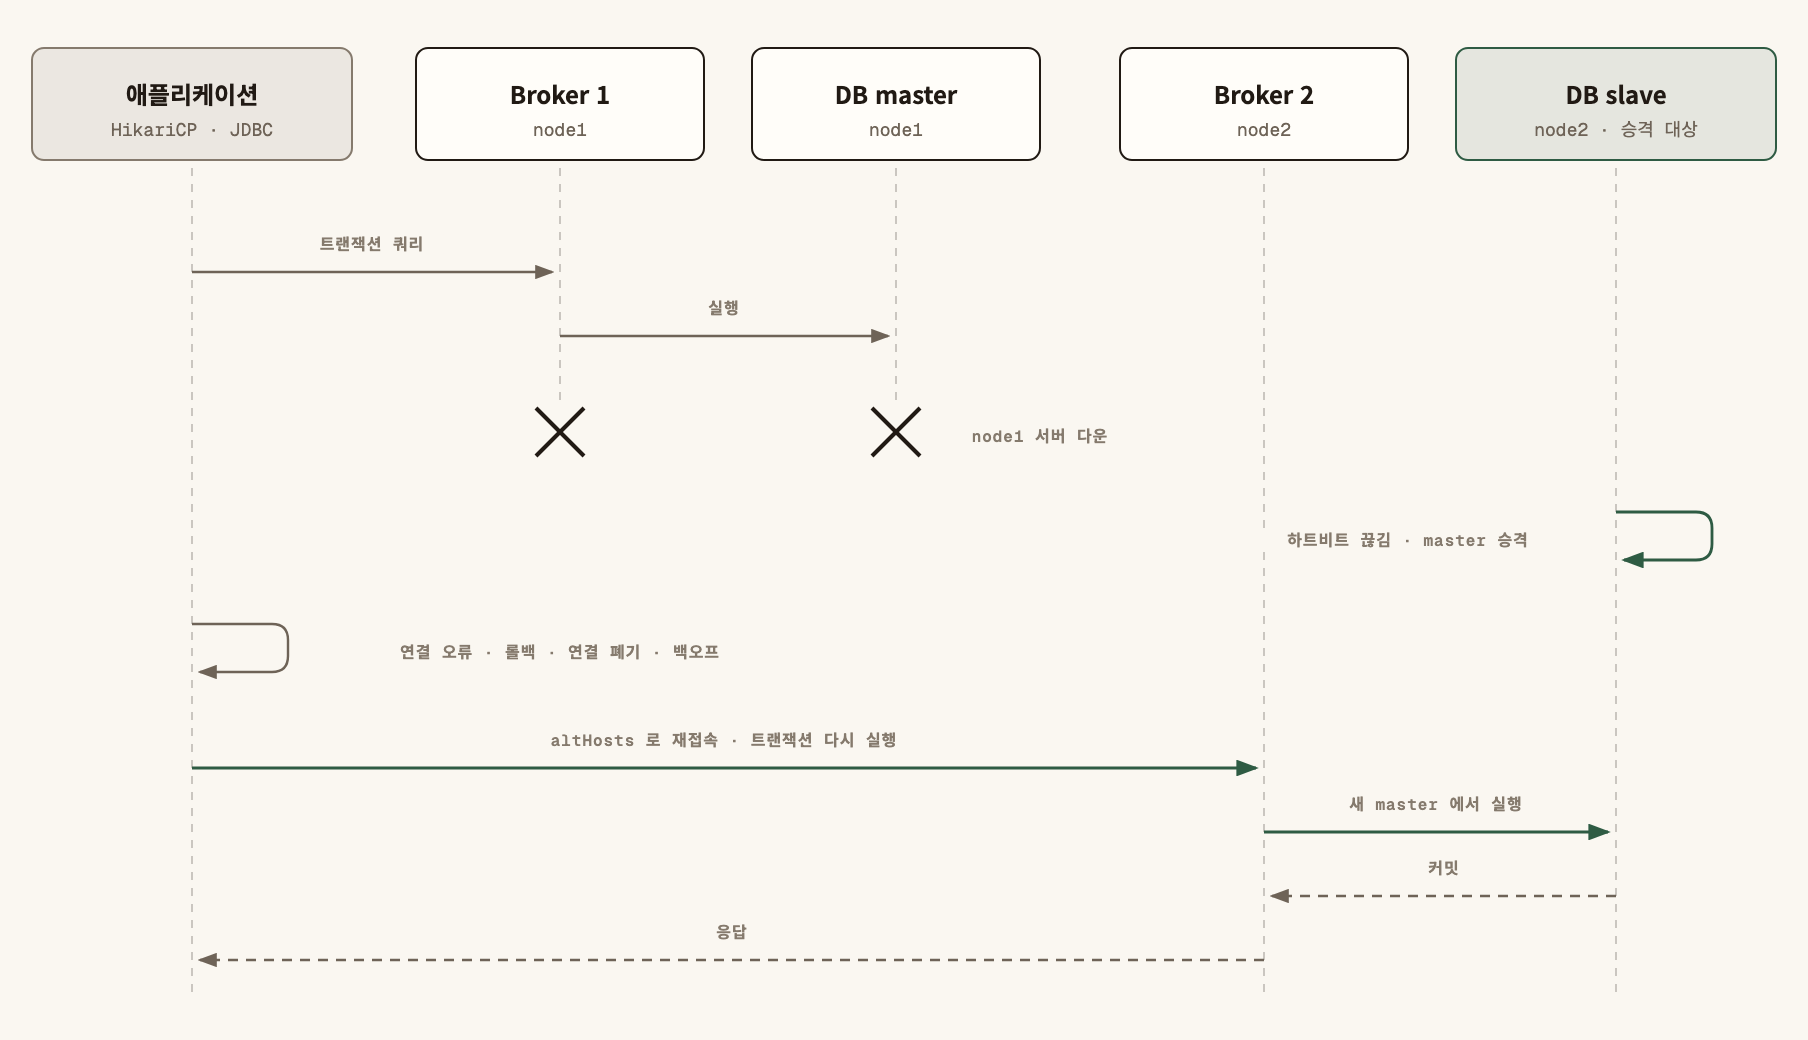
그림은 브로커와 DB가 한 서버에 같이 있는 흔한 배치에서 node1 서버 전체가 꺼진 경우다. DB 계층은 CUBRID가 넘기지만, 롤백된 트랜잭션을 다시 실행하는 일은 애플리케이션만 할 수 있다.
CUBRID HA 구조: 애플리케이션이 알아야 할 만큼만
노드와 프로세스
- 각 노드의
cub_master가 서로 하트비트를 주고받는다. master의 하트비트가 끊기면 slave가 master로 승격된다. copylogdb는 master의 트랜잭션 로그를 slave 쪽으로 복사하고,applylogdb는 복사된 로그를 slave DB에 반영한다. slave는 "로그를 받아 다시 실행하는" 복제본이다.- HA 그룹과 노드는
cubrid_ha.conf의ha_node_list(예:cubgrp@node1:node2)와ha_db_list로 정한다. HA 사용 여부(ha_mode)를 어느 설정 파일에 두는지는 CUBRID 버전별 매뉴얼 확인.
브로커
- 애플리케이션은 DB 서버가 아니라 브로커에 붙는다. 브로커의 CAS 프로세스가 대신 DB에 접속한다.
- 브로커가 어느 DB 노드로 갈지는
databases.txt의 호스트 목록(node1:node2)과cubrid_broker.conf의ACCESS_MODE가 정한다.RW는 master로,RO는 slave를 우선해 읽기 전용으로,SO는 slave에만 붙는다. PREFERRED_HOSTS로 먼저 시도할 노드를 지정할 수 있다. 읽기 전용 브로커를 특정 slave에 묶을 때 쓴다.
복제 모드가 정하는 손실 범위
ha_copy_sync_mode가 커밋 응답과 로그 복사의 순서를 정한다. 동기 모드는 slave가 로그를 받은 뒤 커밋을 돌려주므로 응답이 느려지는 대신 커밋된 데이터를 잃지 않는다. 비동기 모드는 빠르지만, 커밋 응답을 받았는데 slave에 아직 도착하지 않은 트랜잭션이 승격 뒤 사라질 수 있다. 어느 모드를 쓰는지는 업무가 견딜 수 있는 손실 범위로 정하고, 그 결정을 설계 문서에 남긴다.
장애 전환 순간 애플리케이션이 겪는 일
DB가 몇십 초 만에 돌아와도 애플리케이션 쪽에서는 아래 일이 한꺼번에 생긴다.
- 진행 중이던 트랜잭션은 롤백된다. 커밋 전 데이터는 새 master에 없다. 화면은 오류를 보고, 사용자는 저장 버튼을 다시 누른다.
- 커밋 응답이 오지 않은 트랜잭션은 결과를 알 수 없다. 커밋 직후 연결이 끊기면 커밋이 됐는지 안 됐는지 애플리케이션은 모른다. 이 경우가 중복 처리의 가장 흔한 원인이다.
- 풀의 연결은 대부분 죽어 있다. 풀은 연결이 죽었는지 빌려줄 때까지 모른다. 검증이 없으면 요청마다 죽은 연결을 하나씩 받아 실패한다.
- 승격 직후 새 master는 늦을 수 있다. slave가 받은 로그를 다 반영하기 전에는 최신 데이터가 아닐 수 있고, 캐시가 비어 첫 몇 분 동안 응답이 느리다.
- 오류 코드가 여러 가지로 나온다. 소켓 끊김, 브로커 접속 실패, 서버 모드 변경 같은 오류가 섞여 나온다. 어떤 코드가 나오는지는 훈련에서 직접 모아 "재시도해도 되는 오류" 목록으로 만든다.
JDBC URL과 브로커: 접속 경로를 둘 이상 둔다
브로커가 하나뿐이면 그 브로커가 있는 서버가 꺼지는 순간 DB가 살아 있어도 접속할 길이 없다. JDBC URL에 다른 브로커를 함께 적는다.
# 예시: 브로커 2개, node1 우선
spring.datasource.url=jdbc:cubrid:node1:33000:appdb:::?altHosts=node2:33000&rcTime=600&connectTimeout=5
spring.datasource.driver-class-name=cubrid.jdbc.driver.CUBRIDDriver
altHosts: 첫 브로커에 접속하지 못하면 차례로 시도할 브로커 목록이다.rcTime: 대체 브로커로 넘어간 뒤 원래 브로커로 다시 붙어 보는 간격(초)이다. 원래 노드가 돌아오면 연결이 이 간격으로 되돌아간다.connectTimeout: 죽은 브로커에서 오래 기다리지 않게 짧게 둔다. 이 값이 길면altHosts로 넘어가기 전에 요청이 먼저 시간 초과로 끝난다.loadBalance=true를 주면 첫 브로커를 고정하지 않고 목록에서 고르게 나눈다. 평소 부하를 나누고 싶을 때 쓴다.
각 속성의 기본값과 단위는 드라이버 버전마다 다를 수 있으니 CUBRID 버전별 매뉴얼 확인. URL에 비밀번호를 쓰지 말고 username·password 속성이나 비밀값 저장소로 뺀다.
커넥션 풀: 죽은 연결을 빨리 버린다
전환 뒤 가장 오래 남는 증상은 "DB는 살았는데 애플리케이션만 계속 오류"다. 풀이 죽은 연결을 들고 있기 때문이다.
spring:
  datasource:
    hikari:
      maximum-pool-size: 20
      connection-timeout: 3000      # 연결을 못 빌리면 3초 안에 실패
      validation-timeout: 2000
      max-lifetime: 1800000         # 30분마다 연결 교체
      keepalive-time: 300000        # 쉬는 연결도 5분마다 확인
      connection-test-query: SELECT 1 FROM db_root
- HikariCP는 드라이버의
isValid()로 연결을 검증한다. 드라이버가 이를 지원하지 않으면connection-test-query가 필요하다. 쓰는 CUBRID JDBC 버전에서 동작을 확인하고 정한다. connection-timeout을 짧게 두면 전환 중 요청이 스레드를 붙잡고 쌓이지 않는다. 길면 WAS 스레드가 모두 연결 대기에 묶여 전환이 끝나도 한동안 응답하지 못한다.max-lifetime은 방화벽·브로커의 유휴 연결 정리 시간보다 짧게 둔다. 그래야 페일백 뒤에도 연결이 자연스럽게 새 경로로 바뀐다.- 풀 지표(활성·대기 연결 수, 연결 획득 시간)를 모니터링에 올린다. 전환 시점에 대기 수가 치솟았다가 몇 분 안에 내려오는지가 복구를 판단하는 기준이 된다.
재시도: 트랜잭션 단위로, 멱등한 것만
재시도는 복구 시간을 줄이지만 잘못 넣으면 이중 출금 같은 사고를 만든다.
원칙
- 쿼리가 아니라 트랜잭션 전체를 다시 실행한다. 롤백된 트랜잭션 안의 쿼리 하나만 다시 보내면 앞의 변경이 빠진 채 반만 저장된다.
- 멱등한 작업만 자동 재시도한다. 조회, 같은 키로 덮어쓰는 갱신, 요청 ID로 중복을 거르는 등록은 재시도해도 된다. 그렇지 않은 등록·이체는 요청 ID를 먼저 붙인다.
- 재시도 대상 오류를 목록으로 정한다. 연결 끊김 계열만 재시도하고, 제약 조건 위반 같은 업무 오류는 바로 실패시킨다.
- 횟수와 간격을 제한한다. 예시로 최대 3회, 1초·2초·4초 간격이다. 간격 없이 재시도하면 승격 중인 DB에 연결 폭주를 일으킨다.
@Retryable(retryFor = {TransientDataAccessException.class, DataAccessResourceFailureException.class},
           maxAttempts = 3, backoff = @Backoff(delay = 1000, multiplier = 2))
@Transactional
public void approve(String requestId, long orderId) {
    if (requestLog.exists(requestId)) return;   // 이미 처리된 요청은 건너뜀
    orderRepository.approve(orderId);
    requestLog.save(requestId);                 // request_id 에 유일 제약: 동시 재시도도 한 번만
}
@Retryable이 @Transactional보다 바깥에서 돌아야 재시도마다 새 트랜잭션이 열린다. 같은 메서드에 둘을 붙였다면 프록시 적용 순서를 확인한다. 드라이버 오류가 Spring의 어떤 예외로 바뀌는지도 훈련에서 확인해 retryFor를 맞춘다.
배치와 페일백: 다시 시작할 자리와 되돌아갈 때를 정한다
배치
- 몇 시간짜리 배치가 한 트랜잭션이면 전환 한 번에 처음부터 다시 돌려야 한다. 일정 건수마다 커밋하고, 마지막으로 처리한 키를 남긴다.
- Spring Batch를 쓰면
JobRepository가 재시작 지점을 남기지만, 그 메타 테이블도 같은 DB에 있으면 전환 때 함께 롤백된다. 재시작 후 처리 건수가 맞는지 대사 쿼리로 확인한다. - 커밋 응답을 못 받은 마지막 묶음은 "됐을 수도, 안 됐을 수도" 있다. 다시 실행해도 결과가 같도록 업서트나 처리 표시 컬럼을 둔다.
페일백
- 장애가 났던 노드는 복구 뒤 slave로 돌아온다. 원래 master로 되돌리는 페일백은 자동으로 하지 말고, 사용량이 적은 시간에 계획된 전환으로 한다.
- 페일백도 애플리케이션에는 똑같은 장애 전환이다. 위의 재시도·풀 설정이 그대로 시험대에 오른다.
- 노드 상태는
cubrid heartbeat status로, 서버 모드는cubrid changemode로 확인한다. 정확한 절차와 옵션은 CUBRID 버전별 매뉴얼 확인.
자주 하는 실수
- DB만 이중화하고 브로커는 하나로 둔다. 브로커가 있는 서버가 꺼지면 살아 있는 DB에 갈 길이 없다.
- 커넥션 풀 검증을 끈다. 성능 때문에 끈 검증이 전환 뒤 몇십 분짜리 오류를 만든다.
- 쿼리 단위로 재시도한다. 롤백된 트랜잭션의 앞부분이 빠져 데이터가 반만 남는다.
- 복제 모드를 기본값 그대로 둔다. 커밋된 데이터를 잃어도 되는지 아무도 정하지 않은 상태가 된다.
- 훈련 없이 설정만 한다. 어떤 오류 코드가 나오고 몇 초 만에 복구되는지는 실제로 꺼 봐야 안다.
점검표
-
ha_node_list와databases.txt호스트 목록이 실제 노드와 일치한다 -
ha_copy_sync_mode를 업무 손실 허용 범위로 정하고 설계 문서에 남겼다 - 브로커가 2대 이상이고 JDBC URL에
altHosts가 있다 -
connectTimeout과 풀connection-timeout이 요청 시간 초과보다 짧다 - 풀이 연결을 검증하고
max-lifetime이 유휴 연결 정리 시간보다 짧다 - 재시도는 트랜잭션 단위이고 대상 오류·횟수·간격이 정해져 있다
- 자동 재시도하는 등록·변경 작업에 요청 ID 중복 검사가 있다
- 배치가 일정 건수마다 커밋하고 재시작 지점을 남긴다
- master 프로세스 종료와 서버 전원 차단을 각각 훈련해 오류 코드와 복구 시간을 기록했다
- 페일백 절차를 문서로 남기고 계획된 시간에 한 번 이상 실행해 봤다
CUBRID HA가 DB를 살리는 동안 애플리케이션은 끊긴 연결을 버리고, 다른 경로로 다시 붙고, 롤백된 일을 안전하게 한 번만 다시 해야 하며, 이 세 가지는 훈련으로 확인하기 전까지 준비된 것이 아니다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.