교과서는 프로세스와 스레드를 다른 개념으로 설명하지만, Linux 커널 안에서는 둘 다 같은 구조체 하나(task_struct)로 표현되는 "태스크"다. 차이는 무엇을 공유하느냐뿐이다. 이 차이를 알면 top에 보이는 숫자, Java 스레드 수와 메모리, 컨텍스트 스위칭 비용, OOM 동작이 한 줄로 이어진다. 이 글은 커널 관점에서 프로세스와 스레드가 어떻게 만들어지고 무엇을 나눠 쓰는지 정리한 것이다.
커널에게는 모두 태스크다
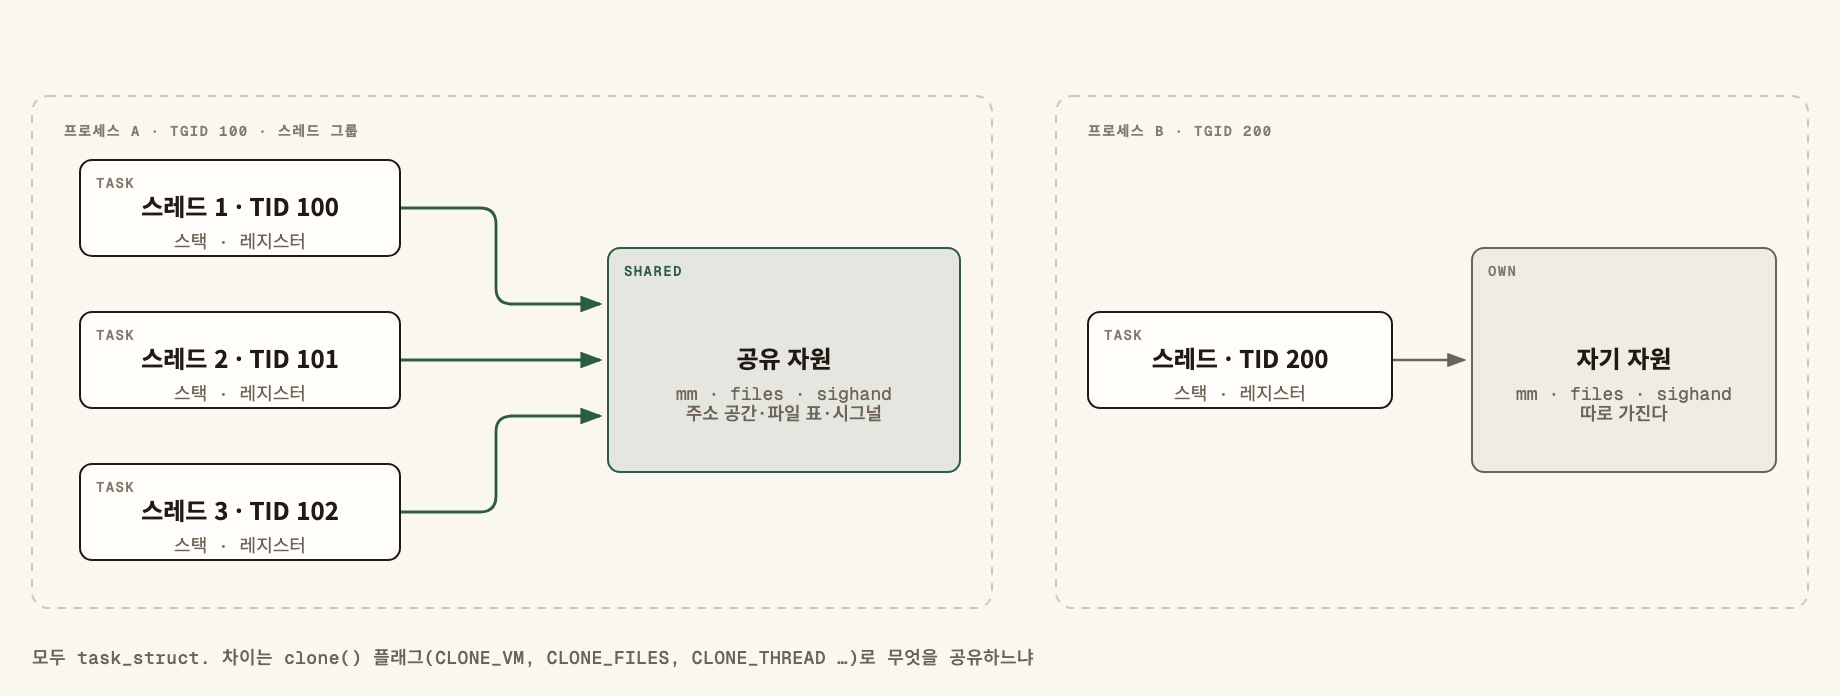
커널의 스케줄러는 "프로세스"를 스케줄하지 않는다. 실행 가능한 태스크(task_struct)를 고른다. 태스크마다 다음을 가진다.
- 자신만의 것: 태스크 ID(TID), 레지스터 상태, 커널 스택, 스케줄링 정보, 시그널 마스크
- 포인터로 가리키는 것: 주소 공간(
mm_struct), 열린 파일 표(files_struct), 파일 시스템 정보(fs_struct), 시그널 처리기(sighand_struct)
프로세스와 스레드의 차이는 이 포인터들이 다른 태스크와 같은 구조체를 가리키느냐다. 스레드는 주소 공간과 파일 표를 같은 프로세스의 다른 스레드와 공유하고, 새 프로세스는 자기 것을 따로 가진다.
만드는 방법은 clone 하나
프로세스와 스레드 모두 clone() 시스템 호출로 만든다. 무엇을 공유할지는 플래그로 정한다.
| 플래그 | 공유하는 것 |
|---|---|
CLONE_VM |
주소 공간(메모리) |
CLONE_FILES |
열린 파일 디스크립터 표 |
CLONE_FS |
현재 디렉터리, umask 등 |
CLONE_SIGHAND |
시그널 처리기 |
CLONE_THREAD |
같은 스레드 그룹으로 묶기(같은 PID로 보이게) |
fork()는 공유 플래그 없이 복제한다. 메모리는 바로 복사하지 않고 쓰기 시 복사(Copy-on-Write) 로 페이지 표만 복제해 두었다가, 어느 쪽이 쓰는 순간 그 페이지만 복사한다.pthread_create()(glibc의 NPTL)는 위 플래그를 모두 켜고clone()을 부른다. 사용자 스레드 하나가 커널 태스크 하나에 대응하는 1:1 모델이다.
PID와 TID: top에 보이는 숫자의 정체
같은 프로세스의 스레드들은 하나의 스레드 그룹이다. 그룹의 ID(TGID)가 우리가 아는 PID이고, 각 스레드는 자기 TID를 가진다. 첫 스레드의 TID는 PID와 같다.
cat /proc/<pid>/status | grep Threads   # 이 프로세스의 스레드 수
ls /proc/<pid>/task                     # 스레드(TID) 목록
ps -eLf | grep <pid>                     # LWP 열이 TID
top -H -p <pid>                          # 스레드별 CPU 사용
getpid()는 TGID를, gettid()는 TID를 돌려준다. Java 스레드 덤프의 nid는 이 TID의 16진수다. top -H로 CPU를 많이 쓰는 TID를 찾고 16진수로 바꿔 스레드 덤프에서 찾으면 어떤 Java 스레드인지 알 수 있다.
공유하면 무엇이 달라지나
| 항목 | 같은 프로세스의 스레드끼리 | 다른 프로세스끼리 |
|---|---|---|
| 메모리 | 같은 주소 공간. 변수 공유, 동기화 필요 | 분리. 공유하려면 공유 메모리·파이프·소켓 |
| 장애 격리 | 한 스레드의 잘못된 메모리 접근이 프로세스 전체를 죽인다 | 한 프로세스가 죽어도 다른 프로세스는 산다 |
| 컨텍스트 스위칭 | 주소 공간을 바꿀 필요가 없어 가볍다 | 주소 공간 전환(페이지 표 교체)이 더해진다 |
| 생성 비용 | 작다 | 쓰기 시 복사 덕분에 생각보다 작지만 스레드보다 크다 |
| 파일 디스크립터 | 공유. 한 스레드가 닫으면 모두에게 닫힌다 | 분리(fork 직후에는 복제본) |
메모리: 스레드마다 스택이 있다
스레드는 주소 공간을 공유하지만 스택은 각자 가진다. 스레드 수가 많으면 스택 예약 공간이 쌓인다.
- C 프로그램의 기본 스레드 스택 크기는 보통
ulimit -s값을 따른다. - Java 플랫폼 스레드의 스택은
-Xss로 정한다(64비트 Linux에서 흔히 1MB). 스레드 1,000개면 스택 예약만 약 1GB다. 실제로 쓰는 페이지만 물리 메모리를 차지하지만, 컨테이너 메모리 계산에는 넣어야 한다. - 스레드 수에는 커널 한도도 있다(
/proc/sys/kernel/threads-max, cgroup의pids.max). 컨테이너에서 "unable to create native thread"가 나면 메모리뿐 아니라 이 한도도 확인한다.
스케줄링: 스레드 단위로 경쟁한다
스케줄러는 태스크 단위로 CPU를 나눈다. 스레드가 100개인 프로세스는 스레드가 1개인 프로세스보다 CPU를 받을 기회가 많다. 그래서 컨테이너는 cgroup으로 CPU 사용량 한도를 그룹 단위로 건다.
- 실행 대기 시간은
/proc/<pid>/task/<tid>/schedstat이나pidstat -t -w(컨텍스트 스위치 수)로 본다. - 자발적 컨텍스트 스위치(I/O·락 대기)가 많으면 기다림이, 비자발적 스위치(시간 할당 소진)가 많으면 CPU 경쟁이 원인이다.
Java와 연결하기
- 플랫폼 스레드 = 커널 태스크 하나(1:1). 스레드 풀 크기가 곧 커널 태스크 수다.
- 가상 스레드(JDK 21): 많은 가상 스레드를 적은 수의 플랫폼 스레드(캐리어) 위에서 돌린다. 커널은 캐리어만 본다. 대기가 많은 I/O 작업에서 스레드 수와 스택 메모리 부담을 줄인다.
- OOM: 커널 OOM killer는 스레드가 아니라 프로세스(주소 공간을 공유하는 스레드 그룹 전체)를 죽인다. JVM 힙 OOM(
OutOfMemoryError)과 커널 OOM kill은 다른 사건이다. 컨테이너가 예고 없이 재시작됐다면dmesg나 컨테이너 이벤트에서 OOM kill을 확인한다.
자주 하는 실수
top의 프로세스 CPU만 본다. 어느 스레드가 쓰는지 모른다.top -H로 스레드 단위로 본다.- 스레드 수를 메모리 계산에서 뺀다. 스택과 스레드별 버퍼가 힙 밖에서 쌓인다.
- fork 뒤 스레드가 그대로 있다고 생각한다. 멀티스레드 프로세스에서
fork()하면 자식에는 호출한 스레드 하나만 복제된다. 다른 스레드가 잡고 있던 락은 풀리지 않은 채 남을 수 있다. - JVM OOM과 커널 OOM kill을 섞어 본다. 원인과 대응이 다르다.
- 컨테이너
pids.max를 모른다. 메모리가 남아도 스레드를 못 만든다.
점검표
- 프로세스·스레드가 커널에서 같은 태스크라는 전제로 지표를 읽는다
- CPU 문제는
top -H로 TID를 찾고 스레드 덤프nid와 맞춘다 - 스레드 수와 스택 크기(
-Xss)를 메모리 계산에 넣었다 - 컨테이너의
pids.max,threads-max를 확인했다 - 컨텍스트 스위치를 자발·비자발로 나눠 본다
- 커널 OOM kill 여부를 확인하는 방법을 알고 있다
- I/O 대기가 많은 서비스는 가상 스레드를 검토했다
커널에게 프로세스와 스레드는 같은 태스크이고, 차이는 무엇을 공유하느냐다. 공유가 많을수록 만들고 바꾸기는 가볍지만 서로의 실수에 함께 쓰러진다. 이 한 문장이 스레드 수, 메모리, CPU, 장애 격리 판단의 기준이 된다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.