라인 커버리지 90%는 테스트가 그 줄을 실행했다는 뜻일 뿐, 잘못된 결과를 잡아낸다는 뜻이 아니다. Mutation Testing은 코드에 일부러 작은 결함을 심고 테스트가 그 결함을 잡는지 세어서 테스트의 실제 검출력을 잰다. 이 글은 변이 연산자와 판정 방식, 실제 함수에 적용한 예시, PIT·Stryker 설정, 살아남은 변이체를 다루는 법과 CI에 넣는 순서를 정리한다.
한눈에 보기
| 용어 | 뜻 |
|---|---|
| 변이 연산자(mutator) | 코드를 바꾸는 규칙. <를 <=로, true를 false로 |
| 변이체(mutant) | 연산자를 한 군데 적용한 코드 사본 |
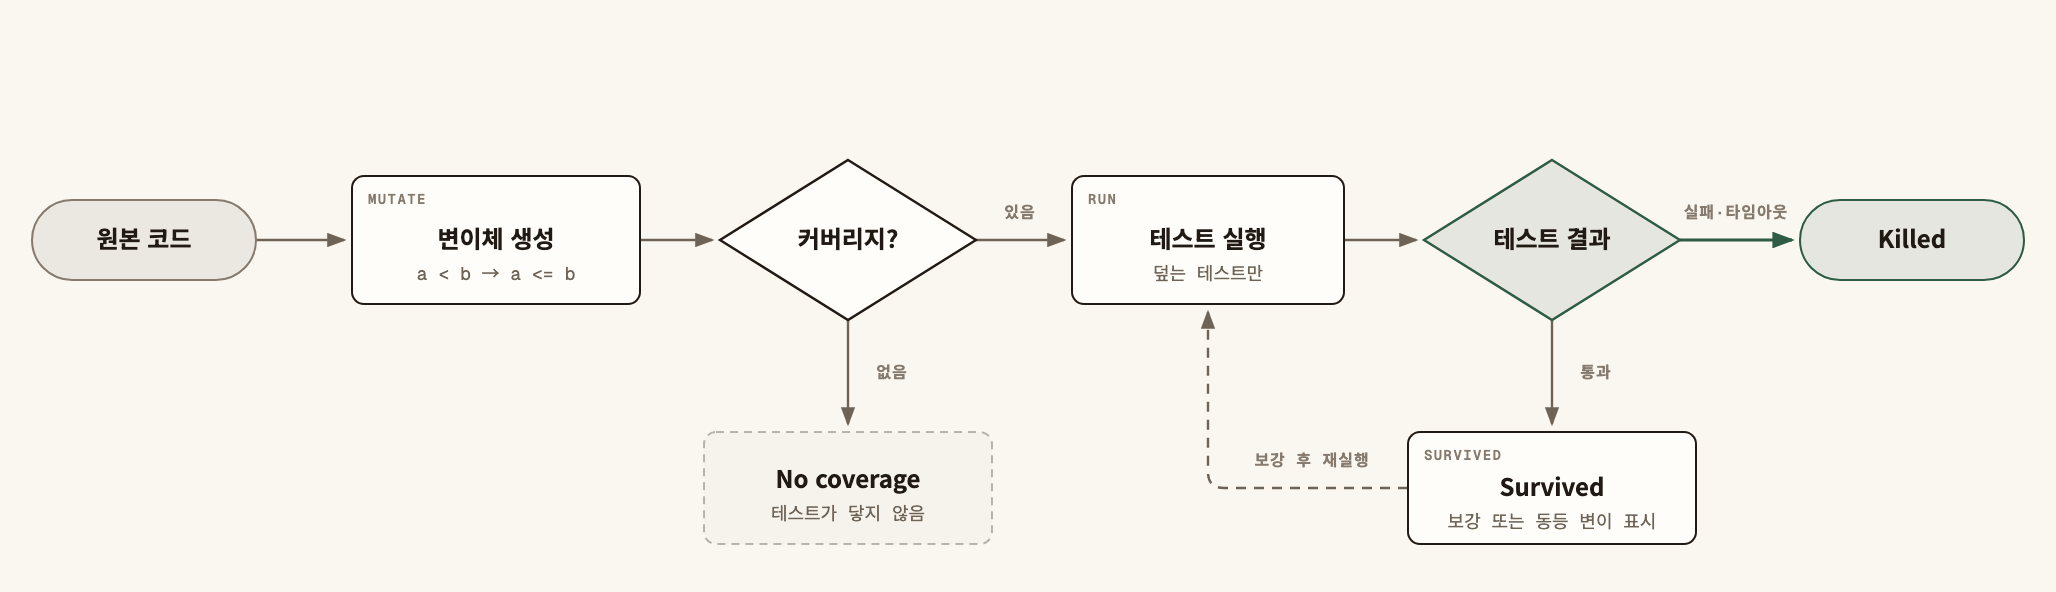
| Killed | 변이체에서 테스트가 하나라도 실패했다. 테스트가 결함을 잡았다 |
| Survived | 변이체에서도 테스트가 모두 통과했다. 테스트가 놓쳤다 |
| No coverage | 그 줄을 실행하는 테스트가 아예 없다 |
| Timeout | 변이로 무한 루프가 생겨 시간 안에 끝나지 않았다. 대개 잡은 것으로 센다 |
| Equivalent mutant | 코드는 바뀌었지만 동작이 같아 어떤 테스트로도 잡을 수 없는 변이체 |
커버리지가 높아도 테스트가 약한 이유
커버리지 도구는 실행된 줄을 센다. 검증문(assertion)이 무엇을 확인하는지는 보지 않는다.
it('할인 금액을 계산한다', () => {
  calcDiscount(10_000, 'VIP'); // 결과를 확인하지 않는다
});
이 테스트는 calcDiscount의 모든 줄을 실행하니 커버리지는 100%가 된다. 그러나 할인율을 0으로 바꿔도 통과한다. Mutation Testing은 바로 이 차이를 숫자로 드러낸다. 커버리지는 "테스트가 닿은 곳", mutation score는 "테스트가 지키는 곳"이다.
품질 지표를 커버리지 하나로 관리하면 숫자를 채우기 위한 테스트가 늘어난다. 지표를 고르는 기준은 AA 관점의 기술 부채 관리와 아키텍처 품질 지표에서 다뤘다.
변이 연산자와 점수 계산
도구마다 이름은 다르지만 기본 연산자는 비슷하다.
- 조건 경계:
a < b→a <= b. 경계값 테스트가 없으면 살아남는다. - 부정·조건 치환:
if (x)→if (!x),if (true),if (false). - 산술:
+→-,*→/. - 반환값:
return total→return 0,return obj→return null. - 호출 삭제: 반환값 없는 메서드 호출을 지운다. 부수 효과를 확인하지 않는 테스트를 드러낸다.
- 문자열·배열 리터럴:
'admin'→"",[a, b]→[].
점수는 대략 "잡힌 변이체 ÷ 판정 대상 변이체"다. 분모 정의는 도구마다 다르다. Stryker는 Killed와 Timeout을 "검출"로 묶고 컴파일 오류 변이체를 분모에서 뺀다. PIT 보고서는 전체 대비 비율(mutation coverage)과 테스트가 닿은 변이체만 대상으로 한 비율(test strength)을 따로 보여 준다. 도구를 바꾸거나 팀 사이에서 숫자를 비교할 때는 분모부터 맞춘다.
Equivalent mutant는 자동으로 걸러지지 않는다. 그래서 100점은 목표가 될 수 없고, 남은 변이체를 사람이 읽고 분류하는 시간이 꼭 필요하다.
실제 함수로 보는 예시
이 블로그는 Vitest로 순수 함수만 테스트한다. 글의 태그로 목록 구역을 정하는 src/lib/sections.ts의 sectionOf를 예로 든다. 아래는 Stryker를 이 파일에 적용한다면 어떤 변이체가 생기고 지금 테스트가 잡을지를 코드를 읽고 판단한 설계 예시다. 실제 실행 결과는 아니다.
export function sectionOf(tags: string | null | undefined): Section {
  const list = splitTags(tags);
  if (list.some((t) => LEARNING_TAGS.includes(t))) return 'learning';
  if (list.some((t) => NEWS_TAGS.includes(t))) return 'news';
  if (list.some((t) => TREND_TAGS.includes(t))) return 'trends';
  return 'articles';
}
| 변이 | 잡는 테스트 | 판정 예상 |
|---|---|---|
첫 if를 if (false)로 |
sectionOf('프롬프트')가 learning이어야 함 |
Killed |
첫 if를 if (true)로 |
sectionOf('레딧,주간정리')가 news이어야 함 |
Killed |
some을 every로 |
'개발기록, Claude Code'가 learning이어야 함 |
Killed |
return 'articles'를 return ""로 |
sectionOf('')가 articles이어야 함 |
Killed |
splitTags의 .filter(Boolean) 삭제 |
splitTags(' a, ,b ,')가 ['a','b']이어야 함 |
Killed |
LISTS의 설명 문구를 ""로 |
문구를 확인하는 테스트 없음 | Survived |
로직 변이는 모두 잡힐 것으로 보인다. "뉴스와 트렌드가 같이 있으면 뉴스", "학습 태그가 뉴스보다 우선" 같은 우선순위 테스트가 있어서다. 살아남는 것은 화면 설명 문구뿐이다. 이런 변이체는 테스트를 늘릴 대상이 아니라 검사 범위에서 뺄 대상이다.
도구별 설정
Java: PIT. Maven 플러그인으로 붙인다. JUnit 5는 별도 플러그인이 필요하다.
<plugin>
  <groupId>org.pitest</groupId>
  <artifactId>pitest-maven</artifactId>
  <version>${pitest.version}</version>
  <dependencies>
    <dependency>
      <groupId>org.pitest</groupId>
      <artifactId>pitest-junit5-plugin</artifactId>
      <version>${pitest-junit5.version}</version>
    </dependency>
  </dependencies>
  <configuration>
    <targetClasses><param>com.example.billing.*</param></targetClasses>
    <targetTests><param>com.example.billing.*Test</param></targetTests>
    <mutationThreshold>70</mutationThreshold>
    <withHistory>true</withHistory>
    <threads>4</threads>
  </configuration>
</plugin>
mvn test-compile org.pitest:pitest-maven:mutationCoverage로 실행한다. withHistory는 이전 결과를 저장해 바뀌지 않은 코드의 변이체를 다시 돌리지 않게 한다. mutationThreshold보다 점수가 낮으면 빌드가 실패한다.
JavaScript·TypeScript: Stryker. Vitest 프로젝트라면 npm i -D @stryker-mutator/core @stryker-mutator/vitest-runner로 설치하고 설정 파일을 둔다.
// stryker.config.mjs
export default {
  testRunner: 'vitest',
  mutate: ['src/lib/**/*.ts', '!src/lib/**/*.test.ts'],
  reporters: ['html', 'clear-text', 'progress'],
  incremental: true,
  thresholds: { high: 80, low: 60, break: 50 },
};
npx stryker run으로 실행한다. break보다 낮으면 종료 코드가 0이 아니다. 의미 없는 줄은 // Stryker disable next-line StringLiteral: 화면 문구 주석으로 이유를 남기고 뺀다.
Python: mutmut. mutmut run으로 돌리고 mutmut results로 살아남은 변이체를 본다. 설정 키는 버전마다 달라 공식 문서를 확인한다.
살아남은 변이체를 읽는 법
Survived가 나왔다고 바로 테스트를 추가하지 않는다. 먼저 네 가지 중 무엇인지 분류한다.
| 분류 | 판단 기준 | 조치 |
|---|---|---|
| 검증 누락 | 바뀐 동작이 사용자에게 보이는데 테스트가 결과를 안 본다 | 검증문 추가 |
| 경계값 누락 | <와 <= 차이를 가르는 입력이 없다 |
경계 입력 하나 추가 |
| 동등 변이 | 어떤 입력으로도 결과가 같다 | 비활성 주석과 이유 기록 |
| 의미 없는 코드 | 로그 문구, 화면 설명 | mutate 범위에서 제외 |
No coverage는 Survived보다 먼저 본다. 테스트가 아예 닿지 않는 코드라 검증문 문제가 아니라 테스트 자체가 없다는 뜻이다.
CI에 넣는 순서
Mutation Testing은 비싸다. 시간은 대략 "변이체 수 × 변이체마다 도는 테스트 시간"이다. 변이체 1,200개에 평균 0.8초면 16분이 걸린다(예시). 그래서 단계를 나눈다.
- 처음에는 보고만 한다. 핵심 도메인 패키지 하나를 대상으로 돌려 현재 점수를 기준선으로 남긴다.
- PR에서는 바뀐 코드만 돌린다. Stryker
incremental, PITwithHistory로 이전 결과를 재사용한다. - 전체 실행은 야간에 돌린다. 결과 보고서를 보관해 추세를 본다.
- 문턱은 기준선에서 시작해 올린다. 처음부터 80을 걸면 개발이 멈추고, 결국 문턱을 끄게 된다.
테스트가 비결정적이면 같은 변이체가 실행마다 Killed와 Survived를 오간다. 시간·난수·외부 호출을 고정하는 방법은 LLM 서비스의 비결정성과 재현 가능한 테스트 설계에 정리했다. 기준선과 비교해 병합을 막는 흐름은 AI Agent Eval 파이프라인과 회귀 테스트 자동화와 구조가 같다. 단위 테스트가 지키지 못하는 서비스 사이 약속은 Contract Testing으로 Frontend·Backend API 호환성 검증에서 다룬다.
자주 하는 실수
mutation score 100%를 목표로 잡는다. 동등 변이 때문에 도달할 수 없고, 점수를 맞추려고 구현 세부를 고정하는 테스트가 늘어난다.
전체 코드베이스를 한 번에 돌린다. 몇 시간짜리 작업이 되어 아무도 결과를 보지 않는다. 핵심 도메인부터 좁힌다.
Survived마다 테스트를 하나씩 붙인다. 같은 원인의 변이체 여러 개를 테스트 여러 개로 막으면 중복만 쌓인다. 원인 하나에 검증문 하나로 충분한 경우가 많다.
도구 간 점수를 그대로 비교한다. 분모 정의가 달라 같은 테스트도 숫자가 다르게 나온다.
비결정적 테스트를 그대로 둔다. 결과가 흔들려 문턱 실패를 아무도 믿지 않게 된다.
점검표
- 대상 범위(
targetClasses,mutate)가 핵심 도메인 코드로 좁혀져 있다 - 테스트 파일과 자동 생성 코드가 변이 대상에서 빠져 있다
- 현재 점수가 기준선으로 기록되어 있다
- 문턱(
mutationThreshold,thresholds.break)이 기준선 근처에서 시작한다 - PR 실행은 증분 분석으로 바뀐 코드만 돈다
- 전체 실행 보고서가 야간 작업 결과로 보관된다
- Survived를 검증 누락·경계값·동등 변이·의미 없는 코드로 분류했다
- 제외한 변이체에는 이유가 주석으로 남아 있다
- 같은 커밋에서 두 번 돌려 결과가 같다
Mutation Testing은 테스트를 늘리는 도구가 아니라 지금 있는 테스트가 실제로 무엇을 지키는지 확인하는 도구다. 좁은 범위에서 기준선을 잡고, 살아남은 변이체를 분류하고, 문턱을 조금씩 올리면 커버리지 숫자로는 보이지 않던 빈틈이 드러난다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.