공공 웹서비스의 파일 다운로드는 가장 단순해 보이는 기능이면서 개인정보 유출 사고가 가장 자주 나는 기능이다. 목록 화면에서는 권한을 확인했는데 다운로드 주소는 파일 번호만 바꾸면 남의 첨부가 내려받아지거나, 경로 문자열을 그대로 받아 서버의 다른 파일까지 읽히는 식이다. 이 글은 다운로드 요청 하나가 거쳐야 할 검증 단계와 저장 구조, 응답 헤더, 감사 기록까지 설계 기준을 정리한 것이다.
흔한 사고 네 가지
| 사고 | 어떻게 생기나 | 막는 방법 |
|---|---|---|
| 남의 파일 내려받기(IDOR) | download?fileId=1024의 번호만 바꿔 요청 |
다운로드 시점에 업무 권한을 다시 검사, 추측 불가능한 ID |
| 경로 조작 | download?path=../../conf/app.yml |
클라이언트에게 경로를 받지 않는다. ID → 서버 경로 매핑 |
| 웹 경로로 직접 접근 | 업로드 파일이 웹 루트 아래에 저장 | 웹 루트 밖 저장소, 애플리케이션만 읽기 |
| 영구 공개 링크 | 한 번 만든 링크가 계속 열림 | 짧은 만료 서명 URL 또는 매 요청 권한 검사 |
공통점은 목록 화면의 권한 검사를 다운로드에서 생략했다는 것이다. 다운로드 엔드포인트는 화면과 따로 호출될 수 있는 독립 API로 보고 처음부터 다시 검사한다.
저장 구조: 파일과 업무를 잇는 메타데이터
파일 자체가 아니라 파일 메타데이터가 권한 판단의 근거다.
| 컬럼 | 용도 |
|---|---|
file_id |
외부에 노출하는 ID. 순번이 아닌 UUID 같은 추측 불가능한 값 |
owner_type, owner_id |
어느 업무 건(예: 민원 신청 123)에 속한 파일인가 |
storage_key |
실제 저장 위치. 외부에 절대 노출하지 않는다 |
original_name, content_type, size |
응답 헤더용 |
visibility |
공개·기관 내부·당사자 한정 |
contains_pii |
개인정보 포함 여부(감사·사유 기록 대상) |
status, retention_until |
삭제·보존 기한 처리 |
순번 ID를 UUID로 바꾸는 것만으로는 부족하다. 추측이 어려워질 뿐, 링크가 유출되면 그대로 열린다. 권한 검사가 본체이고 ID는 보조 장치다.
다운로드 요청이 거치는 단계
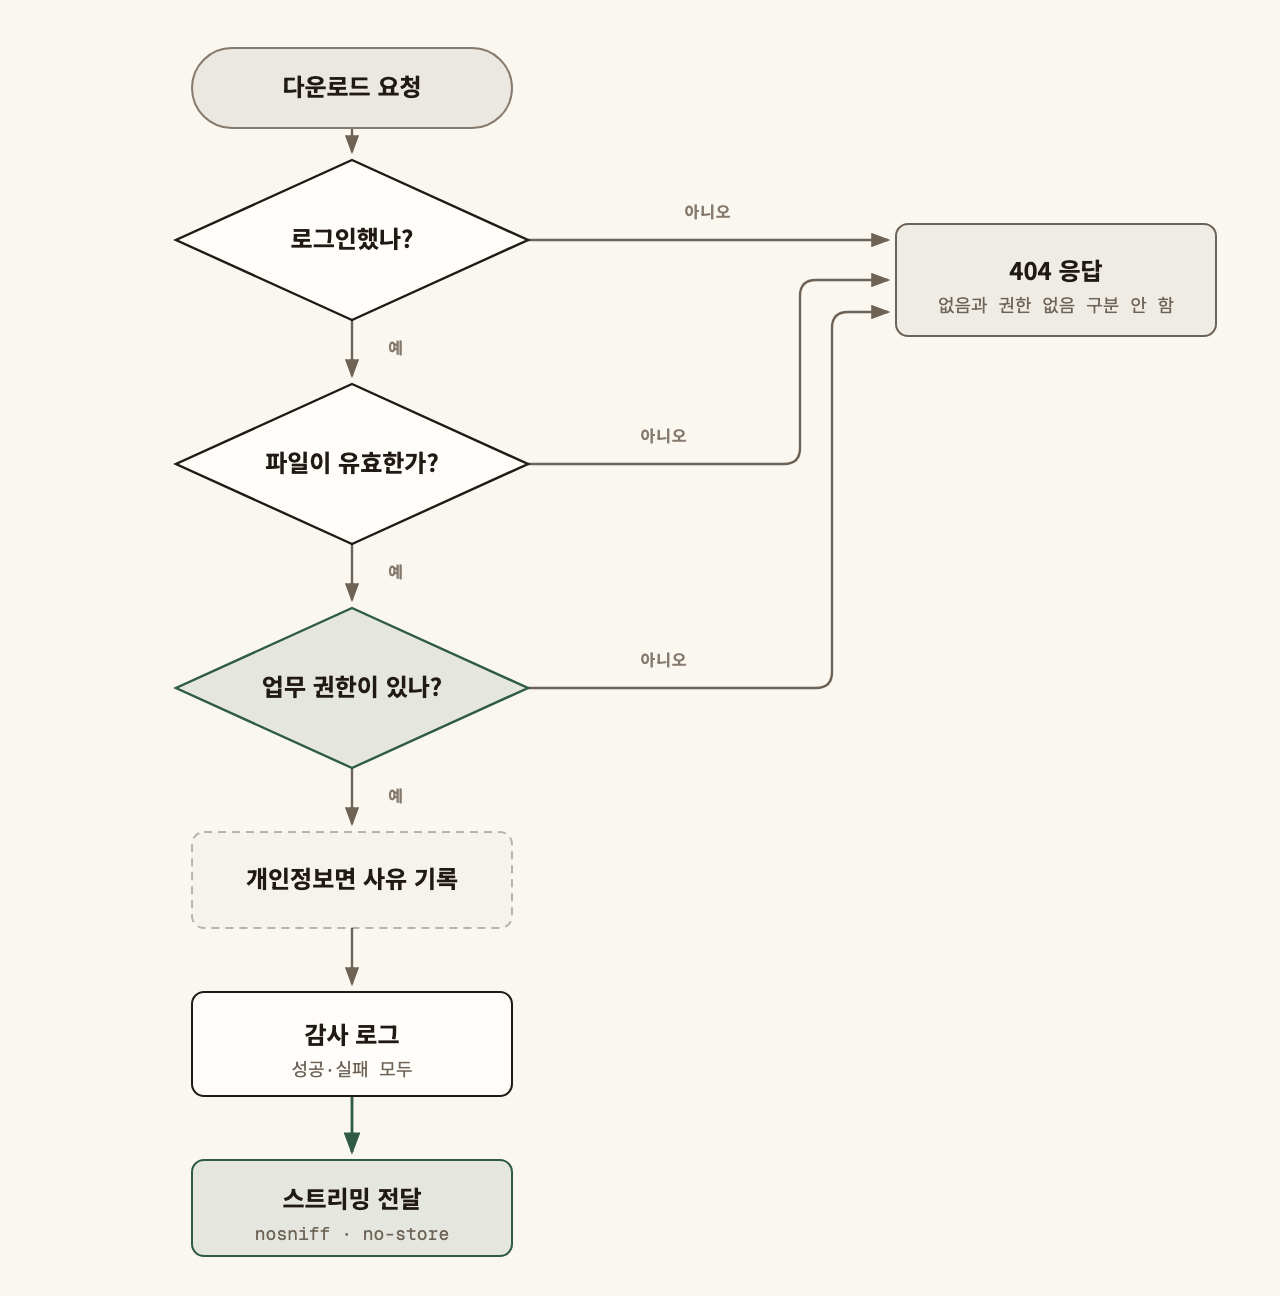
- 인증: 로그인 사용자인가. 공개 파일이 아니면 비로그인은 거절한다.
- 파일 확인:
file_id로 메타데이터를 찾고 삭제·보존 기한 만료 상태가 아닌지 본다. - 업무 권한: 파일이 속한 업무 건을 기준으로 판단한다. "민원 123의 신청인 본인이거나, 담당 부서 직원이거나, 권한 있는 관리자"처럼 업무 규칙으로 쓴다. 역할만 보고 통과시키지 않는다.
- 개인정보 파일: 기관 지침에 따라 다운로드 사유를 받거나 대량 다운로드를 제한한다.
- 감사 로그: 누가, 언제, 어떤 파일을, 어떤 IP에서, 성공·실패 여부를 기록한다.
- 전달: 서버가 저장소에서 읽어 스트리밍하거나, 수 분 안에 만료되는 서명 URL로 넘긴다.
권한이 없을 때는 403보다 404가 낫다. 403은 "그 파일이 존재한다"는 사실을 알려 준다.
구현 예시 (Spring Boot)
@GetMapping("/files/{fileId}")
public ResponseEntity<StreamingResponseBody> download(@PathVariable UUID fileId, Authentication auth) {
    FileMeta meta = fileService.findActive(fileId)
            .filter(m -> fileAccessPolicy.canRead(m, auth))   // 업무 권한: 소유 업무 건 기준
            .orElseThrow(NotFoundException::new);             // 없음과 권한 없음을 구분하지 않는다

    auditLog.recordDownload(meta, auth, requestIp());

    ContentDisposition disposition = ContentDisposition.attachment()
            .filename(meta.originalName(), StandardCharsets.UTF_8)   // 한글 파일명(filename*) 처리
            .build();
    return ResponseEntity.ok()
            .header(HttpHeaders.CONTENT_DISPOSITION, disposition.toString())
            .header("X-Content-Type-Options", "nosniff")
            .header(HttpHeaders.CACHE_CONTROL, "private, no-store")
            .contentType(MediaType.APPLICATION_OCTET_STREAM)
            .contentLength(meta.size())
            .body(out -> storage.copyTo(meta.storageKey(), out));   // 경로는 서버가 메타데이터로만 정한다
}
fileAccessPolicy.canRead는 다운로드뿐 아니라 목록·미리보기·삭제에서도 같은 함수를 쓴다. 권한 규칙이 화면마다 따로 구현되면 그중 하나가 반드시 빠진다.
응답 헤더
| 헤더 | 이유 |
|---|---|
Content-Disposition: attachment; filename*=UTF-8''… |
브라우저가 열지 않고 저장하게 하고, 한글 파일명을 깨지지 않게 |
X-Content-Type-Options: nosniff |
업로드된 HTML·스크립트를 브라우저가 내용 추측으로 실행하지 않게 |
Cache-Control: private, no-store |
공용 PC·중간 프록시에 개인 파일이 남지 않게 |
Content-Type: application/octet-stream |
업로드 때 받은 형식을 그대로 믿지 않는다 |
CDN이나 웹 서버 캐시를 쓰는 사이트라면 다운로드 경로는 캐시 대상에서 반드시 뺀다. 한 사람의 파일 응답이 다른 사람에게 캐시로 전달되는 사고가 실제로 생긴다.
업로드 단계에서 미리 막을 것
다운로드 보안의 절반은 업로드에서 정해진다.
- 확장자와 실제 파일 내용(시그니처)을 함께 검사하고 허용 목록만 받는다.
- 저장 파일명은 서버가 새로 만든다. 원래 이름은 메타데이터에만 둔다.
- 웹 루트 밖이나 비공개 객체 저장소에 둔다.
- 악성코드 검사를 거친 뒤에 다운로드 가능 상태로 바꾼다.
- 크기 제한과 사용자별 업로드 횟수 제한을 둔다.
감사와 모니터링
- 다운로드 로그는 성공뿐 아니라 실패(권한 없음, 없는 파일) 도 남긴다. 번호를 바꿔 가며 시도하는 패턴은 실패 로그에서 보인다.
- 짧은 시간에 한 사용자가 많은 파일을 내려받으면 알림을 보내고, 기관 기준에 따라 제한한다.
- 개인정보 파일의 다운로드 기록은 기관의 개인정보 접속기록 보관 기준에 맞춰 보존 기간과 위변조 방지를 정한다.
자주 하는 실수
- 목록에서만 권한을 검사한다. 다운로드 주소는 화면 없이도 호출된다.
- 경로나 파일명을 파라미터로 받는다. 경로 조작의 출발점이다.
- 역할만 보고 통과시킨다. "직원이면 다운로드 가능"은 다른 부서 민원까지 열어 준다.
- 권한 없음에 403을 준다. 파일 존재 여부가 새어 나간다.
- 다운로드 응답이 캐시된다. 공용 캐시를 거쳐 다른 사용자에게 전달될 수 있다.
점검표
- 외부 노출 ID는 추측 불가능하고, 저장 경로는 노출되지 않는다
- 다운로드 시점에 파일이 속한 업무 건 기준으로 권한을 다시 검사한다
- 권한 규칙 함수 하나를 목록·미리보기·다운로드·삭제가 함께 쓴다
- 권한 없음과 없는 파일은 똑같이 404로 응답한다
- 클라이언트에게 경로·파일명을 받지 않는다
-
Content-Disposition,nosniff,no-store헤더가 있다 - 다운로드 경로가 CDN·웹 서버 캐시에서 빠져 있다
- 업로드 시 확장자·시그니처·악성코드 검사를 한다
- 성공·실패 다운로드가 모두 감사 로그에 남는다
- 개인정보 파일은 사유 기록·대량 다운로드 제한 기준이 있다
파일 다운로드의 권한 검증은 "이 사람이 이 업무 건의 파일을 지금 볼 수 있는가"를 매 요청마다 묻는 일이다. 경로는 서버만 알고, 판단은 한 함수가 하고, 모든 시도는 기록에 남기면 가장 흔한 유출 경로가 닫힌다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.