수십만~수백만 건을 읽고 쓰는 야간 배치나 데이터 이관은 SQL보다 "몇 번 왕복하고 몇 번 커밋하느냐"가 시간을 정한다. 이 글은 읽는 쪽의 OFFSET 페이징·키셋 페이징·서버 커서와, 쓰는 쪽의 한 건씩 INSERT·JDBC 배치·벌크 로드를 같은 기준(왕복, 메모리, 커밋 단위, 재시작)으로 비교하고, DB와 드라이버마다 켜야 하는 설정을 정리한 것이다.
한눈에 보기
| 방식 | 왕복 횟수 | 앱 메모리 | 잘 맞는 곳 | 주의할 점 |
|---|---|---|---|---|
| OFFSET 페이징 | 페이지 수만큼 | 페이지 크기 | 화면 목록, 작은 표 | 뒤 페이지일수록 느려지고, 처리 중 데이터가 바뀌면 건너뛰거나 중복 |
| 키셋 페이징 | 페이지 수만큼 | 페이지 크기 | 대량 읽기 기본값 | 정렬 기준에 유일한 키와 인덱스가 필요 |
| 서버 커서·스트리밍 | 연결 하나로 계속 | fetchSize 만큼 | 한 번에 끝까지 읽는 배치 | 읽는 동안 연결과 트랜잭션을 오래 잡음 |
| 한 건씩 INSERT | 건수만큼 | 작음 | 수백 건 이하 | 100만 건이면 왕복 100만 번 |
| JDBC 배치 | 건수 ÷ 배치 크기 | 배치 크기 | 앱에서 가공해 넣는 대량 쓰기 | 드라이버 옵션 없이는 묶이지 않을 수 있음 |
| 벌크 로드 | 명령 한 번 | 파일·스트림 | 이관, 초기 적재 | 제약조건·트리거·권한·보안 설정 확인 |
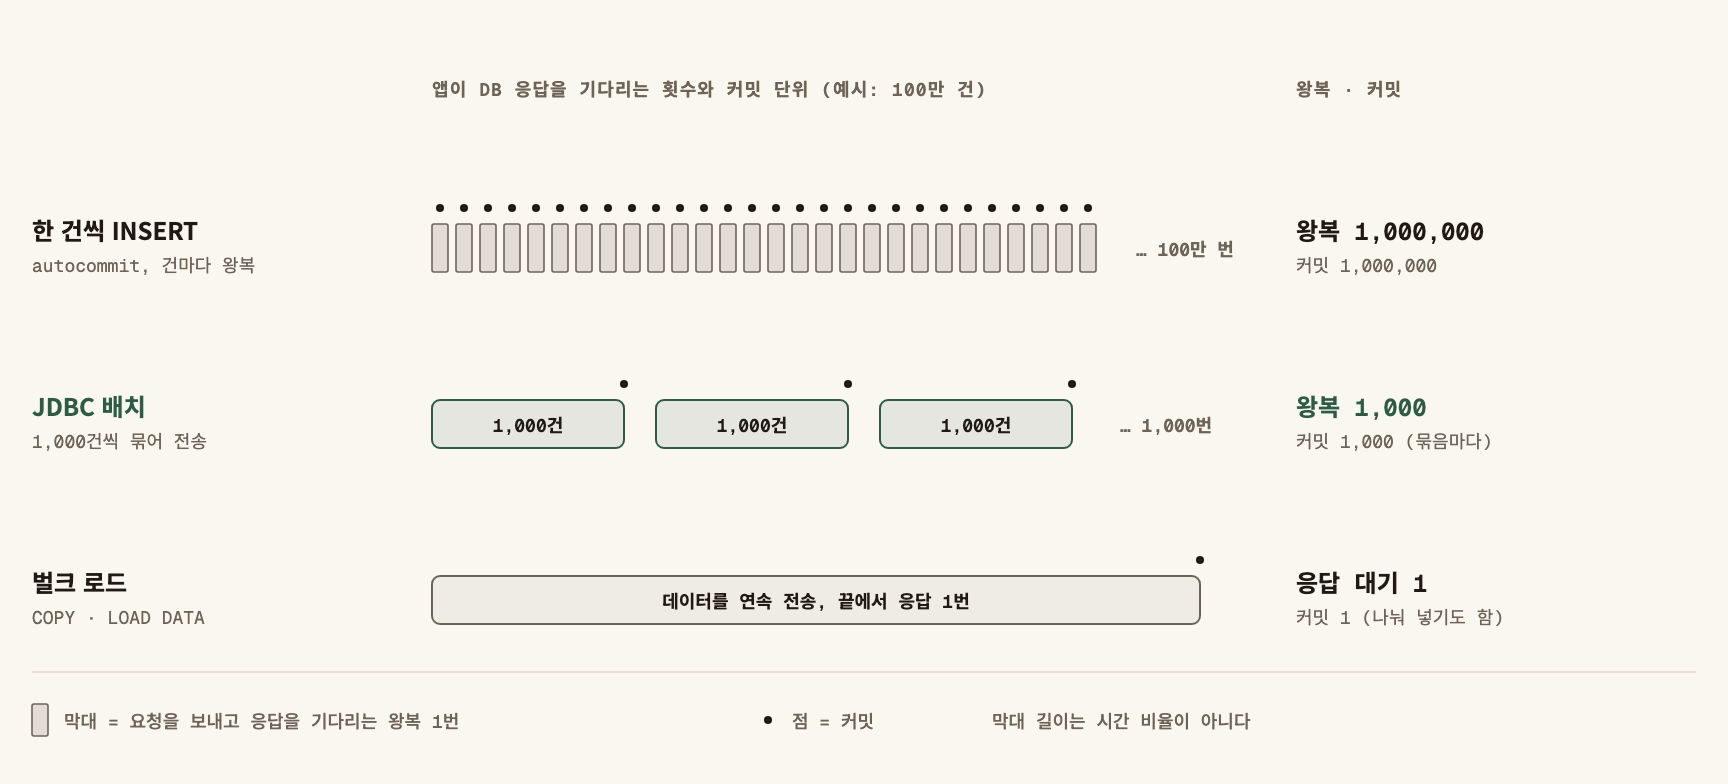
예시로 앱과 DB 사이 왕복이 1ms라면 100만 건을 한 건씩 넣을 때 네트워크 대기만 1,000초(약 16분 40초)다. 1,000건씩 배치로 묶으면 왕복이 1,000번, 대기는 약 1초로 줄어든다. DB가 쓰는 시간이 더해지므로 이 계산은 하한이다.
읽기 1: OFFSET 대신 키셋 페이징
LIMIT 1000 OFFSET 900000은 앞의 90만 건을 읽고 버린 뒤 1,000건을 돌려준다. 첫 페이지는 빠르지만 마지막 페이지는 표 전체를 훑는 것과 비슷해진다. 처리 중에 앞쪽 행이 지워지거나 추가되면 페이지 경계가 밀려 행을 건너뛰거나 두 번 읽는다.
키셋 페이징은 마지막으로 읽은 키부터 다시 시작한다.
-- 첫 페이지
SELECT id, member_id, amount FROM settlement
 WHERE settle_date = :d
 ORDER BY id
 LIMIT 1000;

-- 다음 페이지: 직전 페이지의 마지막 id 를 넘긴다
SELECT id, member_id, amount FROM settlement
 WHERE settle_date = :d AND id > :lastId
 ORDER BY id
 LIMIT 1000;
- 정렬 열은 유일해야 한다.
created_at처럼 같은 값이 여러 개면(created_at, id)처럼 유일한 열을 덧붙인다. (settle_date, id)인덱스가 있어야 매 페이지가 인덱스 범위 검색으로 끝난다. 없으면 페이지마다 정렬이 일어난다.- 마지막 키를 저장해 두면 실패한 뒤 그 지점부터 다시 시작할 수 있다. 재시작이 공짜로 따라온다.
Spring Batch의 JdbcPagingItemReader는 정렬 키(sortKey)를 받아 두 번째 페이지부터 "마지막 키보다 큰 행"을 읽는 방식으로 쿼리를 만든다. 반면 JPA의 setFirstResult를 쓰는 리더는 OFFSET 방식이므로 큰 표에서는 생성 SQL을 확인한다.
읽기 2: 서버 커서와 fetchSize
한 번 열어 끝까지 읽는 배치라면 커서가 가장 단순하다. 쿼리는 한 번, 행은 fetchSize만큼씩 나눠 받는다. 함정은 드라이버마다 기본 동작이 다르다는 점이다. setFetchSize를 불렀는데도 결과 전체가 앱 메모리에 올라와 OutOfMemoryError가 나는 일이 흔하다.
| DB·드라이버 | 기본 동작 | 나눠 받으려면 |
|---|---|---|
| MySQL Connector/J | 결과 전체를 메모리에 읽음 | useCursorFetch=true + 양수 fetchSize(서버 커서), 또는 fetchSize = Integer.MIN_VALUE + 전진 전용·읽기 전용(한 행씩 스트리밍) |
| PostgreSQL JDBC | 결과 전체를 메모리에 읽음 | autocommit 끄기 + 전진 전용 ResultSet + fetchSize 지정 |
| Oracle JDBC | 기본 10행씩 가져옴 | fetchSize를 수백~수천으로 올려 왕복을 줄임 |
MySQL 스트리밍 방식은 결과를 다 읽거나 닫기 전까지 같은 연결로 다른 쿼리를 보낼 수 없다. 읽으면서 같은 연결로 INSERT를 하려는 코드는 여기서 실패한다. 읽기와 쓰기 연결을 나누거나 서버 커서 방식을 쓴다. 옵션 이름과 조건은 쓰는 드라이버 버전의 문서를 확인한다.
MyBatis에서는 반환 타입을 Cursor<T>로 두거나 ResultHandler를 쓰고, <select>에 fetchSize를 준다.
@Transactional(readOnly = true)   // 커서를 다 읽을 때까지 세션과 연결이 열려 있어야 한다
public void export(LocalDate d, Consumer<Settlement> sink) {
    try (Cursor<Settlement> cursor = mapper.streamByDate(d)) {
        cursor.forEach(sink);
    }
}
커서의 대가는 시간이다. 처리하는 내내 연결과 트랜잭션이 열려 있어 커넥션 풀에서 한 자리가 빠지고, DB에 따라 오래된 읽기 시점을 유지하느라 언두나 버전 정리가 밀린다. Spring Batch JdbcCursorItemReader도 스텝 내내 연결 하나를 잡는다. 오래 걸리고 중간 재시작이 중요한 작업은 키셋 페이징이 더 다루기 쉽다.
쓰기 1: 한 건씩 INSERT에서 JDBC 배치로
addBatch로 쌓았다가 executeBatch로 한 번에 보낸다. 묶음마다 커밋하고, 쌓인 객체는 비운다.
conn.setAutoCommit(false);
try (PreparedStatement ps = conn.prepareStatement(
        "INSERT INTO settlement_result (settle_id, amount, status) VALUES (?, ?, ?)")) {
    int n = 0;
    for (Result r : results) {
        ps.setLong(1, r.settleId());
        ps.setBigDecimal(2, r.amount());
        ps.setString(3, r.status());
        ps.addBatch();
        if (++n % 1000 == 0) {
            ps.executeBatch();
            conn.commit();
        }
    }
    ps.executeBatch();   // 남은 건
    conn.commit();
}
코드만 배치로 바꾸면 끝나지 않는다. 드라이버가 실제로 묶어 보내는지 확인해야 한다.
- MySQL Connector/J:
rewriteBatchedStatements=true를 켜야 배치 INSERT가 다중 VALUES 문으로 다시 쓰인다. 끄면 문장을 하나씩 보내 왕복이 거의 줄지 않는다. 켜면executeBatch가 돌려주는 건수가 건별 값이 아닐 수 있으므로 반환값으로 성공 건수를 세는 코드는 확인한다. - PostgreSQL JDBC:
reWriteBatchedInserts=true를 켜면 INSERT 배치를 다중 VALUES로 묶는다. - 배치 크기는 500~1,000건에서 시작해 직접 재어 보고 정한다. 너무 크면 한 묶음의 패킷이 커지고(MySQL
max_allowed_packet), 실패했을 때 다시 할 양이 커진다.
JdbcTemplate.batchUpdate, MyBatis ExecutorType.BATCH도 같은 JDBC 배치라 위 옵션이 똑같이 필요하다.
쓰기 2: JPA 배치와 다중 VALUES
JPA로 대량 INSERT를 하면 세 가지가 동시에 맞아야 묶인다.
spring:
  jpa:
    properties:
      hibernate:
        jdbc.batch_size: 1000
        order_inserts: true     # 같은 테이블 INSERT 를 모아 배치가 끊기지 않게
        order_updates: true
- ID 전략:
GenerationType.IDENTITY면 Hibernate가 INSERT마다 생성된 키를 받아야 해서 INSERT 배치를 하지 않는다. 시퀀스 전략(필요하면allocationSize로 번호를 미리 받음)이나 앱에서 만든 키를 쓴다. - flush·clear:
batch_size마다entityManager.flush()와clear()를 부른다. 안 부르면 영속성 컨텍스트에 100만 개 엔티티가 쌓여 메모리와 변경 감지 비용이 함께 커진다.
다중 VALUES 문을 직접 만들어도 왕복은 줄지만, 문장 길이와 바인드 변수 개수에 상한이 있어 행 수를 나눠야 한다. 드라이버 옵션으로 배치를 다시 쓰게 하는 쪽이 단순하다.
쓰기 3: 벌크 로드
이관이나 초기 적재처럼 가공이 거의 없는 대량 쓰기는 DB의 전용 적재 기능이 가장 빠르다. SQL 문장 단위가 아니라 데이터 흐름으로 받아들이기 때문이다.
| DB | 기능 | 확인할 것 |
|---|---|---|
| PostgreSQL | COPY ... FROM STDIN (JDBC는 CopyManager) |
한 행이라도 형식 오류면 그 COPY 전체가 실패 |
| MySQL | LOAD DATA [LOCAL] INFILE |
LOCAL은 서버 local_infile과 클라이언트 설정을 둘 다 켜야 하며, 켜면 파일 읽기 권한이 넓어진다 |
| Oracle | SQL*Loader 직접 경로, INSERT /*+ APPEND */ |
직접 경로 적재는 대상 테이블을 배타적으로 잡고, 로그를 줄였다면 적재 뒤 백업 필요 |
벌크 로드 전에 정할 것이 있다.
- 인덱스·제약조건: 큰 표에 처음 적재할 때는 보조 인덱스를 나중에 만드는 편이 빠른 경우가 많다. 다만 운영 중인 표에서는 지우지 않는다.
- 트리거: 적재 방식에 따라 트리거가 돌지 않을 수 있다. 업무 규칙이 트리거에 있다면 먼저 확인한다.
- 오류 행 처리: 잘못된 행을 버릴지, 별도 파일로 뺄지, 전체를 멈출지 정한다.
커밋 간격과 재시작
배치 속도와 안전은 커밋 간격에서 갈린다.
- 너무 잦은 커밋: 커밋마다 DB가 로그를 디스크에 확정한다. 건마다 커밋하면 이 대기가 100만 번 생긴다.
- 너무 드문 커밋: 100만 건을 한 트랜잭션에 넣으면 언두·리두와 락이 그만큼 쌓인다. 중간에 실패하면 롤백도 그만큼 걸리고, 그동안 같은 행을 쓰려는 온라인 거래가 기다린다.
- 시작점: 1,000~10,000건마다 커밋하고, 락 대기와 언두 사용량을 보며 조정한다.
커밋을 나누면 "절반만 들어간 상태"가 생긴다. 그래서 재시작 방법을 같이 설계한다.
| 장치 | 하는 일 | 없으면 생기는 일 |
|---|---|---|
| 마지막 처리 키 기록 | 실패한 지점부터 다시 읽음 | 처음부터 다시 돌려 시간이 두 배 |
| 멱등한 쓰기(유일 키 + UPSERT) | 같은 행을 두 번 넣어도 결과가 같음 | 재시작 때 중복 행 |
| 처리 상태 열·작업 이력 표 | 묶음별 성공·실패를 남김 | 어디까지 됐는지 아무도 모름 |
| 스테이징 표 후 교체 | 다 넣은 뒤 한 번에 반영 | 적재 중간 상태가 화면에 보임 |
Spring Batch에서는 청크(chunk(1000))가 커밋 단위이고, 메타 테이블 기록으로 실패한 스텝을 이어서 실행한다.
자주 하는 실수
- fetchSize만 넣고 스트리밍이라고 믿는다. MySQL·PostgreSQL 드라이버는 조건이 맞지 않으면 결과 전체를 메모리에 올린다.
- 배치 코드를 쓰고 드라이버 옵션을 안 켠다.
rewriteBatchedStatements없이 MySQL에 배치를 보내면 왕복이 거의 줄지 않는다. - IDENTITY 키로 JPA 배치를 기대한다. INSERT 배치가 꺼져 있어 한 건씩 나간다.
- 100만 건을 한 트랜잭션에 넣는다. 실패 한 번에 전체 롤백과 긴 락 대기가 따라온다.
- OFFSET으로 바뀌는 표를 끝까지 읽는다. 느려지는 것보다 행을 건너뛰는 쪽이 더 위험하다. 결과가 틀려도 아무 오류가 나지 않는다.
점검표
- 대량 읽기에 OFFSET이 아니라 키셋 페이징이나 커서를 쓴다
- 키셋 정렬 열이 유일하고, 조건과 정렬을 덮는 인덱스가 있다
- 커서 사용 시 드라이버별 스트리밍 조건(autocommit, ResultSet 종류, 옵션)을 확인했다
- 커서를 읽는 동안 같은 연결로 다른 쿼리를 보내지 않는다
- MySQL은
rewriteBatchedStatements, PostgreSQL은reWriteBatchedInserts설정을 정했다 - JPA 대량 INSERT는 IDENTITY가 아닌 키 전략과
flush·clear를 쓴다 - 실제로 묶음이 나가는지 SQL·드라이버 로그로 확인했다
- 커밋 간격을 정했고 락 대기·언두 사용량을 보며 조정했다
- 실패하면 어디서부터 다시 시작하는지, 중복 행을 어떻게 막는지 정했다
- 벌크 로드 전에 트리거·제약조건·오류 행 처리와 보안 설정을 확인했다
대량 처리는 SQL을 빠르게 만드는 문제가 아니라 왕복을 줄이고, 메모리를 일정하게 두고, 커밋을 적당히 나눈 뒤, 실패해도 이어서 돌 수 있게 만드는 문제다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.