국내 SI에서 MyBatis와 JPA는 "어느 쪽이 더 빠른가"로 자주 논쟁이 되지만, 실제 성능 차이는 도구보다 쓰는 방법에서 나온다. JPA는 잘못 쓰면 쿼리가 폭증하고, MyBatis는 잘 쓰면 빠르지만 스키마가 바뀔 때마다 고칠 곳이 늘어난다. 이 글은 두 기술을 성능과 유지보수 두 축으로 비교하고, 하나를 고르거나 함께 쓸 때의 기준을 정리한 것이다.
한눈에 비교
| 기준 | MyBatis | JPA(Hibernate) |
|---|---|---|
| 기본 생각 | SQL을 직접 쓰고 결과를 객체에 매핑 | 객체를 다루면 SQL이 만들어진다 |
| SQL 통제 | 완전 | 생성 SQL을 확인·조정해야 함 |
| 단순 CRUD 생산성 | 매번 SQL 작성 | 매우 높음(Spring Data JPA) |
| 복잡한 조회·통계 | 강함 | JPQL·QueryDSL로 가능하나 한계 있음 |
| 대표 성능 함정 | 비효율 SQL, 수동 매핑 누락 | N+1, 불필요한 변경 감지, 대량 처리 |
| 스키마 변경 영향 | XML·매퍼 여러 곳 수정 | 엔티티 수정, 타입 검사로 잡힘 |
| 학습 비용 | 낮음(SQL을 알면 됨) | 높음(영속성 컨텍스트, 지연 로딩) |
| DBA 협업 | SQL을 그대로 검토 | 생성 SQL 로그를 봐야 함 |
성능 1: JPA의 N+1과 해법
JPA 성능 문제의 대부분은 N+1이다. 주문 100건을 조회한 뒤 각 주문의 회원을 지연 로딩으로 읽으면 쿼리가 1 + 100번 나간다. 개발 환경 데이터 10건에서는 보이지 않다가 운영에서 터진다.
- 페치 조인:
join fetch로 한 번에 가져온다. 컬렉션 페치 조인은 페이징과 함께 쓰면 메모리에서 페이징하므로 피한다. @EntityGraph: 리포지토리 메서드에 어떤 연관을 함께 읽을지 선언한다.- 배치 크기:
spring.jpa.properties.hibernate.default_batch_fetch_size를 설정하면 지연 로딩을IN절로 묶어 N+1을 1+1 수준으로 줄인다. - DTO 조회: 화면에 필요한 열만 골라 바로 DTO로 받는다. 엔티티 전체를 읽고 버리는 낭비가 없다.
검증 방법은 단순하다. 개발 중에는 SQL 로그를 켜고, 테스트에서 주요 API 한 번에 나가는 쿼리 수를 세어 기준을 넘으면 실패하게 만든다.
성능 2: 대량 처리
| 상황 | MyBatis | JPA |
|---|---|---|
| 대량 INSERT | ExecutorType.BATCH나 다중 VALUES로 효율적 |
ID 전략이 IDENTITY면 Hibernate가 JDBC 배치 INSERT를 하지 못한다. 시퀀스 전략 + hibernate.jdbc.batch_size 필요 |
| 대량 UPDATE·DELETE | SQL 한 번 | @Modifying 벌크 쿼리. 영속성 컨텍스트를 거치지 않으므로 실행 뒤 비워야 한다 |
| 대량 조회 후 처리 | 커서·ResultHandler로 한 건씩 |
페이지 단위로 읽고 영속성 컨텍스트를 주기적으로 clear |
야간 배치, 정산, 데이터 이관처럼 수십만 건을 다루는 작업은 JPA 엔티티로 하나씩 처리하면 1차 캐시가 커지고 변경 감지 비용이 쌓인다. 이런 작업은 SQL 중심(MyBatis, JdbcTemplate)으로 쓰는 편이 낫다.
성능 3: MyBatis의 함정
MyBatis라고 자동으로 빠르지는 않다.
- 동적 SQL이 실행 계획을 흔든다.
<if>가 많은 쿼리는 조건 조합마다 다른 SQL이 되어, 실행 계획을 검토한 조합과 운영에서 도는 조합이 다를 수 있다. ${}사용. 문자열 치환이라 SQL 인젝션 위험이 있고, 바인딩 변수가 아니어서 DB의 실행 계획 캐시도 잘 쓰지 못한다. 정렬 컬럼처럼 꼭 필요하면 허용 목록으로 검증한다.- N+1은 MyBatis에도 있다.
resultMap의 중첩select로 연관을 읽으면 같은 문제가 생긴다. 조인으로 한 번에 읽고 중첩resultMap으로 매핑한다.
유지보수: 변경이 어디까지 번지나
컬럼 이름 하나를 바꾸는 상황을 생각해 보면 차이가 분명하다.
- MyBatis: 그 컬럼을 쓰는 매퍼 XML을 검색해 모두 고친다. 문자열이라 컴파일러가 잡아 주지 않고, 테스트가 없는 쿼리는 운영에서 발견된다.
- JPA: 엔티티 필드 매핑 한 곳을 고친다. JPQL 문자열은 여전히 위험하지만 QueryDSL을 쓰면 컴파일 단계에서 잡힌다.
반대로 화면별로 조건과 정렬이 복잡한 조회, 여러 테이블을 묶은 통계, DB 고유 함수(분석 함수, 계층 쿼리)를 쓰는 SQL은 MyBatis가 읽기도 고치기도 쉽다. JPA로 억지로 표현하면 오히려 유지보수가 어려워진다.
함께 쓰기: 명령은 JPA, 복잡한 조회는 MyBatis
한 프로젝트에서 둘을 섞는 구성도 흔하다. 도메인 저장·수정은 JPA로, 목록·통계 조회는 MyBatis로 나눈다.
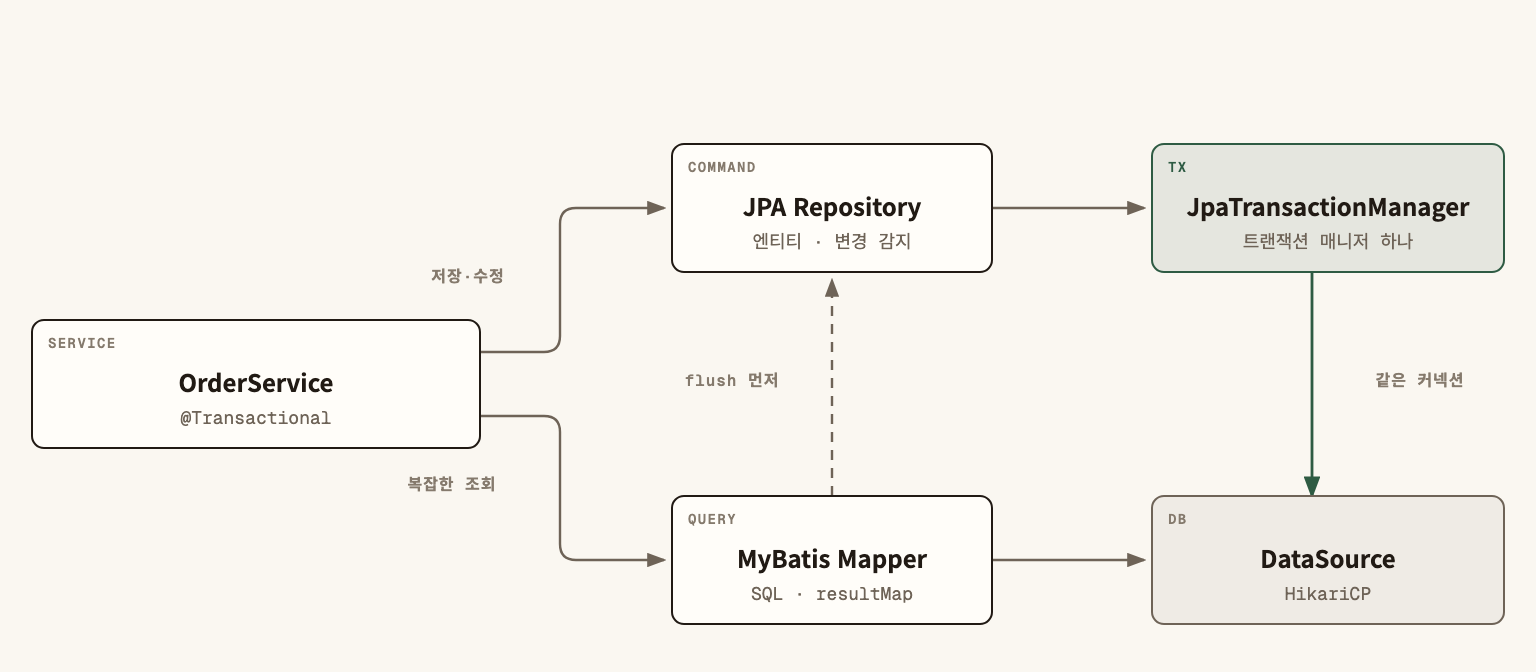
함께 쓸 때 지킬 것:
- 트랜잭션 매니저는 하나.
JpaTransactionManager하나로 두면 MyBatis(SqlSessionTemplate)도 같은 커넥션과 트랜잭션에 참여한다. - 조회 전에 flush. JPA는 변경을 커밋 직전까지 모아 둔다. 같은 트랜잭션에서 방금 저장한 데이터를 MyBatis로 읽으려면 먼저
entityManager.flush()를 호출해야 보인다. - MyBatis로 쓰기를 하지 않는다. MyBatis로 수정한 행은 JPA 영속성 컨텍스트가 모른다. 같은 엔티티를 다시 읽으면 옛 값이 나온다. 쓰기 경로는 한쪽으로 통일한다.
어떻게 고를까
| 상황 | 추천 |
|---|---|
| 도메인 규칙이 많고 CRUD 비중이 큰 신규 시스템 | JPA (+ QueryDSL) |
| 기존 DB·SQL 자산이 많고 DBA가 SQL을 검토하는 사업 | MyBatis |
| 조회·통계가 복잡하고 쓰기는 단순 | JPA 쓰기 + MyBatis 조회 |
| 대량 배치·정산·이관 | SQL 중심(MyBatis, JdbcTemplate) |
| 팀이 JPA 경험이 거의 없고 일정이 짧다 | MyBatis로 시작, 핵심 도메인만 단계적으로 |
JPA를 고르는 근거가 "생산성"이라면, 그 생산성은 N+1과 영속성 컨텍스트를 이해한 팀에서만 나온다는 점을 함께 적어 둔다. 이 결정은 ADR로 남긴다.
자주 하는 실수
- JPA에서 SQL 로그를 보지 않는다. N+1이 운영 데이터에서야 드러난다.
- JPA로 대량 배치를 엔티티 단위로 돌린다. 메모리와 시간이 함께 늘어난다.
- MyBatis에서
${}를 편하게 쓴다. 인젝션 위험과 실행 계획 낭비가 같이 온다. - 둘을 섞으면서 트랜잭션 매니저를 두 개 둔다. 한 유스케이스가 두 트랜잭션으로 갈라진다.
- 같은 테이블을 양쪽에서 쓴다. 영속성 컨텍스트와 DB 상태가 어긋난다.
점검표
- 선택 근거(팀 경험, 조회 복잡도, 배치 비중)를 ADR로 남겼다
- JPA는 SQL 로그와 API별 쿼리 수 검사를 켰다
- N+1 대응(페치 조인,
@EntityGraph, 배치 크기)을 개발 표준에 적었다 - 대량 INSERT가 있으면 ID 전략과 배치 설정을 확인했다
- MyBatis
${}는 허용 목록 검증이 있는 곳에만 있다 - 동적 SQL의 주요 조합은 실행 계획을 확인했다
- 함께 쓰면 트랜잭션 매니저는 하나이고, 쓰기 경로는 한쪽이다
- 같은 트랜잭션에서 JPA 저장 뒤 MyBatis로 읽을 때 flush한다
MyBatis와 JPA는 빠르고 느린 도구가 아니라 통제와 추상화의 교환이다. 팀이 감당할 수 있는 쪽을 고르고, 그 도구의 대표 함정을 개발 표준과 테스트로 막아 두면 어느 쪽이든 충분히 빠르다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.