서버가 두 대 이상이 되면 synchronized나 프로세스 안의 뮤텍스로는 "한 번에 하나만" 실행되는 것을 보장할 수 없다. 이 글은 분산 락을 Redis, 관계형 DB, ZooKeeper·etcd로 구현하는 방법을 비교하고, 락이 만료된 뒤에도 데이터를 지키는 펜싱 토큰까지 포함해 무엇을 언제 골라야 하는지 정리한 것이다.
한눈에 보기
| 구현 | 락의 실체 | 보유자가 죽으면 | 단조 증가 토큰 | 맞는 용도 |
|---|---|---|---|---|
| Redis 단일 노드 | TTL 붙은 키 | TTL이 지나면 풀림 | 없음(직접 만들어야 함) | 효율용 |
| Redlock | 과반 노드의 TTL 키 | TTL이 지나면 풀림 | 없음 | 효율용, 정확성용은 논쟁 중 |
| DB 행 락·advisory lock | 트랜잭션·세션이 잡은 락 | 연결이 끊기면 풀림 | 시퀀스로 만들 수 있음 | 이미 그 DB에 쓰는 작업 |
| ZooKeeper | 임시 순차 노드 | 세션 만료 시 노드 삭제 | 노드 순번, zxid | 정확성용 |
| etcd | lease 붙은 키 | lease 만료 시 키 삭제 | 키의 revision | 정확성용 |
먼저 정할 것: 효율용인가 정확성용인가
락을 고르기 전에 "락이 두 명에게 동시에 잡히면 무슨 일이 생기는가"를 답해야 한다. Martin Kleppmann은 이 구분을 효율(efficiency)과 정확성(correctness)으로 나눴다.
- 효율용 락: 같은 일을 두 번 하지 않으려는 락이다. 매시 정각 집계 배치, 캐시 재생성이 여기 든다. 드물게 두 번 돌면 비용이 조금 늘 뿐이다.
- 정확성용 락: 두 번 실행되면 데이터가 틀어지는 락이다. 재고 차감, 잔액 이체, 파일 덮어쓰기가 여기 든다.
효율용이면 Redis 단일 노드로 충분하다. 정확성용이면 락만 믿지 말고 저장소 쪽 검증(펜싱 토큰, 조건부 갱신, 유니크 제약)을 함께 둔다. 어떤 락도 "보유자가 멈춘 사이 만료"를 완전히 막지 못하기 때문이다.
Redis 단일 노드: SET NX PX와 안전한 해제
가장 흔한 구현은 키 하나를 원자적으로 만드는 것이다.
SET lock:order:1001 8f3c2a91-uuid NX PX 30000
NX: 키가 없을 때만 만든다. 이미 있으면nil이 돌아오고 획득 실패다.PX 30000: 30초 뒤 자동 삭제된다. 보유자가 죽어도 락이 영원히 남지 않는다.- 값은 요청마다 새로 만든 무작위 문자열이다. 해제할 때 "내 락인지" 확인하는 데 쓴다.
해제는 DEL만 하면 안 된다. 내 TTL이 이미 지나 다른 클라이언트가 잡은 락을 지울 수 있다. 값을 비교하고 지우는 두 동작을 Lua 스크립트로 묶어 원자적으로 실행한다.
if redis.call("get", KEYS[1]) == ARGV[1] then
  return redis.call("del", KEYS[1])
else
  return 0
end
TTL은 작업 시간의 최대치보다 넉넉히 잡는다. 작업이 길어질 수 있으면 보유 중에 TTL을 연장한다. Java의 Redisson은 이 연장을 watchdog으로 자동화한다. 단, Redis를 복제 구성으로 쓰면 복제가 비동기라서 마스터가 락을 기록한 직후 죽고 복제본이 승격되면 락이 사라질 수 있다.
Redlock과 2016년 논쟁
Redlock은 서로 독립된 Redis 마스터 N대(보통 5대)에 같은 키를 차례로 SET NX PX하고, 과반(3대 이상)에서 성공하고 걸린 시간이 TTL보다 충분히 짧으면 락을 얻은 것으로 보는 알고리즘이다. 남은 유효 시간은 TTL에서 획득에 걸린 시간과 시계 오차 여유를 뺀 값이다.
2016년 Kleppmann은 "How to do distributed locking"에서 두 가지를 지적했다.
- Redlock은 펜싱 토큰처럼 단조 증가하는 번호를 만들지 않는다. 그래서 GC 멈춤이나 네트워크 지연으로 만료된 보유자가 늦게 쓰는 것을 저장소가 가려낼 수 없다.
- 안전성이 시계와 지연에 대한 가정에 기대고 있다. 노드의 시계가 크게 뛰거나 프로세스가 오래 멈추면 두 클라이언트가 동시에 락을 가졌다고 믿을 수 있다.
Redis를 만든 antirez(Salvatore Sanfilippo)는 "Is Redlock safe?"로 반론했다. 시계 급변은 운영으로 피할 수 있고(시간 동기화를 점진 조정으로), 락을 얻은 뒤의 지연은 어떤 락 서비스에도 있는 문제이며, 무작위 값을 저장소의 조건부 갱신에 쓰면 비슷한 보호를 얻을 수 있다는 주장이다.
이 논쟁은 한쪽 승리로 정리되지 않았다. 실무에서 가져갈 결론은 "정확성이 걸린 곳이면 어떤 락을 쓰든 저장소 쪽 검증을 함께 둔다"이다.
DB로 하는 락: 행 락, 유니크 키, advisory lock
이미 데이터를 관계형 DB에 두고 있다면 새 인프라 없이 락을 얻을 수 있다.
행 락. 보호할 대상 행을 SELECT ... FOR UPDATE로 잠근다. 같은 행을 잠그려는 다른 트랜잭션은 커밋·롤백까지 기다린다. 기다리지 않으려면 NOWAIT(즉시 실패)나 SKIP LOCKED(잠긴 행 건너뛰기)를 지원하는 DB에서 쓴다. 작업 큐에서 여러 워커가 서로 다른 건을 집을 때 SKIP LOCKED가 잘 맞는다.
유니크 키 삽입. locks(name PRIMARY KEY, owner, expires_at) 테이블에 행을 넣는 쪽이 락을 얻는다. 중복 키 오류가 나면 실패다. 보유자가 죽으면 행이 남으므로, 만료된 행을 조건부로 가져오는 갱신이 필요하다.
UPDATE locks SET owner = :me, expires_at = now() + interval '30 seconds'
 WHERE name = :name AND expires_at < now();
PostgreSQL advisory lock. 테이블 행과 무관하게 숫자 키로 잡는 락이다.
BEGIN;
SELECT pg_advisory_xact_lock(20261102);  -- 정산 작업마다 정한 숫자 키
-- 정산 작업
COMMIT;  -- 트랜잭션이 끝나면 자동 해제
pg_try_advisory_lock은 기다리지 않고 true/false를 돌려준다. 세션 단위 pg_advisory_lock은 PgBouncer 트랜잭션 모드 같은 커넥션 풀 뒤에서 다른 요청과 세션이 섞이므로 트랜잭션 단위 함수를 쓴다. MySQL에는 GET_LOCK(name, timeout)이 비슷한 역할을 한다.
DB 락의 장점은 업무 데이터와 같은 트랜잭션 안에서 끝난다는 점이다. 단점은 락 대기가 커넥션을 붙잡는다는 점이다. 오래 걸리는 작업에 쓰면 커넥션 풀이 마른다.
ZooKeeper와 etcd: 합의 기반 락
ZooKeeper와 etcd는 합의 알고리즘(ZAB, Raft)으로 쓰기 순서를 모든 노드가 같게 보도록 만든다. 그래서 "누가 먼저인가"를 시계가 아니라 기록 순서로 정한다.
ZooKeeper 레시피.
/locks/order-1001/아래에 임시(ephemeral) 순차(sequential) 노드를 만든다. 예:lock-0000000007.- 자식 목록을 읽어 내 번호가 가장 작으면 락을 얻은 것이다.
- 아니면 바로 앞 번호 노드 하나에만 watch를 건다. 모든 노드를 watch하면 해제 한 번에 대기자 전원이 깨어나는 무리 효과(herd effect)가 생긴다.
- 보유자의 세션이 끊기면 임시 노드가 지워지고 다음 대기자가 깨어난다.
Java에서는 Apache Curator의 InterProcessMutex가 이 레시피를 구현한다. 노드 순번이나 zxid는 단조 증가하므로 펜싱 토큰으로 쓸 수 있다.
etcd. lease(TTL)를 만들고 키를 그 lease에 붙인다. 보유자는 KeepAlive로 lease를 연장하고, 끊기면 키가 지워진다. 대기 순서는 키의 생성 revision으로 정하며, 이 revision이 펜싱 토큰 역할을 한다.
etcdctl lock settlement-job ./run-settlement.sh
대가는 운영이다. 3대나 5대 클러스터를 따로 운영해야 하고, 쓰기마다 과반 합의를 거치므로 Redis보다 느리다. 초당 수만 건의 짧은 락보다 리더 선출, 배치 단일 실행 같은 굵은 락에 맞는다.
펜싱 토큰: 락이 만료돼도 저장소가 막는다
TTL이 있는 락은 모두 같은 약점이 있다. 보유자가 GC나 네트워크 지연으로 TTL보다 오래 멈추면, 깨어난 뒤에도 자기가 락을 가졌다고 믿고 쓴다.
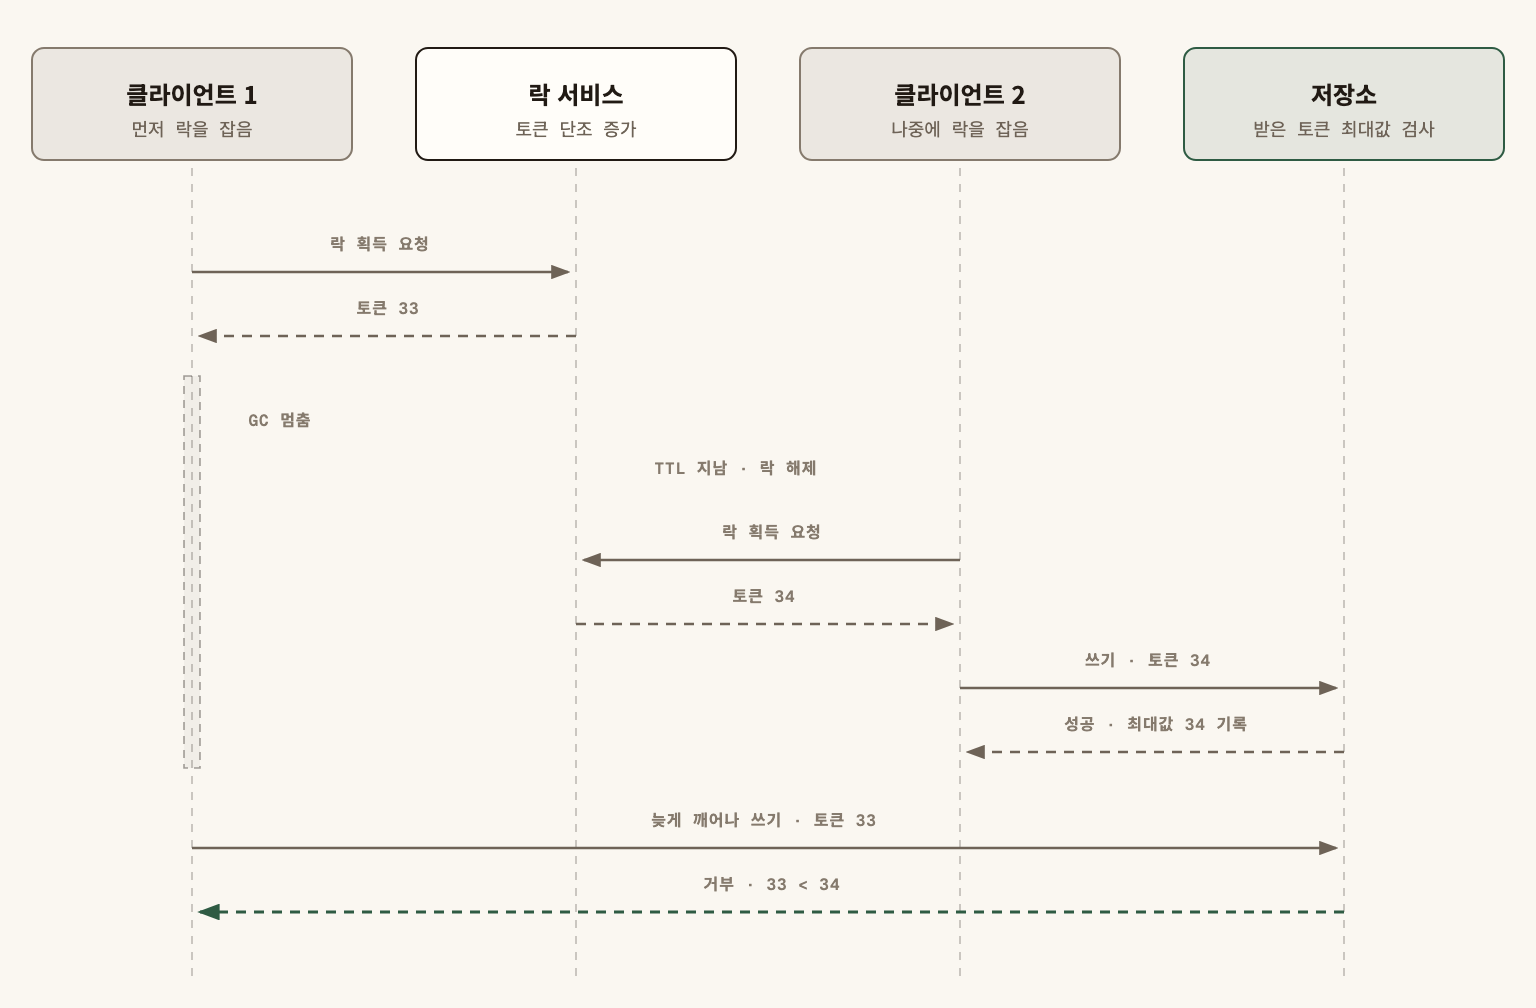
펜싱 토큰은 락을 줄 때마다 1씩 커지는 번호를 함께 주고, 저장소가 "지금까지 받은 가장 큰 번호보다 작으면 거부"하는 방식이다. 저장소 쪽 구현은 조건부 갱신 한 줄이다.
UPDATE inventory
   SET qty = qty - :n, fence_token = :token
 WHERE sku = :sku AND fence_token < :token;
-- 영향받은 행이 0이면 만료된 락의 쓰기이므로 작업을 버린다
토큰은 ZooKeeper의 zxid, etcd의 revision, DB 시퀀스, Redis INCR로 만들 수 있다. Redis로 토큰을 만들 때는 그 카운터 자체가 장애 시 되돌아가지 않는지 따져야 한다.
선택 기준 정리
| 상황 | 고를 것 | 이유 |
|---|---|---|
| 스케줄 작업 중복 실행 방지 | Redis SET NX PX 또는 DB 유니크 키 |
드물게 두 번 돌아도 손해가 작다 |
| 업무 데이터와 같은 DB의 갱신 | 행 락, advisory lock | 같은 트랜잭션에서 끝나고 새 인프라가 없다 |
| 돈·재고처럼 틀리면 안 되는 갱신 | 합의 기반 락 + 펜싱 토큰, 또는 DB 조건부 갱신만 | 만료된 보유자의 쓰기를 저장소가 막는다 |
| 리더 선출, 단일 실행 서비스 | ZooKeeper, etcd | 세션·lease로 장애를 감지하고 순서가 보장된다 |
| 이미 Redis만 있고 정확성이 필요 | Redis 락 + 저장소 쪽 검증 | 락만으로는 보장할 수 없다 |
자주 하는 실수
DEL로 해제한다. 내 TTL이 지난 뒤 다른 클라이언트가 잡은 락을 지워 세 번째 클라이언트까지 들어온다.- TTL 없이 락을 잡는다. 보유자가 죽으면 락이 영원히 남아 사람이 손으로 지울 때까지 작업이 멈춘다.
- TTL을 평균 작업 시간에 맞춘다. 느린 1%의 요청에서 락이 먼저 풀려 동시 실행이 생긴다.
- 락 획득 실패를 무한 재시도한다. 대기자가 몰리면 Redis나 DB에 재시도 폭주가 생긴다. 지수 백오프와 최대 대기 시간을 둔다.
- 정확성용인데 락만 둔다. GC 멈춤 한 번이면 두 보유자가 동시에 쓴다. 저장소에서 토큰이나 버전으로 한 번 더 막는다.
점검표
- 이 락이 효율용인지 정확성용인지 문서에 적었다.
- 락 값은 요청마다 새로 만든 무작위 문자열이다.
- 해제는 값 비교 후 삭제를 원자적으로 한다.
- TTL은 작업 시간 최대치보다 길고, 길어지면 연장한다.
- 획득 실패 시 백오프와 최대 대기 시간이 있다.
- 정확성용이면 저장소가 펜싱 토큰이나 버전으로 늦은 쓰기를 거부한다.
- DB advisory lock은 커넥션 풀 모드와 맞는 단위(트랜잭션 단위)를 쓴다.
- Redis 복제 구성에서 장애 전환 시 락이 사라질 수 있음을 알고 있다.
- 락 대기 시간과 획득 실패 수를 지표로 본다.
분산 락은 어디에 두느냐보다 두 명이 동시에 잡혔을 때 무엇이 깨지는지를 먼저 정하는 문제이고, 깨지면 안 되는 데이터라면 락과 별도로 저장소가 마지막 문을 지켜야 한다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.