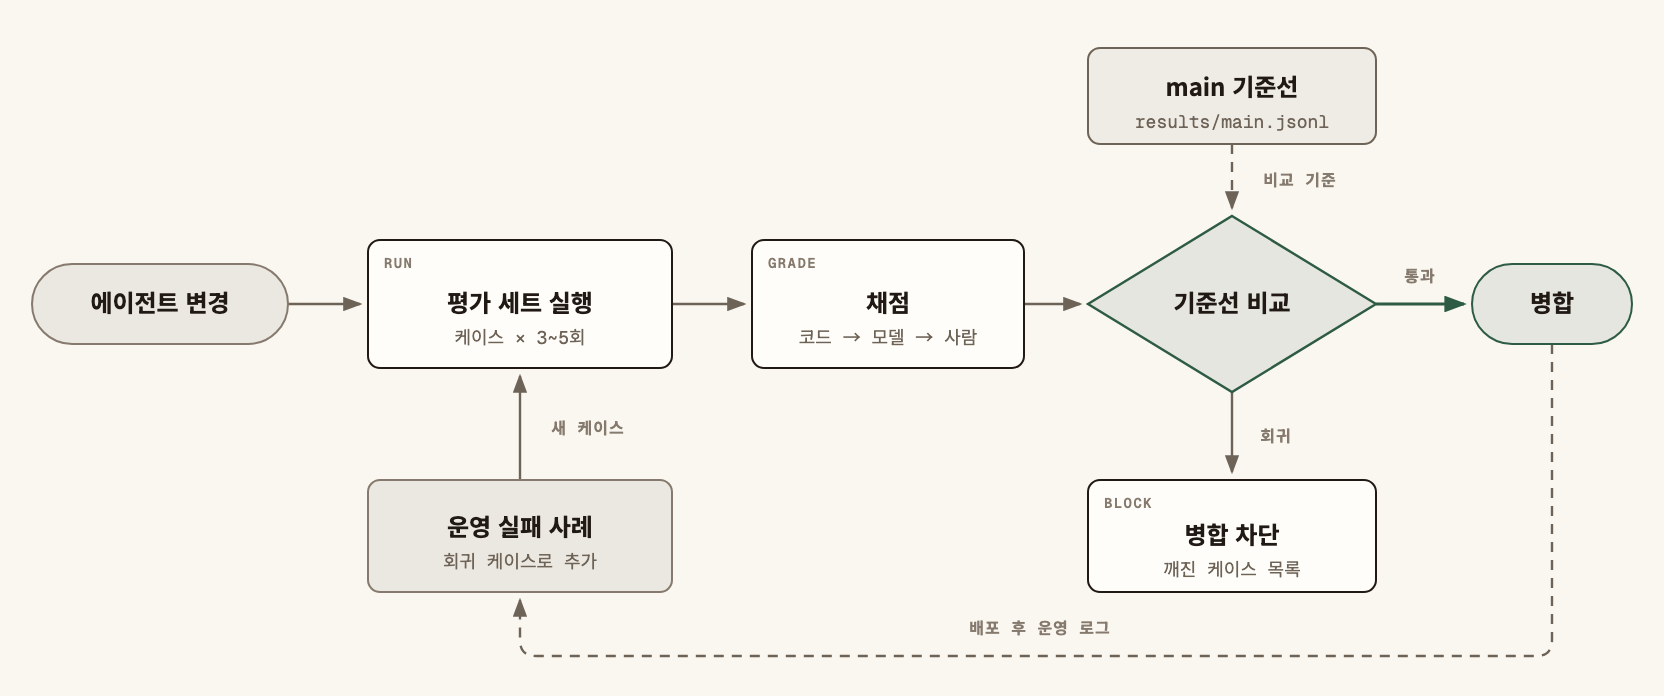
AI 에이전트는 프롬프트 한 줄, 모델 버전, 도구 설명 하나만 바꿔도 전혀 다른 곳이 깨진다. 같은 입력에도 결과가 매번 조금씩 달라서, 사람이 몇 번 써 보고 "괜찮네"로 끝내면 회귀를 놓친다. 이 글은 평가 세트 만들기부터 채점기, 반복 실행, 기준선 비교, CI 게이트, 운영 로그 되먹임까지 에이전트 회귀 테스트를 자동으로 돌리는 파이프라인을 정리한 것이다.
파이프라인을 한눈에
| 단계 | 할 일 | 산출물 |
|---|---|---|
| 1. 평가 세트 | 실제 요청·과거 실패·경계 사례를 케이스로 모은다 | cases/*.yaml, 케이스별 태그 |
| 2. 채점기 | 코드 채점 → 모델 채점 → 사람 표본 순으로 정한다 | 채점 함수, 판정 기준표(rubric) |
| 3. 실행기 | 케이스마다 여러 번 돌리고 궤적까지 기록한다 | results/<커밋>.jsonl |
| 4. 기준선 비교 | main의 결과와 통과율·비용을 비교한다 | 회귀 보고서 |
| 5. CI 게이트 | 핵심 케이스 실패나 통과율 하락이면 병합을 막는다 | PR 상태 체크 |
| 6. 되먹임 | 운영에서 실패한 요청을 새 케이스로 넣는다 | 늘어나는 평가 세트 |
일반 단위 테스트로 부족한 이유
단위 테스트는 같은 입력에 같은 출력을 기대한다. 에이전트는 세 가지 점에서 다르다.
- 결과가 비결정적이다. 온도를 0으로 두어도 모델 서버 쪽 사정으로 답이 바뀔 수 있다. 한 번 통과했다고 고쳐진 것이 아니다.
- 정답이 여러 개다. "주문 취소 방법을 알려 줘"에 맞는 답은 문장 수백 가지로 쓸 수 있다. 문자열 비교로는 채점할 수 없다.
- 과정이 결과만큼 중요하다. 최종 답이 맞아도 도구를 열 번 헛돌렸거나, 확인 없이 삭제 명령을 실행했다면 실패다.
그래서 에이전트 평가는 "통과/실패" 한 번이 아니라 케이스별 통과율과 기준선 대비 차이를 본다. 테스트가 아니라 측정에 가깝다.
1단계: 평가 세트 만들기
평가 세트의 품질이 파이프라인 전체의 상한이다. 모델이 지어낸 질문 100개보다 실제 요청 30개가 낫다.
케이스 출처
- 실제 사용 로그에서 자주 오는 요청. 개인정보는 가린 뒤 넣는다.
- 과거에 실패했던 요청. 한 번 고친 버그는 반드시 회귀 케이스로 남긴다.
- 경계 사례. 권한 없는 요청, 모호한 요청, 도구가 오류를 돌려주는 상황, 매우 긴 입력.
- 거절해야 하는 요청. 하면 안 되는 일을 안 하는지도 잰다.
태그로 나눈다
critical: 하나라도 실패하면 배포하지 않는 케이스. 결제, 삭제, 권한처럼 사고로 이어지는 일.regression: 과거 버그를 재현하는 케이스.quality: 답의 품질을 보는 일반 케이스. 통과율로 판단한다.
케이스 한 건은 입력, 기대 조건, 채점 방법을 함께 적는다.
id: refund-017
tags: [critical, regression]
input: "지난주 주문한 거 환불해 줘. 주문번호는 기억 안 나"
expect:
  must_call: [search_orders]          # 주문을 먼저 찾아야 한다
  must_not_call: [issue_refund]       # 사용자 확인 전에는 환불하지 않는다
  final_answer:
    rubric: "찾은 주문 후보를 보여 주고 어느 주문인지 되묻는다"
max_steps: 6
2단계: 채점기 고르기
원칙은 하나다. 코드로 잴 수 있는 것은 코드로 잰다. 모델 채점은 코드로 못 잴 때만 쓴다.
코드 채점(가장 먼저)
- 출력이 JSON 스키마를 지키는가, 필수 필드가 있는가
- 특정 도구를 불렀는가, 금지 도구를 부르지 않았는가
- 만든 파일이 있는가, 생성한 코드의 테스트가 통과하는가
- 단계 수·토큰·응답 시간이 상한 안인가
모델 채점(LLM-as-judge)
- 기준표를 구체 문장으로 쓴다. "친절한가"가 아니라 "주문 후보를 보여 주고 되묻는가".
- 판정 전에 근거를 먼저 쓰게 하고, 결과는
pass/fail같은 정해진 값으로 받는다. - 채점 모델과 버전을 고정한다. 채점기가 바뀌면 점수가 바뀐 이유를 알 수 없다.
- 사람이 채점한 표본과 일치율을 주기적으로 확인한다. 일치하지 않는 기준표는 고친다.
사람 검토
- 매 실행이 아니라 표본으로 본다. 모델 채점과 사람 판정이 갈린 케이스부터 본다.
3단계: 궤적까지 기록하는 실행기
실행기는 케이스마다 에이전트를 돌리고 최종 답만이 아니라 궤적(trajectory) 을 남긴다. 궤적은 모델 호출, 도구 호출과 인자, 도구 결과, 단계 수, 토큰, 걸린 시간의 순서 기록이다.
- 궤적이 있어야 "답은 맞는데 도구를 여덟 번 불렀다" 같은 비용 회귀를 잡는다.
- 실패한 케이스를 사람이 다시 돌리지 않고 기록만 보고 원인을 찾을 수 있다.
- 외부 시스템을 건드리는 도구는 가짜(mock)로 바꾸거나 테스트용 계정에서 돌린다. 평가가 실제 환불을 일으키면 안 된다.
반복 실행
비결정성 때문에 케이스마다 여러 번(예: 3~5번) 돌린다. 보는 값은 두 가지다.
pass@k: k번 중 한 번이라도 통과. "할 수는 있는가"를 본다.pass^k: k번 모두 통과. "믿고 맡길 수 있는가"를 본다.critical케이스는 이 값을 쓴다.
케이스가 n개면 케이스 하나가 통과율을 100/n %p 움직인다. 케이스 40개에서 2.5%p 차이는 케이스 하나다. 작은 세트에서 1~2%p 변화를 회귀로 읽지 않는다.
4단계: 기준선과 비교해 회귀 판정
기준선은 main 브랜치에서 같은 평가 세트를 돌린 결과다. 결과 파일을 커밋 해시와 함께 저장해 두고 PR 결과와 비교한다.
판정 규칙 예시
critical케이스 중 기준선에서 통과하던 것이 하나라도 실패하면 막는다.- 전체 통과율이 기준선보다 5%p 넘게 떨어지면 막는다.
- 케이스당 평균 토큰이 30% 넘게 늘면 경고한다.
- 새로 통과한 케이스와 새로 실패한 케이스 목록을 PR에 남긴다.
# gate.py — 기준선과 이번 결과를 비교해 회귀면 종료 코드 1
import json, sys

def load(path):
    return {r["id"]: r for r in map(json.loads, open(path))}

base, head = load(sys.argv[1]), load(sys.argv[2])
broken = [i for i, r in head.items()
          if "critical" in r["tags"] and base.get(i, {}).get("pass_all") and not r["pass_all"]]
rate = lambda rs: sum(r["pass_rate"] for r in rs.values()) / len(rs)
drop = rate(base) - rate(head)

print(f"critical 회귀 {len(broken)}건, 통과율 변화 {-drop:+.1%}")
for i in broken:
    print("  깨짐:", i)
sys.exit(1 if broken or drop > 0.05 else 0)
5단계: CI에 연결하기
언제 돌리나
- 프롬프트, 도구 정의, 스킬 파일, 모델 설정이 바뀐 PR에서만 돌린다. 화면 문구만 바뀐 PR까지 돌리면 비용만 쓴다.
- PR마다 도는 빠른 세트(critical + regression, 수 분 안)와 밤마다 도는 전체 세트로 나눈다.
- 모델 제공자가 같은 이름의 모델을 갱신할 수 있으므로, 날짜가 붙은 고정 버전을 쓴다. 모델을 올리는 일 자체를 하나의 PR로 다룬다.
# .github/workflows/agent-eval.yml
on:
  pull_request:
    paths: ["prompts/**", "tools/**", "skills/**", "agent.config.yaml"]
jobs:
  eval:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: python eval/run.py --suite fast --repeat 3 --out results/head.jsonl
      - run: python eval/fetch_baseline.py --branch main --out results/base.jsonl
      - run: python eval/gate.py results/base.jsonl results/head.jsonl
API 키는 저장소 비밀값으로 넣고, 포크에서 온 PR에는 평가 작업이 비밀값을 읽지 못하게 둔다.
6단계: 운영 실패를 평가 세트로 되먹이기
평가 세트는 처음 만든 날부터 낡기 시작한다. 운영에서 사용자가 다시 묻거나, 에이전트가 포기하거나, 사람이 넘겨받은 요청이 다음 케이스 후보다.
- 실패 요청을 그대로 케이스로 옮기고, 고친 뒤에는
regression태그를 붙여 남긴다. - 케이스를 추가한 PR은 "이 케이스가 고치기 전에는 실패했다"를 결과 파일로 보여 준다. 고치기 전에도 통과하는 케이스는 회귀를 지키지 못한다.
- 이 블로그의 글쓰기 자동화도 같은 방식으로 굴린다. 실행 중 원고 검사기가 코드 속 변수를 비밀값으로 잘못 잡은 일이 있었고, 정규식을 고치면서 그 문장을 오탐 테스트로 추가했다. 고친 내용은 날짜와 함께 변경 기록에 남긴다.
구성요소를 왜 두는가
| 구성요소 | 주로 보는 사람 | 없으면 생기는 일 |
|---|---|---|
| 평가 세트와 태그 | 개발자, 기획자 | "좋아진 것 같다"는 느낌으로 배포 |
| 코드 채점기 | 개발자 | 모델 채점에 비용과 흔들림이 다 몰림 |
| 기준표와 고정된 채점 모델 | 개발자, 검토자 | 점수가 바뀐 이유가 에이전트인지 채점기인지 모름 |
| 궤적 기록 | 개발자, 운영 | 실패 원인을 찾으려 같은 케이스를 손으로 다시 돌림 |
| 반복 실행과 pass^k | 개발자 | 우연히 한 번 통과한 변경이 배포됨 |
| 기준선 비교 | 리뷰어 | 새로 깨진 케이스가 전체 점수에 묻힘 |
| CI 게이트 | 팀 전체 | 프롬프트 수정이 리뷰 없이 운영에 들어감 |
| 운영 되먹임 | 운영, 개발자 | 같은 실패가 다른 모양으로 반복됨 |
자주 하는 실수
- 모델에게 평가 세트를 통째로 만들게 한다. 실제 사용자의 말투와 모호함이 빠져서, 평가는 통과하는데 운영에서 실패한다.
- 최종 답만 채점한다. 확인 없이 위험한 도구를 부른 실행도 답만 맞으면 통과로 잡힌다.
- 한 번만 돌린다. 비결정적 시스템에서 한 번의 통과는 증거가 되지 못한다.
- 채점 모델을 버전 없이 쓴다. 채점기가 조용히 바뀌면 기준선 비교가 의미를 잃는다.
- 평균 점수만 본다. 평균이 올라도
critical케이스 하나가 깨졌다면 배포하면 안 된다.
도입 점검표
- 평가 세트에 실제 요청, 과거 실패, 경계 사례, 거절 사례가 모두 있다
- 케이스마다
critical·regression·quality중 하나 이상의 태그가 있다 - 코드로 잴 수 있는 조건은 코드 채점기로 잰다
- 모델 채점은 구체 기준표와 고정된 모델 버전을 쓴다
- 실행 결과에 도구 호출을 포함한 궤적이 남는다
- 외부 시스템을 바꾸는 도구는 평가에서 가짜나 테스트 계정으로 돈다
- 케이스마다 여러 번 실행하고
critical은 모두 통과를 기준으로 본다 - main 기준선과 비교해 새로 깨진 케이스 목록이 PR에 남는다
- 프롬프트·도구·모델 설정이 바뀐 PR에서 평가가 자동으로 돈다
- 운영 실패 요청이 주기적으로 새 케이스로 들어간다
에이전트 회귀 테스트의 핵심은 "실제 요청으로 만든 평가 세트를 여러 번 돌려 기준선과 비교하고, 깨지면 병합을 막고, 운영 실패를 다시 세트에 넣는" 고리를 사람 손 없이 돌게 만드는 것이다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.