Apache 앞단에 mod_jk를 두고 JBoss와 AJP로 붙인 구성은 공공·금융 SI에서 아직 흔하다. 이 구성의 장애는 대부분 애플리케이션이 아니라 연결에서 난다. mod_jk의 연결 풀, WAS의 스레드 수, 방화벽의 유휴 시간이 서로 맞지 않으면 503, 간헐적 지연, 세션 끊김이 생긴다. 이 글은 요청이 mod_jk에서 JBoss까지 가는 구조를 설정 항목 단위로 나누고, 증상별로 어디를 먼저 봐야 하는지 정리한 것이다.
한눈에 보기
| 구간 | 설정이 사는 곳 | 핵심 항목 | 어긋나면 |
|---|---|---|---|
| 클라이언트 → Apache | httpd.conf |
MPM 동시 처리 수, JkMount |
요청이 Apache 앞에서 대기 |
| mod_jk 연결 풀 | workers.properties |
connection_pool_size, connection_pool_timeout |
WAS 스레드 고갈, 끊긴 소켓 재사용 |
| 연결 점검 | workers.properties |
ping_mode, ping_timeout, socket_keepalive |
방화벽이 끊은 연결로 요청 전송 |
| 응답 대기 | workers.properties |
reply_timeout, max_reply_timeouts |
긴 요청 하나로 노드가 ERR 처리 |
| 분산과 복구 | lb 워커 | balance_workers, sticky_session, recover_time |
전체 노드 ERR로 503 |
| JBoss AJP 리스너 | standalone*.xml |
스레드 수, 유휴 연결 시간, 노드 이름 | 세션 끊김, 요청 거부 |
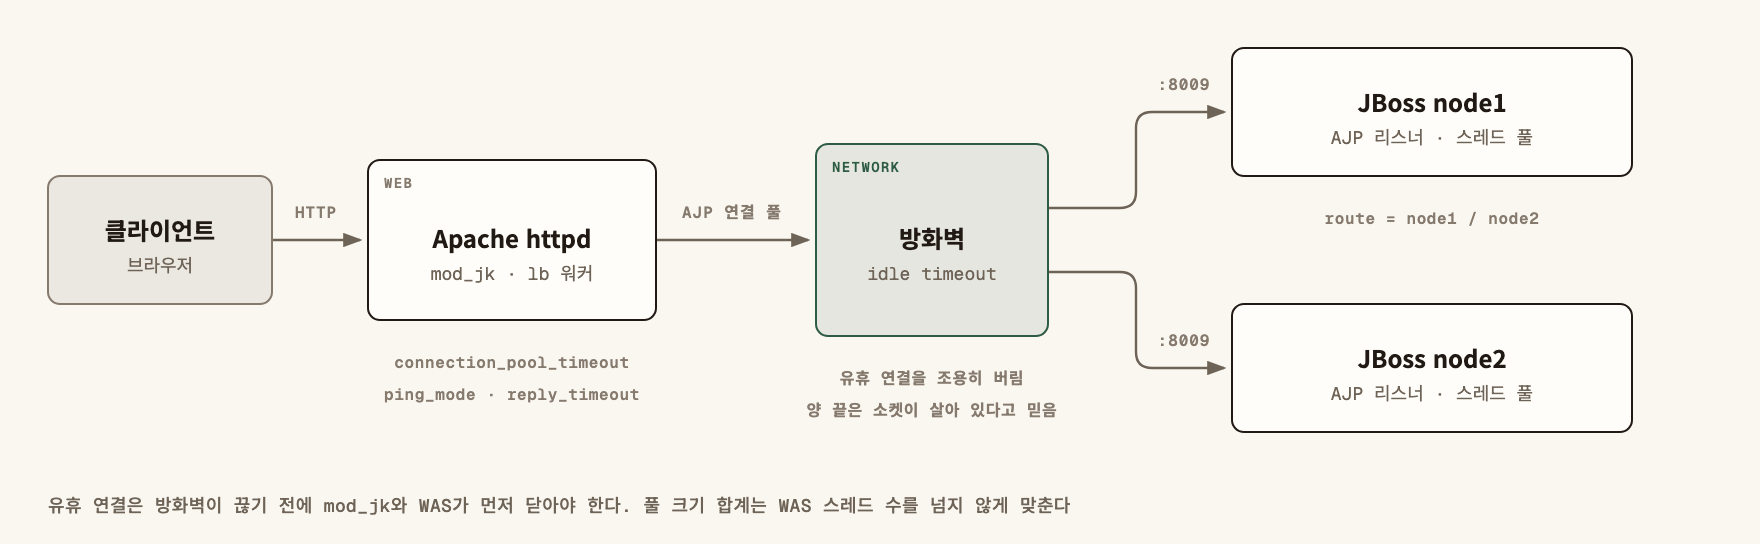
AJP 연결은 요청마다 새로 맺지 않고 풀에 두고 다시 쓴다. 이 "오래 사는 연결"이 성능의 이유이면서 장애의 원인이다. 아래 섹션은 모두 이 연결을 누가, 언제 닫는지에 관한 이야기다.
workers.properties로 보는 연결 구조
mod_jk는 워커(worker) 단위로 동작한다. ajp13 워커는 JBoss 노드 하나와의 연결을, lb 워커는 여러 ajp13 워커 사이의 분산을, status 워커는 상태 확인 화면을 맡는다. Apache는 JkMount로 URL을 워커에 연결한다.
# httpd.conf
LoadModule jk_module modules/mod_jk.so
JkWorkersFile conf/workers.properties
JkShmFile     logs/mod_jk.shm
JkLogFile     logs/mod_jk.log
JkLogLevel    info
JkMount /app/*    lb
JkMount /jkstatus jkstatus
<Location /jkstatus>
    Require ip 10.0.0.0/8
</Location>
공통 값은 템플릿 워커에 두고 노드 워커가 reference로 물려받으면 노드가 늘어도 값이 어긋나지 않는다.
# workers.properties (값은 예시)
worker.list=lb,jkstatus

worker.template.type=ajp13
worker.template.port=8009
worker.template.lbfactor=1
worker.template.socket_keepalive=true
worker.template.connection_pool_timeout=600
worker.template.ping_mode=A
worker.template.ping_timeout=10000
worker.template.connection_ping_interval=100
worker.template.reply_timeout=60000
worker.template.secret=<공유-비밀값>

worker.node1.reference=worker.template
worker.node1.host=10.0.1.11
worker.node2.reference=worker.template
worker.node2.host=10.0.1.12

worker.lb.type=lb
worker.lb.balance_workers=node1,node2
worker.lb.sticky_session=true
worker.lb.max_reply_timeouts=10

worker.jkstatus.type=status
단위가 섞여 있다는 점을 먼저 기억한다. connection_pool_timeout, connection_ping_interval은 초, ping_timeout, reply_timeout은 밀리초다. 단위를 헷갈려 600밀리초 뒤에 연결을 버리거나 60,000초 동안 응답을 기다리는 설정이 실제로 자주 나온다.
sticky session은 세션 ID 끝에 붙은 노드 이름(.node1)을 lb 워커의 멤버 이름(또는 멤버의 route 값)과 맞춰 보는 방식이다. JBoss의 노드 이름과 mod_jk 워커 이름이 다르면 일치하는 멤버가 없어 아무 노드로나 보내고, 세션 복제가 없으면 사용자는 로그아웃된다.
연결 수 계산: 풀 크기와 WAS 스레드
mod_jk의 연결 풀은 Apache 프로세스마다 따로 있다. prefork MPM이면 프로세스당 연결 1개, worker·event MPM이면 기본 풀 크기가 프로세스의 스레드 수(ThreadsPerChild)와 같다. 그래서 한 노드가 받을 수 있는 최대 연결 수는 "Apache 대수 × 프로세스 수 × 풀 크기"다.
예시로 계산해 보자.
| 항목 | 값(예시) |
|---|---|
| Apache | 2대, event MPM, ThreadsPerChild 25, 프로세스 최대 16개 |
| Apache 1대가 node1에 열 수 있는 연결 | 16 × 25 = 400 |
| node1이 받을 수 있는 최대 연결 | 400 × 2 = 800 |
| JBoss node1의 요청 처리 스레드 | 200 |
연결 하나가 스레드 하나를 붙잡는 블로킹 방식 커넥터라면, 놀고 있는 연결도 스레드를 차지한다. 201번째 연결부터는 받아 줄 스레드가 없어 mod_jk가 연결이나 응답을 기다리다 그 노드를 오류로 판정한다. Undertow나 Tomcat NIO 계열처럼 논블로킹 방식이면 유휴 연결은 스레드를 잡지 않지만, 동시에 처리 중인 요청 수는 여전히 스레드 수를 넘을 수 없다.
평소에는 이 차이가 드러나지 않는다. 피크 300 TPS, 평균 응답 0.4초라면(예시) 동시 처리 요청은 리틀의 법칙으로 300 × 0.4 = 120개, 노드당 60개다. 그런데 DB가 느려져 응답이 4초가 되면 동시 요청은 1,200개로 열 배가 되고, 노드당 200 스레드는 금방 찬다. 둘 중 하나를 고른다.
- WAS가 다 받는다: 노드 스레드 수를 Apache가 열 수 있는 연결 합계 이상으로 둔다. 메모리와 DB 커넥션 풀도 같이 늘려야 한다.
- Apache에서 막는다:
connection_pool_size나 MPM 동시 처리 수를 줄여 Apache 앞에서 대기시킨다. WAS는 보호되지만 사용자는 대기 시간을 겪는다.
어느 쪽이든 숫자를 계산해 문서로 남긴다. 계산 없이 양쪽 기본값을 쓰면 장애 날 때 처음으로 그 숫자를 보게 된다.
유휴 연결과 방화벽: 시간 세 개를 맞춘다
Apache와 JBoss 사이에 방화벽이 있으면 시간 설정이 세 군데에 생긴다.
- 방화벽 유휴 세션 시간: 이 시간 동안 패킷이 없으면 세션 정보를 지운다. 대개 양 끝에 알리지 않는다.
- mod_jk
connection_pool_timeout: 이 시간(초) 동안 쓰지 않은 연결을 mod_jk가 닫는다. - WAS 쪽 유휴 연결 시간: Tomcat 계열 커넥터의
connectionTimeout, Undertow 리스너의no-request-timeout(둘 다 밀리초).
순서는 "mod_jk ≤ WAS < 방화벽"이다. mod_jk가 먼저, 또는 WAS와 같은 시점에 닫아야 하고, 둘 다 방화벽보다 짧아야 한다. mod_jk 문서도 connection_pool_timeout과 WAS 쪽 연결 시간을 같은 값으로 맞추라고 안내한다.
방화벽이 먼저 지우면 반쯤 끊긴 연결이 생긴다. mod_jk와 JBoss 둘 다 소켓이 살아 있다고 믿는다. 밤새 쉬던 풀에서 아침 첫 요청이 그 소켓으로 나가면 패킷은 방화벽에서 버려지고, mod_jk는 응답을 기다리다 시간 초과나 연결 재설정 오류(Linux errno 104, 110 등)를 남긴다. 사용자에게는 "아침 첫 화면만 느리다"나 "가끔 한 번 실패하고 새로고침하면 된다"로 보인다.
시간 맞추기와 함께 점검을 켠다.
ping_mode: AJP의 CPing/CPong으로 연결을 확인한다.C는 연결 직후,P는 요청 보내기 직전,I는 일정 간격,A는 셋 다다.P는 요청마다 왕복 한 번이 늘지만 내부망에서는 대개 감당할 만하다.connection_ping_interval:I모드의 간격(초)이다. 방화벽 유휴 시간보다 훨씬 짧게 둔다.socket_keepalive: OS의 TCP keepalive를 켠다. 다만 OS 기본 keepalive 간격이 방화벽 시간보다 길면 효과가 없으니 커널 설정도 확인한다.
타임아웃과 워커 상태: ERR에서 503까지
lb 워커는 멤버 노드에 오류가 나면 그 노드를 ERR 상태로 두고 분산에서 뺀다. recover_time(초)이 지나면 다시 요청을 보내 보고, 성공하면 복귀시킨다. 모든 멤버가 ERR이면 보낼 곳이 없으므로 mod_jk는 503을 돌려준다.
여기서 흔한 연쇄가 생긴다.
- node1이 잠깐 느려져 ERR이 된다.
- 요청이 전부 node2로 몰린다. node2의 스레드가 두 배 속도로 찬다.
- node2도 ERR이 된다. 이제 모든 요청이 503이다.
recover_time동안은 두 노드 모두 회복할 기회조차 없다.
reply_timeout은 응답 패킷 사이의 최대 대기 시간이다. 보고서 출력이나 대용량 엑셀 다운로드처럼 원래 오래 걸리는 요청이 이 값에 걸리면, 요청 하나 때문에 노드 전체가 ERR이 된다. lb 워커의 max_reply_timeouts를 주면 일정 횟수까지는 노드를 ERR로 만들지 않는다. 오래 걸리는 URL은 reply_timeout을 길게 준 별도 워커로 JkMount를 나누는 편이 더 깔끔하다.
status 워커 화면은 장애 때 가장 먼저 본다. 멤버별 상태, 처리 중인 요청 수, 오류 횟수가 보이고, 배포 때는 멤버를 Disabled(새 세션만 막음)나 Stopped(전부 막음)로 바꿀 수 있다. 이 화면은 노드를 끌 수도 있으므로 반드시 접근 IP를 제한한다.
JBoss 쪽 설정: Undertow와 예전 JBoss
JBoss EAP 7 이후와 WildFly는 웹 계층이 Undertow다. AJP는 Undertow 서브시스템의 ajp-listener가 받고, 요청 처리 스레드는 그 리스너가 쓰는 IO 서브시스템 워커의 task-max-threads가 정한다. 노드 이름은 Undertow의 instance-id이고 세션 ID 끝에 붙는다.
# jboss-cli.sh (값은 예시)
/subsystem=undertow/server=default-server/ajp-listener=ajp:add(socket-binding=ajp)
/subsystem=undertow/server=default-server/ajp-listener=ajp:write-attribute(name=no-request-timeout, value=600000)
/subsystem=undertow:write-attribute(name=instance-id, value=node1)
/subsystem=io/worker=default:write-attribute(name=task-max-threads, value=200)
IO 워커는 HTTP 리스너와 같이 쓰는 경우가 많다. 이때 task-max-threads는 AJP만의 값이 아니라 그 워커를 쓰는 모든 리스너의 합계다.
Tomcat 계열 웹 컨테이너를 쓰던 예전 JBoss는 커넥터 속성으로 같은 것을 정한다. 설정 파일 위치와 이름은 버전마다 다르므로 쓰는 버전의 문서에서 확인하고, 개념은 아래 Tomcat 형식과 같다.
<Connector protocol="AJP/1.3" port="8009" address="10.0.1.11"
           maxThreads="200" connectionTimeout="600000"
           secretRequired="true" secret="<공유-비밀값>"/>
<Engine name="Catalina" defaultHost="localhost" jvmRoute="node1">
보안도 이 섹션에서 같이 정한다. Tomcat AJP 커넥터의 Ghostcat(CVE-2020-1938)은 외부에서 닿는 AJP 포트로 웹 애플리케이션 파일을 읽을 수 있던 취약점이다. 이후 Tomcat은 AJP 커넥터에 비밀값을 요구하도록 기본 동작을 바꿨다. mod_jk의 secret과 WAS 쪽 비밀값을 같은 값으로 맞추고, AJP 포트는 내부 주소에만 열고, 방화벽에서 Apache 서버 주소만 허용한다. Undertow AJP 리스너의 비밀값 지원 여부와 속성 이름은 쓰는 버전의 문서에서 확인한다.
장애 패턴별로 먼저 볼 곳
| 증상 | 먼저 볼 곳 | 흔한 원인 | 조치 |
|---|---|---|---|
| 모든 요청이 503 | status 워커 화면, mod_jk.log |
모든 멤버 ERR, 연쇄 장애 | 원인 노드 조치 후 멤버 상태 리셋, 풀·스레드 재계산 |
| 응답 없이 오래 걸림 | WAS 스레드 덤프, 처리 중 요청 수 | WAS 스레드 고갈(DB·외부 연계 대기) | 덤프에서 대기 지점 확인, 동시성 상한 조정 |
| 아침 첫 요청·간헐 실패 | mod_jk.log의 errno, 방화벽 세션 로그 |
방화벽이 지운 유휴 연결 재사용 | 시간 세 개 정렬, ping_mode 켜기 |
| 특정 화면에서만 실패 | reply_timeout 로그, 해당 URL 응답 시간 |
긴 요청이 reply_timeout 초과 |
별도 워커로 분리, max_reply_timeouts |
| 로그인 풀림 | 세션 ID 끝의 노드 이름, 워커 이름 | instance-id·jvmRoute와 워커 이름 불일치 |
이름 맞추기, 세션 복제 여부 확인 |
스레드 고갈은 mod_jk 설정이 아니라 WAS 안에서 무엇이 스레드를 붙잡고 있는지가 원인이다. 이때는 스레드 덤프를 몇 초 간격으로 세 번 떠서 같은 스택에 멈춘 스레드를 찾는다. mod_jk 쪽 타임아웃을 늘리는 것은 대기 시간을 늘릴 뿐 원인을 없애지 않는다.
반대로 WAS가 한가한데 503이 나면 연결 쪽 문제다. status 워커에서 ERR 멤버를 확인하고, mod_jk.log에서 ERR로 바뀐 첫 시각과 그 직전 오류 메시지를 찾는다. 첫 오류가 원인이고 뒤따르는 오류는 대부분 결과다.
자주 하는 실수
- 초와 밀리초를 섞어 쓴다.
connection_pool_timeout=600000처럼 밀리초를 넣으면 연결을 일주일 가까이 들고 있게 된다. - 방화벽 유휴 시간을 확인하지 않는다. 네트워크팀 설정이라 모르는 채로 두면 "가끔 실패"의 원인을 애플리케이션에서 찾느라 시간을 쓴다.
- 연결 수를 계산하지 않는다. Apache 대수와 프로세스 수를 곱한 값이 WAS 스레드 수를 넘는지 모르면 부하가 오를 때 연쇄 ERR이 난다.
- 오래 걸리는 요청과 일반 요청을 한 워커에 둔다. 다운로드 하나가
reply_timeout에 걸려 노드 전체를 분산에서 뺀다. - AJP 포트를 모든 주소에 연다. 비밀값 없이 열린 8009 포트는 Ghostcat 같은 공격 통로가 된다.
점검표
- Apache 대수 × 프로세스 수 × 풀 크기를 계산하고 노드 스레드 수와 비교한 기록이 있다
-
workers.properties의 각 시간 값 옆에 단위(초·밀리초)를 주석으로 적었다 - 방화벽 유휴 세션 시간을 네트워크팀에서 받아 문서에 적었다
- mod_jk
connection_pool_timeout이 WAS 유휴 연결 시간 이하이고, 둘 다 방화벽 시간보다 짧다 -
ping_mode를 켰고connection_ping_interval이 방화벽 시간보다 짧다 - 오래 걸리는 URL은
reply_timeout이 다른 별도 워커로 나눴다 - JBoss
instance-id(또는jvmRoute)와 mod_jk 멤버 이름이 일치한다 - AJP 포트는 내부 주소에만 열려 있고 양쪽 비밀값이 같다
-
status워커 화면은 운영자 IP에서만 열린다 - 노드 하나를 내린 상태에서 남은 노드가 피크 부하를 받는지 시험했다
mod_jk와 AJP의 장애는 대부분 오래 사는 연결을 누가 언제 닫는지, 그리고 연결 수와 스레드 수가 맞는지에서 갈린다. 시간 세 개와 숫자 두 개를 맞추고 상태 화면을 볼 줄 알면, 503과 간헐 실패의 원인을 몇 분 안에 좁힐 수 있다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.