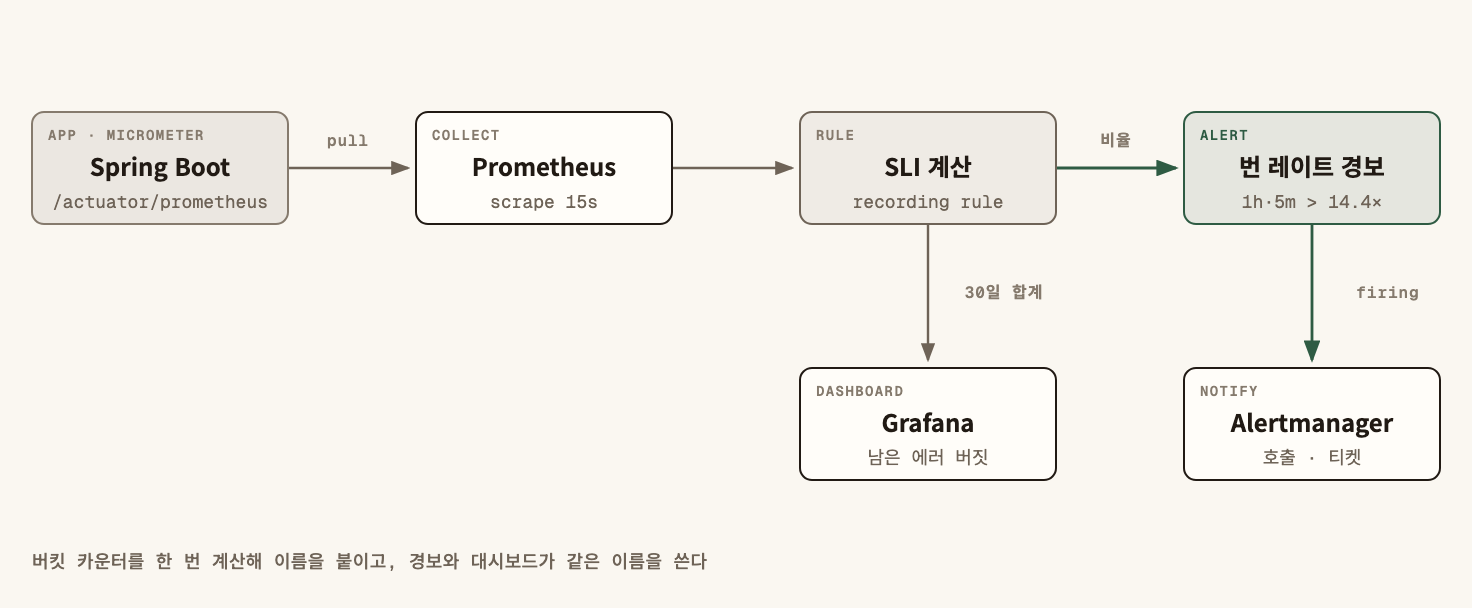
SLO는 "얼마나 자주 실패해도 되는가"를 숫자로 정해 두는 약속이고, 에러 버짓은 그 약속에서 아직 쓸 수 있는 실패의 양이다. 숫자를 정해도 대시보드와 경보가 그 숫자를 계산하지 않으면 SLO는 문서에만 남는다. 이 글은 Spring Boot 애플리케이션에서 Micrometer로 요청 지표를 남기고, Prometheus로 SLI를 계산하고, 번 레이트(burn rate)로 경보를 걸고, Grafana에 남은 에러 버짓을 올리는 과정을 순서대로 정리한다.
한눈에 보기
| 단계 | 하는 일 | 결과물 |
|---|---|---|
| 1. 정의 | SLI·SLO·측정 기간을 정한다 | "30일 동안 요청의 99.9%가 5xx 없이 응답" 같은 문장 |
| 2. 계측 | Micrometer가 http.server.requests를 히스토그램으로 남긴다 |
/actuator/prometheus 지표 |
| 3. 수집 | Prometheus가 주기적으로 긁어 간다(scrape) | 시계열 저장 |
| 4. 계산 | recording rule로 창(window)별 오류 비율을 미리 계산한다 | job:slo_error_ratio:rate1h 같은 지표 |
| 5. 경보 | 짧은 창과 긴 창의 번 레이트가 함께 넘을 때만 알린다 | Alertmanager 알림 |
| 6. 공개 | Grafana에 남은 에러 버짓과 번 레이트를 올린다 | 팀이 같이 보는 대시보드 |
평균 응답 시간과 퍼센타일의 차이는 P95와 P99가 평균 응답 시간보다 중요한 이유에서 다뤘다. 이 글은 그 퍼센타일을 목표로 삼은 뒤, 목표를 얼마나 빨리 잃고 있는지 재는 쪽에 집중한다.
SLI·SLO·에러 버짓을 먼저 정한다
도구를 설치하기 전에 문장 세 개를 정한다.
- SLI(지표): 좋은 이벤트 수 ÷ 전체 이벤트 수. 예를 들어 "5xx가 아닌 응답 수 ÷ 전체 응답 수"다. 비율로 정의해야 트래픽이 늘거나 줄어도 같은 기준으로 비교할 수 있다.
- SLO(목표): SLI가 측정 기간 동안 지켜야 할 값. 예: "30일 동안 가용성 SLI 99.9% 이상", "30일 동안 요청의 99%가 300ms 안에 응답".
- 에러 버짓: 1 − SLO. 99.9%라면 요청의 0.1%다. 예시로 30일 요청이 1,000만 건이면 1만 건까지 실패해도 목표는 지켜진다.
정할 때 붙일 조건
- 측정 대상 요청을 좁힌다. 헬스체크(
/actuator/**)와 정적 파일은 빼야 실제 사용자 경험이 SLI에 남는다. - 4xx를 실패로 셀지 정한다. 잘못된 입력에 대한 400은 서비스 실패가 아니므로 보통 5xx만 센다.
- 가용성과 지연 시간은 SLO를 따로 둔다. 둘을 하나로 묶으면 어느 쪽 때문에 버짓이 줄었는지 알 수 없다.
Micrometer로 요청을 히스토그램으로 남긴다
Spring Boot Actuator는 Spring MVC·WebFlux 요청마다 http.server.requests 타이머를 기록한다. micrometer-registry-prometheus를 추가하면 이 타이머가 Prometheus 형식으로 /actuator/prometheus에 노출된다. 이름은 http_server_requests_seconds_count, _sum, _bucket으로 바뀌고 uri, method, status, outcome 같은 태그가 라벨로 붙는다.
# application.yml
management:
  endpoints:
    web:
      exposure:
        include: health,prometheus
  server:
    port: 8081            # 지표는 내부 포트로만 연다
  metrics:
    distribution:
      slo:
        http.server.requests: 100ms,300ms,1s
      percentiles-histogram:
        http.server.requests: true
      minimum-expected-value:
        http.server.requests: 5ms
      maximum-expected-value:
        http.server.requests: 10s
slo는 지정한 경계값으로 히스토그램 버킷을 만든다. SLO 기준이 300ms라면le="0.3"버킷이 반드시 있어야 "300ms 안에 끝난 요청 수"를 정확히 셀 수 있다.percentiles-histogram은histogram_quantile로 P95·P99를 계산할 수 있도록 미리 정한 버킷을 추가한다. 버킷 하나가 시계열 하나이므로,minimum-expected-value·maximum-expected-value로 범위를 좁혀 시계열 수를 줄인다.- 지연 시간 SLO만 필요하고 퍼센타일 그래프가 필요 없다면
slo만 켜도 된다.
인스턴스별 퍼센타일은 합칠 수 없다. management.metrics.distribution.percentiles로 0.95, 0.99를 지정하면 Micrometer가 애플리케이션 안에서 퍼센타일을 계산해 quantile 라벨로 내보낸다. 이 값은 인스턴스마다 따로 계산된 결과라서, 서버 4대의 P99를 평균하거나 최댓값을 골라도 전체 P99가 되지 않는다. 버킷 카운터는 단순한 개수라 인스턴스끼리 더할 수 있고, 더한 히스토그램에서 퍼센타일을 계산하면 전체 값이 나온다. 그래서 SLO 계산에는 클라이언트 퍼센타일이 아니라 히스토그램 버킷을 쓴다.
Prometheus로 수집하고 SLI를 계산한다
수집 설정은 경로만 바꾸면 된다.
# prometheus.yml
scrape_configs:
  - job_name: order-api
    metrics_path: /actuator/prometheus
    scrape_interval: 15s
    static_configs:
      - targets: ['10.0.1.11:8081', '10.0.1.12:8081']
가용성 SLI는 전체 요청 중 5xx가 아닌 비율이다. Micrometer의 outcome 라벨은 5xx를 SERVER_ERROR로 표시한다.
# 최근 5분 오류 비율
sum(rate(http_server_requests_seconds_count{job="order-api", uri!~"/actuator.*", outcome="SERVER_ERROR"}[5m]))
/
sum(rate(http_server_requests_seconds_count{job="order-api", uri!~"/actuator.*"}[5m]))
지연 시간 SLI는 300ms 버킷에 들어온 요청 비율이다. 버킷은 누적값이라 le="0.3"이 "300ms 이하인 요청 수"다.
sum(rate(http_server_requests_seconds_bucket{job="order-api", uri!~"/actuator.*", le="0.3"}[5m]))
/
sum(rate(http_server_requests_seconds_count{job="order-api", uri!~"/actuator.*"}[5m]))
전체 P99 그래프가 필요하면 버킷을 먼저 더하고 계산한다. sum by (le)가 빠지면 인스턴스마다 따로 계산된다.
histogram_quantile(0.99, sum by (le) (rate(http_server_requests_seconds_bucket{job="order-api"}[5m])))
recording rule로 SLI를 고정한다. 같은 식을 대시보드와 경보가 각자 쓰면 조건이 조금씩 달라진다. recording rule로 한 번 계산해 이름을 붙이고, 모두 그 이름만 쓴다. 이름은 레벨:지표:연산 관례를 따른다.
# slo-rules.yml
groups:
  - name: order-api-slo
    rules:
      - record: job:slo_requests:rate5m
        expr: sum by (job) (rate(http_server_requests_seconds_count{job="order-api", uri!~"/actuator.*"}[5m]))
      - record: job:slo_errors:rate5m
        expr: sum by (job) (rate(http_server_requests_seconds_count{job="order-api", uri!~"/actuator.*", outcome="SERVER_ERROR"}[5m]))
      - record: job:slo_error_ratio:rate5m
        expr: job:slo_errors:rate5m / job:slo_requests:rate5m
      - record: job:slo_error_ratio:rate1h
        expr: |
          sum by (job) (rate(http_server_requests_seconds_count{job="order-api", uri!~"/actuator.*", outcome="SERVER_ERROR"}[1h]))
          /
          sum by (job) (rate(http_server_requests_seconds_count{job="order-api", uri!~"/actuator.*"}[1h]))
      # 30m, 6h 창도 같은 모양으로 추가한다
번 레이트로 경보를 건다
번 레이트는 에러 버짓을 쓰는 속도다. 오류 비율 ÷ (1 − SLO)로 계산한다. 번 레이트 1은 측정 기간이 끝날 때 버짓을 딱 다 쓰는 속도이고, 14.4는 그보다 14.4배 빠르다.
"오류율 1% 넘으면 알림" 같은 고정 임계값은 SLO와 연결되지 않는다. 짧게 튀는 오류에도 울리고, 오래 이어지는 낮은 오류는 놓친다. Google의 『The Site Reliability Workbook』 "Alerting on SLOs" 장은 긴 창과 짧은 창을 함께 보는 다중 창·다중 번 레이트 방식을 권한다.
| 심각도 | 긴 창 | 짧은 창 | 번 레이트 | 30일 버짓 소모 |
|---|---|---|---|---|
| 호출(page) | 1시간 | 5분 | 14.4 | 2% |
| 호출(page) | 6시간 | 30분 | 6 | 5% |
| 티켓 | 3일 | 6시간 | 1 | 10% |
긴 창은 "충분히 많이 쓰고 있는가"를, 짧은 창은 "지금도 계속 쓰고 있는가"를 본다. 짧은 창 조건 덕분에 장애가 끝나면 경보도 곧 풀린다.
      - alert: OrderApiErrorBudgetBurnFast
        expr: |
          job:slo_error_ratio:rate1h{job="order-api"} > (14.4 * 0.001)
          and
          job:slo_error_ratio:rate5m{job="order-api"} > (14.4 * 0.001)
        labels:
          severity: page
        annotations:
          summary: "order-api 에러 버짓 소모 속도 14.4배 초과 (1h·5m)"
0.001은 99.9% SLO의 에러 버짓이다. 지연 시간 SLO도 같은 방식으로 "느린 요청 비율 = 1 − 300ms 이하 비율"을 번 레이트로 바꿔 경보를 건다.
Grafana에 에러 버짓을 올린다
대시보드는 "지금 괜찮은가"보다 "이번 기간에 얼마나 남았나"를 먼저 보여 준다.
올릴 패널
- 남은 에러 버짓(Stat): 30일 오류 비율을 버짓으로 나눠 1에서 뺀다. 0% 아래로 내려가면 SLO를 어긴 것이다.
- 번 레이트(Time series): 1시간·6시간 번 레이트를 그리고 14.4, 6, 1에 기준선을 둔다. 경보가 왜 울렸는지 같은 화면에서 확인할 수 있다.
- SLI 추이(Time series): 가용성·300ms 이내 비율을 SLO 선과 함께 그린다.
- 배포 표시(Annotation): 배포 시각을 겹쳐 두면 버짓이 줄어든 원인을 찾는 시간이 줄어든다.
남은 버짓은 5분 요청 수·오류 수 recording rule을 30일 동안 더해 계산한다. 비율을 평균하지 않고 개수를 더해야 트래픽이 많은 시간대가 더 큰 비중을 갖는다.
1 - (
  (sum_over_time(job:slo_errors:rate5m{job="order-api"}[30d])
   / sum_over_time(job:slo_requests:rate5m{job="order-api"}[30d]))
  / 0.001
)
구성 요소별 역할
| 구성 요소 | 누가 보나 | 없으면 생기는 일 |
|---|---|---|
| SLO 문장(대상·기간·기준) | 개발·운영·발주처 | 장애 때마다 "이 정도면 괜찮은가"를 새로 다툼 |
slo 히스토그램 버킷 |
개발 | 300ms 이내 비율을 근사값으로만 계산 |
| recording rule | 운영 | 대시보드와 경보의 계산식이 조금씩 달라짐 |
| 다중 창 번 레이트 경보 | 당직자 | 짧은 오류에 자주 울리고 느린 소모는 놓침 |
| 에러 버짓 대시보드 | 팀 전체, 기획 | 배포를 늦출지 기능을 낼지 근거 없이 결정 |
자주 하는 실수
- 클라이언트 퍼센타일을 평균 낸다. 인스턴스별로 따로 계산된 값이라 합친 결과가 전체 퍼센타일이 아니다.
- SLO 경계값과 버킷이 맞지 않는다. 300ms 버킷이 없으면
histogram_quantile이 구간 안을 선형 보간한 근사값만 준다. - 보관 기간이 측정 기간보다 짧다. Prometheus 기본 보관 기간은 15일이라 30일 버짓을 계산할 수 없다.
--storage.tsdb.retention.time을 늘리거나 장기 저장소를 둔다. - 애플리케이션 지표만 본다. 앞단 L4·Reverse Proxy에서 끊긴 요청은 애플리케이션에 도달하지 않아 SLI에 잡히지 않는다. 앞단 로그나 외부 합성 모니터링으로 보완한다.
- 사용자 ID 같은 값을 태그로 붙인다. 값마다 시계열이 생겨 Prometheus 메모리가 급격히 늘어난다.
점검표
- SLI가 "좋은 이벤트 ÷ 전체 이벤트" 비율로 정의되어 있다
- SLO 문장에 대상 요청, 측정 기간, 기준값이 모두 있다
- 헬스체크와 정적 파일 요청이 SLI 계산에서 빠져 있다
-
/actuator/prometheus는 내부 포트로만 열려 있다 - 지연 시간 SLO 기준값과 같은
le버킷이 노출된다 - 퍼센타일은
sum by (le)로 버킷을 합친 뒤 계산한다 - 대시보드와 경보가 같은 recording rule 이름을 쓴다
- 경보는 긴 창과 짧은 창의 번 레이트를 함께 본다
- Prometheus 보관 기간이 SLO 측정 기간보다 길다
- 남은 에러 버짓 패널이 팀 대시보드 맨 위에 있다
SLO 모니터링은 목표 숫자를 정하는 데서 끝나지 않고, 히스토그램으로 남긴 요청을 같은 계산식으로 SLI와 번 레이트로 바꿔 경보와 대시보드가 함께 쓰게 만들 때 비로소 운영 판단의 기준이 된다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.