"배포를 더 자주 하자"는 개발팀과 "장애가 나니 덜 바꾸자"는 운영팀의 다툼은 기준이 없으면 목소리 큰 쪽이 이긴다. Error Budget(에러 버짓)은 SLO가 허락하는 실패의 양을 숫자로 정해 두고, 그 숫자가 남아 있으면 배포하고 바닥나면 안정성 작업으로 돌아가게 만드는 장치다. 이 글은 SLO에서 버짓을 계산하는 법, 번 레이트 경보, 버짓 정책 문서, 배포 파이프라인의 버짓 게이트까지 순서대로 정리한다.
한눈에 보기
| 단계 | 정하는 것 | 결과물 |
|---|---|---|
| 1. SLI | 무엇을 성공·실패로 셀지 | 5xx 제외 요청 비율, 300ms 이하 응답 비율 |
| 2. SLO | 목표와 측정 기간 | 30일 이동 창 99.9% |
| 3. 버짓 | 허용되는 실패의 양 | 43.2분 또는 요청 1,000건 중 1건 |
| 4. 번 레이트 경보 | 버짓을 쓰는 속도가 위험한 때 | 다중 창 경보 규칙 |
| 5. 정책 | 버짓이 줄면 무엇을 멈추나 | 서명된 에러 버짓 정책 |
| 6. 배포 게이트 | 정책을 사람 대신 집행 | CD 파이프라인 단계 |
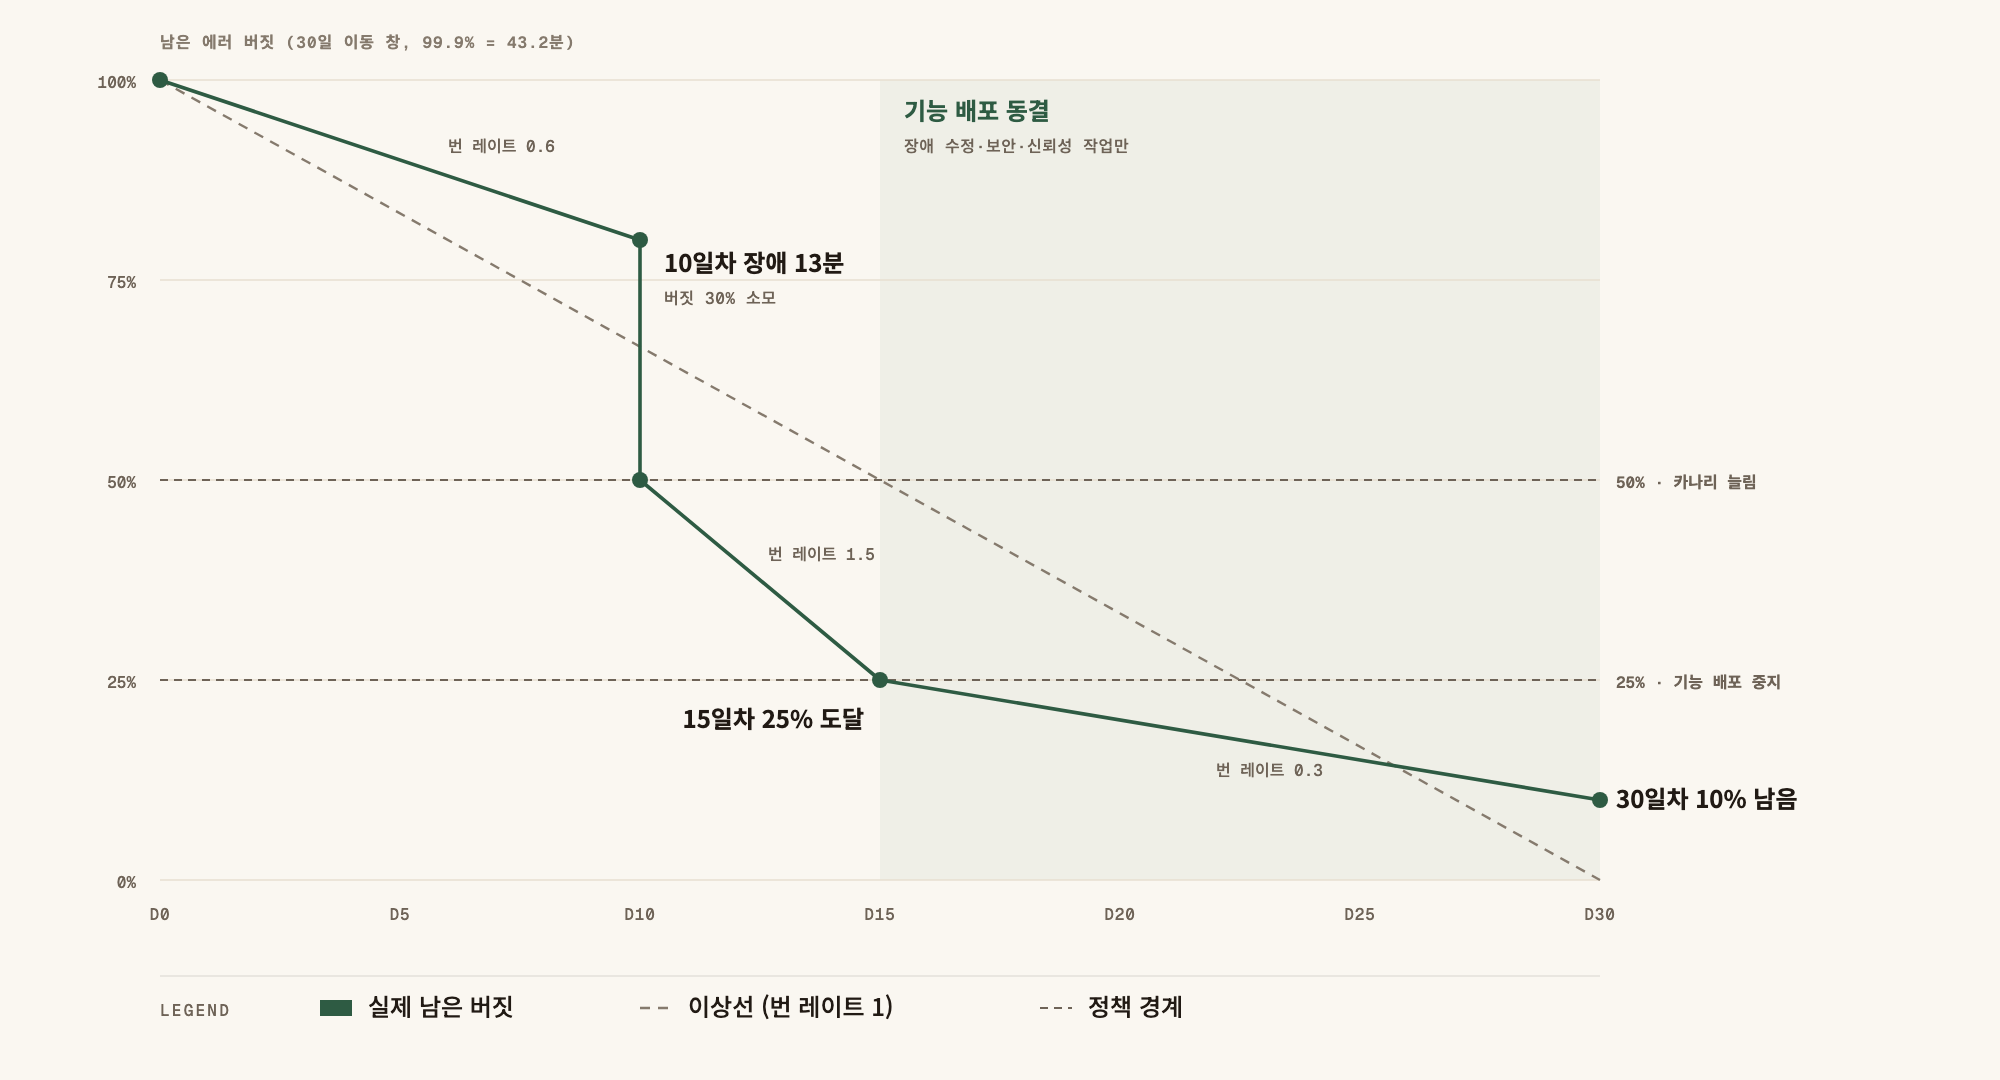
그래프는 이 글 전체의 예시다. 10일차 장애로 버짓이 크게 줄고, 남은 버짓이 25%에 닿은 15일차부터 기능 배포를 멈춰 기간 끝까지 버짓을 지킨다.
SLI와 SLO: 무엇을 셀지 먼저 정한다
SLI(Service Level Indicator)는 사용자가 느끼는 품질을 비율로 센 값이다. "좋은 이벤트 ÷ 전체 이벤트"로 쓰면 버짓 계산이 단순해진다.
- 가용성 SLI: 5xx가 아닌 응답 수 ÷ 전체 요청 수. 4xx는 사용자 입력 문제라 보통 빼지만, 우리 버그로 나는 4xx가 있으면 따로 정한다.
- 지연 SLI: 300ms 안에 끝난 요청 수 ÷ 전체 요청 수. 평균이 아니라 기준 안에 든 비율로 센다. 이유는 P95와 P99가 평균 응답 시간보다 중요한 이유 글에 정리했다.
SLO(Service Level Objective)는 SLI의 목표와 측정 기간이다. "30일 이동 창에서 가용성 99.9%"처럼 기간을 꼭 붙인다. 기간이 없으면 버짓이 언제 다시 차는지 정할 수 없다. 측정 지표를 Micrometer와 Prometheus로 남기는 방법은 Prometheus·Grafana·Micrometer로 SLO 모니터링 구축 글에 있다.
100%는 SLO가 아니다. 버짓이 0이 되어 어떤 변경도 할 수 없고, 사용자 단말·통신망처럼 우리가 통제하지 못하는 실패만으로도 이미 어긴다.
에러 버짓 계산: 시간 기준과 요청 기준
버짓은 1 − SLO다. 99.9%면 0.1%를 실패해도 된다.
시간 기준: 30일은 43,200분이다. 그 0.1%인 43.2분이 한 달 동안 전면 장애로 쓸 수 있는 시간이다. 99.95%면 21.6분, 99.99%면 4.32분으로 줄어든다. 9를 하나 더 붙이면 버짓은 10분의 1이 된다.
요청 기준: 30일 동안 요청이 1,200만 건이면 0.1%인 12,000건까지 실패해도 된다. 같은 10분 장애라도 트래픽이 낮은 새벽에 나면 실패 요청이 적어 버짓을 덜 쓴다. 사용자가 실제로 겪은 실패와 맞으므로 요청이 많은 API에는 요청 기준을 권한다.
| SLO | 30일 버짓(시간) | 요청 1,200만 건일 때 허용 실패 |
|---|---|---|
| 99% | 7시간 12분 | 120,000건 |
| 99.9% | 43.2분 | 12,000건 |
| 99.95% | 21.6분 | 6,000건 |
| 99.99% | 4.32분 | 1,200건 |
이동 창(rolling window)은 매일 가장 오래된 하루가 빠지고 새 하루가 들어온다. 달력 월 기준보다 "월초에 버짓이 갑자기 다시 찬다"는 착시가 없다.
번 레이트: 버짓을 쓰는 속도
번 레이트(burn rate)는 현재 오류율 ÷ 허용 오류율이다. 99.9% SLO에서 오류율이 0.1%면 번 레이트 1이고, 30일이 끝날 때 버짓을 딱 다 쓴다. 오류율이 1.44%면 번 레이트 14.4이고, 720시간 ÷ 14.4 = 50시간 만에 버짓이 바닥난다.
어떤 창에서 쓴 버짓 비율은 번 레이트 × 창 길이 ÷ 30일이다. 번 레이트 14.4로 1시간이면 14.4 × 1 ÷ 720 = 2%를 쓴다. 이 식으로 "몇 시간 안에 버짓 몇 %를 쓰면 깨울 것인가"를 거꾸로 정한다.
다중 창·다중 번 레이트 경보
Google의 『The Site Reliability Workbook』 "Alerting on SLOs" 장은 긴 창과 짧은 창을 함께 보는 경보를 권한다. 긴 창은 잠깐 튄 오류에 울리지 않게 하고, 짧은 창(긴 창의 12분의 1)은 장애가 끝나면 경보가 몇 분 안에 꺼지게 한다.
| 심각도 | 긴 창 | 짧은 창 | 번 레이트 | 오류율(99.9% 기준) | 긴 창 동안 쓰는 버짓 | 이대로면 바닥까지 |
|---|---|---|---|---|---|---|
| 호출(page) | 1시간 | 5분 | 14.4 | 1.44% | 2% | 약 50시간 |
| 호출(page) | 6시간 | 30분 | 6 | 0.6% | 5% | 5일 |
| 티켓 | 3일 | 6시간 | 1 | 0.1% | 10% | 30일 |
Prometheus 규칙 예시다. 지표 이름은 Spring Boot Micrometer 기본값(http_server_requests_seconds_count)을 가정했다.
groups:
  - name: order-api-slo
    rules:
      - record: job:slo_errors_per_request:ratio_rate5m
        expr: |
          sum by (job) (rate(http_server_requests_seconds_count{job="order-api", status=~"5.."}[5m]))
          /
          sum by (job) (rate(http_server_requests_seconds_count{job="order-api"}[5m]))
      # 30m, 1h, 6h, 3d, 30d 도 범위([5m])와 이름만 바꿔 같은 모양으로 만든다

      - record: job:error_budget_remaining:ratio
        expr: 1 - job:slo_errors_per_request:ratio_rate30d / 0.001

      - alert: OrderApiBudgetBurnFast
        expr: |
          job:slo_errors_per_request:ratio_rate1h > (14.4 * 0.001)
          and
          job:slo_errors_per_request:ratio_rate5m > (14.4 * 0.001)
        labels:
          severity: page
        annotations:
          summary: "order-api가 1시간에 에러 버짓 2% 이상을 쓰고 있다"

      - alert: OrderApiBudgetBurnSlow
        expr: |
          job:slo_errors_per_request:ratio_rate6h > (6 * 0.001)
          and
          job:slo_errors_per_request:ratio_rate30m > (6 * 0.001)
        labels:
          severity: page
0.001은 99.9% SLO의 허용 오류율이다. 30일 창 계산은 무거우므로 실제로는 별도 그룹에 interval: 5m처럼 평가 주기를 늘려 둔다. 요청이 하나도 없는 창에서는 0 ÷ 0이 되어 결과가 NaN이 나오고, 비교식은 거짓이 되어 경보가 울리지 않는다.
에러 버짓 정책 문서
버짓 숫자만 있고 "다 쓰면 무엇을 하는지"가 없으면 아무 일도 일어나지 않는다. 정책은 장애가 나기 전에, 서비스 책임자와 개발 리드와 SRE가 함께 서명해 둔다. 장애 중에 정하면 그때 급한 쪽이 이긴다.
# 주문 API 에러 버짓 정책 (예시)
대상 SLO   : 30일 이동 창, 가용성 99.9%, 300ms 이하 응답 99%
남은 버짓 50% 이상 : 평소대로 배포
남은 버짓 25~50%  : 카나리 단계를 늘리고, 배포는 근무 시간에만
남은 버짓 0~25%   : 기능 배포 중지. 장애 수정·보안 패치·신뢰성 작업만 배포
버짓 초과(0% 미만) : 위 조건 유지 + 다음 스프린트 일부를 신뢰성 작업에 먼저 배정
포스트모템        : 장애 한 건이 30일 버짓의 20% 이상을 쓰면 작성
예외             : 보안 패치, 법정 기한이 있는 변경은 서비스 책임자 승인으로 배포
제외 대상         : 사전 공지한 계획 점검 시간은 버짓에서 뺀다
검토 주기         : 분기 1회, SLO가 너무 쉽거나 어려우면 숫자를 고친다
서명             : 서비스 책임자, 개발 리드, SRE 리드
Workbook의 예시 정책도 버짓을 다 쓰면 P0 버그와 보안 수정 말고는 변경을 멈추고, 큰 장애에는 포스트모템을 쓰도록 정한다. 구간 경계값(50%, 25%)은 팀이 정하는 값이다. 핵심은 구간마다 바뀌는 행동이 문장으로 적혀 있는 것이다.
동결은 벌이 아니다. 버짓이 줄었다는 것은 지금 속도로 바꾸면 사용자가 다친다는 신호이고, 남는 개발 시간을 테스트·롤백 자동화·용량 같은 신뢰성 작업으로 옮기라는 뜻이다.
배포 파이프라인에 버짓 게이트 걸기
정책을 사람이 기억해서 지키면 금요일 저녁에 깨진다. CD 파이프라인의 운영 배포 직전 단계에서 Prometheus HTTP API로 남은 버짓을 읽어 막는다.
#!/usr/bin/env bash
# deploy-gate.sh — 남은 에러 버짓으로 운영 배포를 허용하거나 막는다
set -euo pipefail
CHANGE_TYPE="${CHANGE_TYPE:-feature}"   # feature | fix | security
QUERY='job:error_budget_remaining:ratio{job="order-api"}'

REMAIN=$(curl -sf --get "$PROM_URL/api/v1/query" --data-urlencode "query=$QUERY" \
  | jq -r '.data.result[0].value[1] // empty')

case "$REMAIN" in
  ''|NaN|+Inf|-Inf) echo "버짓 값을 읽지 못함($REMAIN): 수동 승인 필요"; exit 1 ;;
esac

if [ "$CHANGE_TYPE" != "feature" ]; then
  echo "남은 버짓 $REMAIN, $CHANGE_TYPE 변경이라 통과"; exit 0
fi

if awk -v r="$REMAIN" 'BEGIN { exit !(r < 0.25) }'; then
  echo "남은 버짓 $REMAIN < 0.25: 기능 배포 동결 (정책 문서 참고)"; exit 1
fi
echo "남은 버짓 $REMAIN: 배포 허용"
- 값을 못 읽으면 막는다. Prometheus가 죽었을 때 게이트가 그냥 통과시키면 가장 위험한 순간에 정책이 꺼진다.
- 변경 유형은 커밋 라벨이나 PR 라벨에서 받는다. 장애 수정까지 막으면 버짓을 회복할 길이 없다.
- 게이트 결과를 배포 기록에 남긴다. 예외 승인이 몇 번 있었는지가 분기 검토의 근거가 된다.
카나리·롤백 같은 배포 방식 자체는 공공 SI 환경의 CI/CD 배포·백업·롤백 자동화 글에 정리했다. 버짓 게이트는 그 앞에서 "지금 배포해도 되는가"만 판단한다.
구성 요소별 역할
| 무엇을 | 누가 쓰나 | 없으면 생기는 일 |
|---|---|---|
| SLI·SLO 정의 | 서비스 책임자, 개발 리드 | 무엇이 장애인지 매번 다툰다 |
| 버짓 계산 규칙 | SRE | 대시보드마다 남은 버짓이 다르게 나온다 |
| 다중 창 번 레이트 경보 | 당직자 | 짧은 오류에 자주 깨고, 느린 소모는 놓친다 |
| 에러 버짓 정책 | 팀 전체, 서명자 | 버짓을 다 써도 아무것도 바뀌지 않는다 |
| 배포 게이트 | CD 파이프라인 | 정책이 바쁜 날 무시된다 |
자주 하는 실수
SLO를 99.99%처럼 높게 잡는다. 한 달 버짓이 4.32분이라 배포 한 번의 롤백 시간만으로 바닥난다.
고정 오류율로 경보를 건다. "1% 넘으면 알림"은 SLO와 연결되지 않아 잠깐 튄 오류에 깨고, 0.3%로 며칠 새는 소모는 놓친다.
정책 없이 대시보드만 만든다. 버짓이 0이 되어도 정해진 행동이 없으면 숫자는 구경거리가 된다.
동결이 풀린 날 쌓인 변경을 한꺼번에 배포한다. 바뀐 것이 많을수록 장애 원인을 찾기 어렵고, 회복한 버짓을 다시 잃는다. 작은 단위로 나눠 내보낸다.
의존 서비스 장애와 계획 점검을 버짓에 넣을지 정하지 않는다. 장애 뒤에 "이건 우리 탓이 아니니 빼자"는 다툼이 생긴다. 정책 문서에 미리 적는다.
점검표
- SLI가 "좋은 이벤트 ÷ 전체 이벤트" 비율로 정의되어 있다
- SLO에 측정 기간(예: 30일 이동 창)이 붙어 있다
- 시간 기준인지 요청 기준인지 정했고, 계산식이 문서에 있다
- 남은 버짓을 Prometheus recording rule 하나로 계산하고 모든 화면이 그 값을 쓴다
- 경보가 긴 창과 짧은 창 번 레이트를 함께 본다
- 버짓 구간마다 배포 행동이 정책 문서에 문장으로 적혀 있다
- 정책 문서에 서비스 책임자·개발 리드·SRE가 서명했다
- CD 파이프라인이 운영 배포 전에 남은 버짓을 읽고, 값을 못 읽으면 막는다
- 장애 수정·보안 패치는 게이트를 통과하는 경로가 있다
- 분기마다 SLO 숫자와 예외 승인 횟수를 검토한다
에러 버짓은 "얼마나 실패해도 되는가"를 미리 합의해 두고, 그 합의를 경보와 배포 게이트로 자동 집행해서 배포 속도와 안정성의 다툼을 숫자 하나로 정리하는 방법이다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.