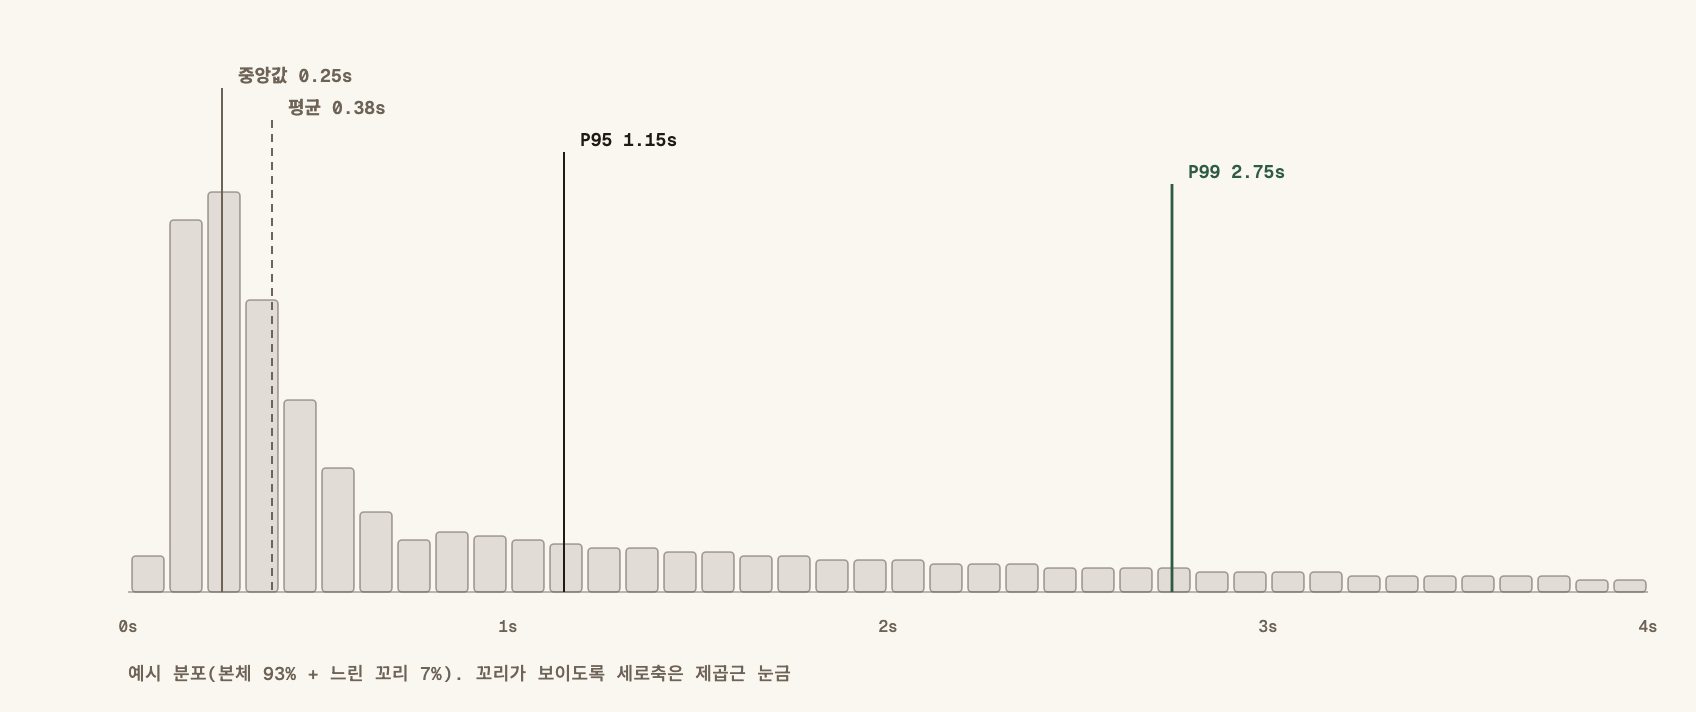
"평균 응답 시간 0.3초"라는 보고서는 사용자 100명 중 5명이 4초를 기다렸다는 사실을 숨길 수 있다. 응답 시간 분포는 오른쪽으로 긴 꼬리를 갖고, 장애와 민원은 그 꼬리에서 나온다. 이 글은 평균이 왜 사용자 경험을 대변하지 못하는지, P95·P99를 어떻게 재고 합치고 목표로 삼아야 하는지를 정리한 것이다.
평균은 꼬리를 숨긴다
요청 100건 중 95건이 0.1초, 5건이 4초 걸렸다고 하자.
| 지표 | 값 | 읽는 법 |
|---|---|---|
| 평균 | 0.295초 | 모두가 0.3초 안에 끝난 것처럼 보인다 |
| P50(중앙값) | 0.1초 | 절반은 0.1초 안에 끝났다 |
| P95 | 0.1~4초 경계 | 95%까지는 빠르다(여기서 꼬리가 시작) |
| P99 | 4초 | 100명 중 1명은 4초를 기다렸다 |
평균은 극단값 몇 개에 끌려가면서도 그 극단값이 얼마나 나쁜지는 보여 주지 않는다. 퍼센타일 Pn은 "요청의 n%가 이 시간 안에 끝났다"는 뜻이라, 느린 쪽에 있는 사용자가 실제로 겪은 시간을 그대로 드러낸다.
사용자는 꼬리를 더 자주 만난다
화면 하나는 보통 여러 API를 부르고, API 하나는 다시 여러 내부 호출을 한다. 호출마다 1%의 확률로 P99만큼 느리다면, 호출이 많을수록 적어도 하나가 느릴 확률이 커진다.
| 화면 하나가 기다리는 호출 수 | 적어도 하나가 P99 이상일 확률 |
|---|---|
| 1 | 1% |
| 10 | 약 9.6% |
| 50 | 약 39.5% |
| 100 | 약 63.4% |
계산은 1 − 0.99^N이다. 내부 호출이 50번인 화면이라면 사용자 열 명 중 네 명이 P99의 지연을 겪는다. 대규모 서비스에서 꼬리 지연이 전체 경험을 지배한다는 이 현상은 Google의 Dean과 Barroso가 "The Tail at Scale"(2013)에서 정리했다. P99는 드문 사용자의 이야기가 아니다.
꼬리는 어디서 생기나
- 자원 대기: 커넥션 풀, 스레드 풀, 락이 잠깐 비지 않을 때
- GC 멈춤: JVM의 긴 가비지 컬렉션
- 캐시 miss: 평소엔 캐시에서, 가끔 DB에서
- 외부 연계: 다른 기관 API의 들쭉날쭉한 응답
- 배치·백업과 겹친 시간대: 같은 DB를 쓰는 무거운 작업
- 큰 요청: 특정 사용자의 데이터가 유난히 많은 경우
평균은 이런 원인이 생겨도 거의 움직이지 않는다. P99가 먼저 움직인다. 그래서 장애의 조기 경보로도 퍼센타일이 낫다.
퍼센타일을 제대로 재는 법
평균을 평균 내지 않듯, 퍼센타일도 평균 내지 않는다. 서버 4대의 P99를 각각 구해 평균하면 전체 P99가 아니다. 서버마다 히스토그램(구간별 요청 수)을 모으고, 합친 히스토그램에서 퍼센타일을 계산해야 한다. Prometheus의 히스토그램과 histogram_quantile, HdrHistogram 같은 도구가 이 방식을 쓴다.
# 5분 동안 모든 인스턴스의 요청을 합친 P99
histogram_quantile(0.99, sum by (le) (rate(http_server_requests_seconds_bucket[5m])))
측정 창을 정한다. 1분 P99와 1일 P99는 다른 숫자다. 모니터링은 짧은 창(1~5분), 목표 관리는 긴 창(1주·1개월)으로 본다.
부하 도구의 함정을 안다. 많은 부하 도구는 응답이 올 때까지 다음 요청을 보내지 않는다. 서버가 멈춘 동안 요청 자체가 덜 보내져, 느린 순간이 통계에서 빠진다(Gil Tene가 말한 coordinated omission). 일정한 도착률로 요청을 보내는 방식으로 시험하거나, 이 보정을 하는 도구를 쓴다.
표본 수를 확인한다. 요청이 200건이면 P99는 가장 느린 두 건으로 정해진다. 퍼센타일은 충분한 요청 수가 있을 때만 의미가 있다.
목표(SLO)는 퍼센타일로 쓴다
| 나쁜 목표 | 좋은 목표 |
|---|---|
| 평균 응답 시간 1초 이내 | 조회 API 응답 P95 1초 이내, P99 3초 이내(5분 창), 오류율 0.1% 미만 |
| 빠른 응답 | 피크 시간 동시 사용자 2,000명에서 위 기준 유지 |
- P95는 "대부분 사용자의 체감", P99는 "꼬리 관리"를 맡긴다.
- 화면·API 성격별로 다르게 둔다. 로그인과 대용량 보고서를 같은 기준으로 묶지 않는다.
- 오류율을 함께 둔다. 타임아웃으로 실패한 요청을 빼면 퍼센타일이 좋아 보인다.
대시보드에 무엇을 올릴까
- 처리량, 오류율, P50·P95·P99를 같은 시간축에 둔다.
- 평균은 빼거나 작게 둔다. 평균이 크게 보이면 의사결정이 평균을 따라간다.
- P99 경보는 짧은 창의 일시적 튐에 울리지 않게 "5분 연속 기준 초과"처럼 지속 조건을 붙인다.
- 느린 요청 몇 건은 추적(트레이스)으로 바로 열어 볼 수 있게 연결한다.
자주 하는 실수
- 보고서에 평균만 쓴다. 꼬리의 민원과 장애가 숫자에서 사라진다.
- 서버별 P99를 평균한다. 실제 P99보다 낮게 나온다.
- 실패한 요청을 빼고 퍼센타일을 계산한다. 가장 나쁜 경험이 통계에서 지워진다.
- 표본이 적은데 P99를 말한다. 한두 건이 숫자를 결정한다.
- 모든 API에 같은 목표를 건다. 무거운 기능은 늘 실패하고, 가벼운 기능의 퇴보는 안 보인다.
점검표
- 성능 목표가 P95·P99와 오류율로 적혀 있다
- 목표마다 측정 창과 부하 조건이 정해져 있다
- 퍼센타일은 히스토그램을 합쳐서 계산한다
- 실패한 요청도 응답 시간 통계에 들어간다
- 부하 시험이 coordinated omission을 고려한다
- 대시보드에 P50·P95·P99와 처리량·오류율이 함께 있다
- P99 경보에 지속 조건이 있다
- 느린 요청을 트레이스로 바로 열어 볼 수 있다
평균은 시스템이 대체로 어떤지를 말하고, P95·P99는 사용자가 실제로 무엇을 겪는지를 말한다. 목표와 보고서와 경보를 퍼센타일로 바꾸면, 숨어 있던 꼬리가 고칠 수 있는 문제로 드러난다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.