처리량이 10 TPS에서 막힌 시스템을 250 TPS까지 올리는 과정은 대개 하나의 묘수가 아니라 다섯 개쯤의 평범한 병목을 차례로 걷어내는 일이다. 이 글은 공공 SI에서 흔히 만나는 병목들로 재구성한 대표 사례를 따라가며, 어떤 지표로 병목을 찾고 무엇을 바꿨을 때 처리량이 얼마나 움직이는지를 단계별로 정리한 것이다. 특정 사업의 측정 기록이 아니라 흔한 패턴으로 만든 시나리오이며, 수치는 이해를 돕기 위한 예시다.
시나리오: 민원 조회 시스템
| 항목 | 내용 |
|---|---|
| 구성 | Nginx → Spring Boot(eGov 표준, MyBatis) → CUBRID, 외부 기관 연계 게이트웨이 |
| 문제 | 업무 시작 시간에 응답이 수 초로 늘고 타임아웃 발생 |
| 목표 | 동시 사용자 기준 200 TPS 이상, 응답 시간 95퍼센타일 1초 이내 |
| 측정 | 부하 도구로 계단식 부하, APM 트랜잭션 추적, DB 느린 쿼리 로그, 스레드 덤프 |
먼저 숫자 하나로 상황을 읽는다
처리량과 동시성, 응답 시간은 리틀의 법칙으로 묶인다.
처리량(TPS) ≈ 동시에 처리 중인 요청 수 ÷ 평균 응답 시간(초)
기준선 측정 결과는 이랬다.
| 지표 | 값 |
|---|---|
| 처리량 | 10 TPS |
| 평균 응답 시간 | 2.0초 |
| DB 커넥션 풀 | 20 / 20 (포화) |
| WAS CPU | 22% |
| 느린 쿼리 | 민원 목록 조회 1건이 2.4초, 실행 계획 FULL SCAN |
커넥션 20개가 요청 하나에 2초씩 잡혀 있으면 상한은 20 ÷ 2 = 10 TPS다. 측정값과 맞는다. CPU가 22%인데 처리량이 막혔다는 것은 서버가 바쁜 게 아니라 기다리고 있다는 뜻이다. 그래서 장비를 늘리는 대신 무엇을 기다리는지부터 찾는다.
개선 1: FULL SCAN 쿼리 (10 → 60 TPS)
APM 트레이스에서 요청 시간의 대부분이 민원 목록 쿼리였다. 조회 조건 컬럼에 인덱스가 없었고, 날짜 컬럼에 함수를 씌워 비교하고 있어 인덱스가 있어도 쓸 수 없는 형태였다.
-- 고치기 전: 컬럼에 함수를 씌워 인덱스를 못 쓴다
WHERE TO_CHAR(reg_dt, 'YYYYMMDD') = '20261029' AND status = 'R'

-- 고친 뒤: 범위 조건으로 바꾸고 (status, reg_dt) 복합 인덱스 추가
WHERE status = 'R' AND reg_dt >= '2026-10-29' AND reg_dt < '2026-10-30'
쿼리가 2.4초에서 0.15초로 줄자 커넥션이 빨리 돌아오면서 처리량이 60 TPS까지 올랐다. 인덱스를 추가할 때는 쓰기 성능과 저장 공간 영향도 함께 확인한다.
개선 2: 반복문 안의 쿼리 (60 → 110 TPS)
다음 병목은 쿼리 하나가 아니라 쿼리 수였다. 목록 20건을 읽은 뒤 건마다 신청인 정보와 첨부 개수를 따로 조회해 요청 하나에 쿼리가 41번 나갔다. 각각은 빨라도 왕복이 쌓인다.
- 신청인 정보는 목록 쿼리에 조인으로 합쳤다.
- 첨부 개수는 목록의 ID를 모아
IN조건 한 번으로 집계했다.
요청당 쿼리가 41번에서 2번으로 줄었다. 이후 API별 쿼리 수를 테스트에서 세어 기준을 넘으면 실패하게 했다.
개선 3: 트랜잭션 안의 외부 연계 (110 → 170 TPS)
처리량이 오르자 이번에는 신청 처리 API가 커넥션을 오래 잡았다. 트랜잭션 안에서 외부 기관 게이트웨이를 호출하고 있었고, 연계 응답이 0.5~1초 걸리는 동안 DB 커넥션과 행 락을 함께 잡고 있었다.
- DB 저장만 트랜잭션으로 묶고 커밋했다.
- 외부 연계는 커밋 뒤 이벤트로 처리하고, 실패하면 재시도 큐로 보냈다.
- 커넥션 대기가 줄어든 것을 확인한 뒤 DB 세션 여유를 보고 풀을 20개에서 40개로 늘렸다.
커넥션을 오래 잡던 원인을 먼저 없앤 뒤 풀을 두 배로 늘렸기 때문에, 동시에 처리하는 요청 수가 늘어난 만큼 처리량이 올랐다(40 ÷ 0.24초 ≈ 170). 순서가 반대면 안 된다. 느린 원인이 남아 있으면 커넥션 40개가 모두 기다리는 상태가 되고 DB 부하만 커진다.
개선 4: 매번 DB에서 읽던 코드 데이터 (170 → 220 TPS)
이 단계에서 DB 호출의 절반이 공통 코드, 메뉴, 기관 목록 같은 거의 바뀌지 않는 데이터였다. 이를 애플리케이션 로컬 캐시(변경 시 무효화)와 Redis로 옮겼다. 캐시는 Redis 장애 시 DB로 돌아가도록 만들고, 코드 변경 화면에서 저장할 때 해당 키를 지우게 했다.
개선 5: 운영에서 켜진 SQL 디버그 로그 (220 → 250 TPS)
마지막 몇십 TPS는 의외의 곳에 있었다. 운영 서버에서 SQL 바인딩 로그가 DEBUG로 켜져 있어 요청마다 수십 줄을 동기로 파일에 쓰고 있었다. 스레드 덤프에서 로그 출력 대기 스레드가 반복해서 보였다. 운영 로그 레벨을 INFO로 내리고 비동기 출력으로 바꾸자 250 TPS에서 목표 응답 시간을 만족했다.
단계별 결과
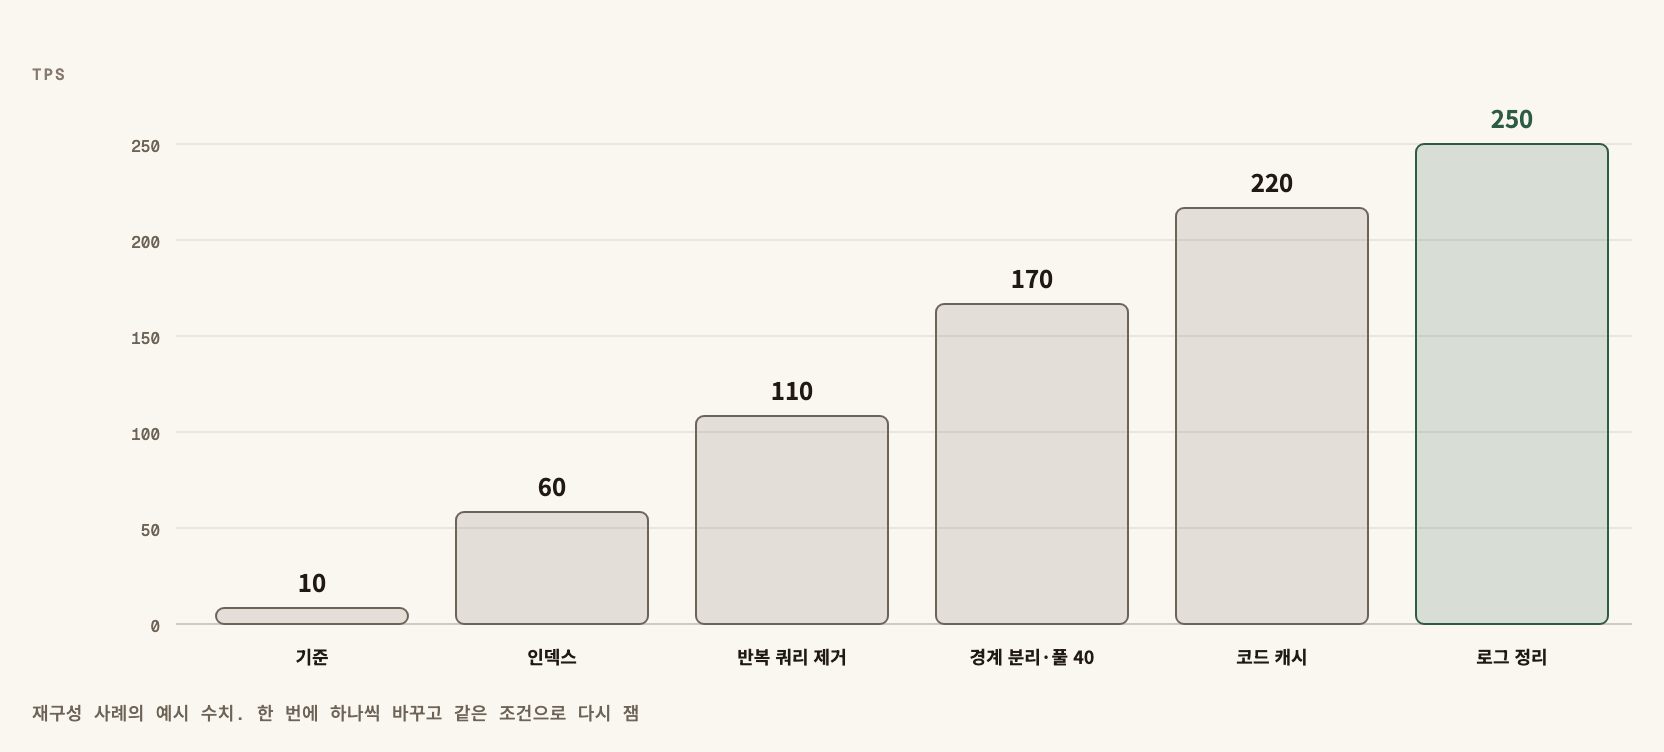
| 단계 | 바꾼 것 | 처리량(TPS) | 평균 응답 | 근거 지표 |
|---|---|---|---|---|
| 기준 | — | 10 | 2.0초 | 풀 포화, CPU 22%, FULL SCAN |
| 1 | 함수 제거 + 복합 인덱스 | 60 | 0.33초 | 느린 쿼리 0.15초 |
| 2 | 반복 쿼리를 조인·IN으로 | 110 | 0.18초 | 요청당 쿼리 41 → 2 |
| 3 | 외부 연계를 커밋 뒤로, 풀 40 | 170 | 0.24초 | 커넥션 대기 시간 감소 |
| 4 | 코드 데이터 캐시 | 220 | 0.18초 | DB 호출 절반 감소 |
| 5 | 로그 레벨·비동기 출력 | 250 | 0.16초 | 로그 대기 스레드 사라짐 |
이 과정에서 지킨 규칙
- 한 번에 하나만 바꾸고 다시 잰다. 두 개를 함께 바꾸면 어느 쪽이 효과였는지 모른다.
- 같은 조건으로 잰다. 데이터 양, 부하 패턴, 시험 시간을 고정한다.
- 평균만 보지 않는다. 처리량과 함께 응답 시간 95·99퍼센타일과 오류율을 본다.
- 장비는 마지막에 늘린다. CPU가 놀고 있는데 서버를 늘리면 기다리는 서버만 늘어난다.
- 병목은 옮겨 다닌다. 하나를 걷어내면 다음 병목이 드러난다. 목표에 닿을 때까지 측정 → 원인 → 조치를 반복한다.
자주 하는 실수
- 커넥션 풀부터 늘린다. 느린 쿼리가 남아 있으면 DB만 더 바빠진다.
- 개발 데이터로 성능을 본다. 수천 건에서는 FULL SCAN도 빠르다.
- APM 없이 감으로 고친다. 원인이 아닌 곳을 최적화하고 효과가 없다고 결론 낸다.
- 운영 로그 설정을 점검하지 않는다. 디버그 로그 하나가 처리량을 깎는다.
- 목표 없이 시작한다. 어디서 멈출지 모르면 개선이 끝나지 않는다.
점검표
- 목표 처리량과 응답 시간 퍼센타일을 먼저 정했다
- 기준선을 운영과 같은 데이터 양과 부하 패턴으로 쟀다
- 리틀의 법칙으로 "바쁜지, 기다리는지"를 먼저 판단했다
- APM 트레이스로 요청 시간이 어디서 쓰이는지 확인했다
- 느린 쿼리의 실행 계획을 확인했다
- 요청당 쿼리 수를 세고 기준을 정했다
- 트랜잭션 안에 외부 호출이 없다
- 변경은 하나씩, 매번 같은 조건으로 다시 쟀다
- 운영 로그 레벨과 출력 방식을 확인했다
10 TPS에서 250 TPS로 가는 길은 특별한 기술보다 순서에 달려 있다. 숫자로 병목을 찾고, 하나만 고치고, 다시 재는 일을 목표에 닿을 때까지 반복하면 된다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.