타임아웃, 재시도, Circuit Breaker, 이중화를 설계해 두어도 실제 장애가 났을 때 그대로 동작하는지는 장애가 나기 전까지 모른다. Chaos Engineering은 통제된 조건에서 일부러 장애를 주입해 그 설계가 정말 버티는지 확인하는 실험 방법이다. 이 글은 실험 원칙, 실험 설계서 양식, 중단 조건, 도구별 예시, 스테이징에서 운영까지 넓혀 가는 순서를 정리한다.
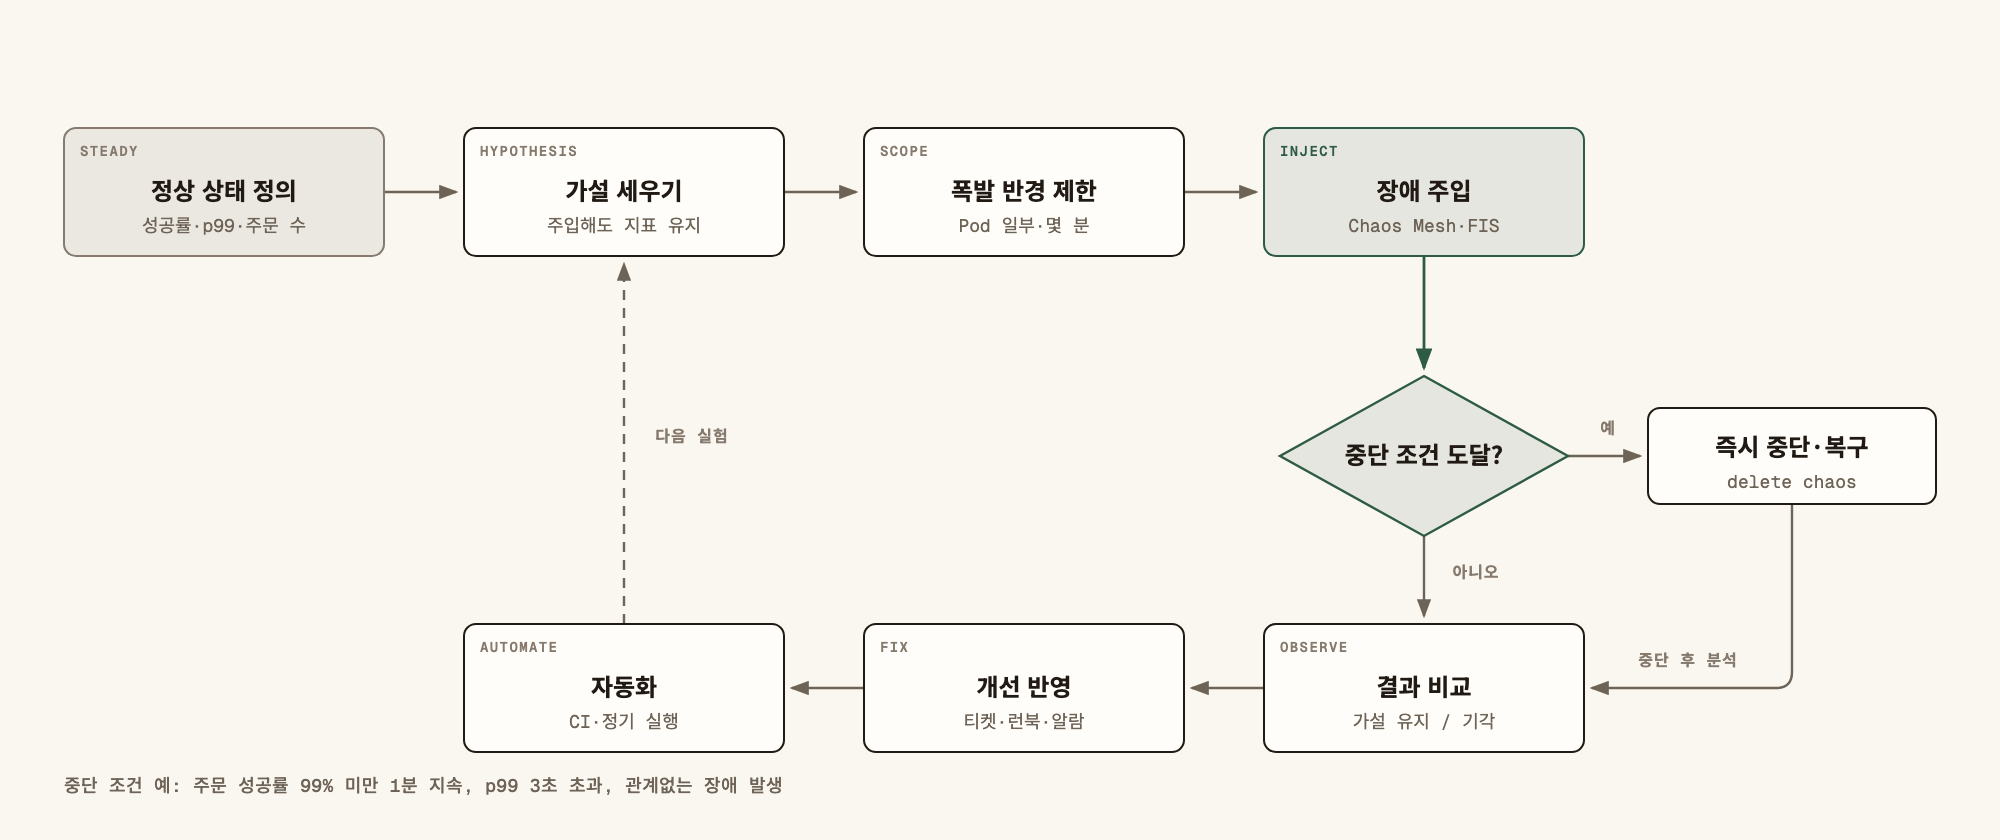
한눈에 보기
| 단계 | 할 일 | 남기는 것 |
|---|---|---|
| 정상 상태 정의 | 사용자 관점 지표와 기준값 정하기 | 지표 목록, 대시보드 |
| 가설 | "이 장애가 나도 지표는 유지된다" | 실험 설계서 |
| 반경 제한 | 대상·비율·시간 줄이기 | 대상 선택자, 실행 시간 |
| 주입과 관측 | 도구로 장애 주입, 지표 비교 | 실험 기록, 그래프 |
| 중단 판정 | 중단 조건에 걸리면 즉시 멈춤 | 중단 사유 |
| 개선 | 발견한 약점을 백로그로 | 개선 티켓, 런북 수정 |
| 자동화 | 통과한 실험을 정기 실행으로 | CI 작업, 일정 |
무작위 파괴가 아니라 실험이다
Chaos Engineering을 "운영 서버를 아무거나 끄는 것"으로 오해하는 경우가 많다. 실제로는 과학 실험과 같은 순서를 밟는다. 가설을 세우고, 변수 하나를 바꾸고, 결과를 측정하고, 가설이 틀렸으면 원인을 고친다.
공개 문서인 Principles of Chaos Engineering은 다섯 가지 원칙을 든다.
- 정상 상태를 기준으로 가설을 세운다. CPU 사용률 같은 내부 값보다 주문 성공 수, 로그인 성공률처럼 사용자가 느끼는 출력을 기준으로 삼는다.
- 실제로 일어나는 사건을 흉내 낸다. 서버 종료, 네트워크 지연, 디스크 가득 참, 외부 API 오류, 트래픽 급증처럼 과거 장애 기록에 있었던 일을 우선한다.
- 운영 환경에서 실험한다. 스테이징은 트래픽 모양, 데이터 양, 설정이 운영과 다르다. 다만 운영 실험은 아래 단계를 모두 거친 뒤에 한다.
- 자동화해 계속 돌린다. 한 번 통과한 실험도 배포가 쌓이면 다시 깨진다.
- 폭발 반경을 최소화한다. 고객 영향이 생겨도 작고 짧게 끝나도록 대상과 시간을 제한한다.
정상 상태와 가설 정하기
할 일
- 서비스당 정상 상태 지표 2~3개를 고른다. 예: 주문 API 성공률, p99 응답 시간, 분당 결제 완료 수.
- 지표마다 실험 중 허용 범위를 숫자로 적는다. 평소 범위를 모르면 지난 2주 그래프부터 본다.
- 가설은 반증할 수 있게 쓴다. "결제 API Pod 하나가 죽어도 주문 성공률은 99.5% 이상을 유지한다"처럼 쓰면 결과로 맞다·틀리다를 판정할 수 있다.
가설에 "괜찮을 것이다"만 있으면 실험이 끝나도 배운 것이 없다. 숫자가 없으면 판정할 수 없기 때문이다.
실험 설계서 양식
실험마다 한 장을 남긴다. 실행 전에 검토를 받고, 실행 뒤 결과 칸을 채운다.
실험 이름: payment-api 지연 300ms 주입
대상: shop 네임스페이스 payment-api Pod의 25%
가설: 결제 지연이 300ms 늘어도 주문 API p99는 1.5초 이하, 성공률 99.5% 이상
주입 방법: Chaos Mesh NetworkChaos (delay 300ms, jitter 50ms)
실행 시간: 5분, 평일 14:00 (담당자 상주 시간)
중단 조건: 주문 성공률 99% 미만 1분 지속 / p99 3초 초과 / 담당자 판단
중단 방법: kubectl delete networkchaos payment-delay -n shop
관측: 주문 대시보드, payment-api 오류 로그, 트레이스
참여: 실행 1명, 관측 1명, 서비스 담당 1명
결과: (실행 후 작성) 가설 유지/기각, 발견한 약점, 개선 티켓
숫자는 예시다. 기준값은 서비스의 SLO에서 가져온다.
중단 조건과 폭발 반경
실험의 안전은 주입보다 멈추는 쪽에서 나온다.
중단 조건
- 사용자 지표가 허용 범위를 일정 시간 넘으면 멈춘다. 순간 튐에 멈추지 않도록 지속 시간을 붙인다.
- 실험과 관계없는 장애가 나면 멈춘다. 두 장애가 겹치면 원인을 가를 수 없다.
- 자동 중단을 건다. AWS FIS는 실험 템플릿에 CloudWatch 경보를 중단 조건으로 걸 수 있다. Chaos Mesh는
duration이 지나면 주입이 끝나고, 리소스를 지우면 바로 복구된다. - 사람이 멈출 수 있는 명령을 설계서에 미리 적는다.
반경 줄이기
- 대상: 인스턴스 1대 또는 Pod 일부부터 시작한다.
- 트래픽: 카나리 구간이나 내부 사용자 트래픽에만 적용한다.
- 시간: 몇 분 단위로 짧게 잡는다.
- 시각: 담당자가 자리에 있고 배포가 없는 시간에 한다.
도구별 주입 예시
| 도구 | 주입 위치 | 맞는 경우 |
|---|---|---|
| Chaos Mesh | Kubernetes CRD (Pod, 네트워크, IO, 시간) | Kubernetes 위 서비스 |
| LitmusChaos | Kubernetes CRD (ChaosEngine), 프로브로 판정 | 실험 결과를 프로브로 자동 판정하고 싶을 때 |
| AWS FIS | AWS 관리형 (EC2, ECS, EKS, RDS 등) | AWS 자원 수준 장애, 경보 연동 중단 |
| Toxiproxy | 애플리케이션과 의존성 사이 TCP 프록시 | 로컬·통합 테스트에서 DB·Redis 지연 재현 |
Chaos Mesh로 결제 API Pod의 25%에 5분 동안 지연을 넣는 예다.
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata:
  name: payment-delay
  namespace: shop
spec:
  action: delay
  mode: fixed-percent
  value: "25"
  selector:
    namespaces:
      - shop
    labelSelectors:
      app: payment-api
  delay:
    latency: "300ms"
    jitter: "50ms"
    correlation: "0"
  duration: "5m"
운영 전 단계에서는 Toxiproxy로 같은 상황을 테스트 코드 안에서 만든다. 애플리케이션이 Redis 대신 프록시 포트를 보게 한 뒤 지연을 건다.
toxiproxy-cli create -l localhost:26379 -u localhost:6379 redis
toxiproxy-cli toxic add -t latency -a latency=1000 redis
이렇게 하면 "Redis가 1초 늦게 응답할 때 캐시 조회 타임아웃이 걸리고 DB로 넘어가는가"를 CI에서 매번 확인할 수 있다. 도구의 필드와 옵션은 버전마다 달라질 수 있으니 쓰는 버전의 공식 문서로 확인한다.
GameDay 운영
GameDay는 팀이 모여 정해진 시나리오로 장애를 주입하고 대응까지 연습하는 날이다. 도구 검증과 함께 사람과 절차를 검증한다.
할 일
- 시나리오 2~3개를 미리 정한다. 과거 장애 회고에서 고르면 현실성이 높다.
- 역할을 나눈다. 진행자, 주입 담당, 관측 담당, 대응 담당, 기록 담당.
- 대응 담당에게 시나리오를 미리 알리지 않는 회차를 둔다. 알람이 울리는지, 런북을 찾아가는지 확인하려는 것이다.
- 끝나면 바로 회고한다. 알람 지연, 대시보드에 없던 지표, 틀린 런북 단계를 기록한다.
산출물
- 시나리오별 타임라인(주입, 알람, 인지, 조치, 복구 시각)
- 개선 티켓 목록과 담당자
스테이징에서 운영까지 넓히는 순서
| 단계 | 환경 | 반경 | 넘어가는 기준 |
|---|---|---|---|
| 1 | 로컬·CI (Toxiproxy) | 테스트 한 건 | 타임아웃·대체 경로 테스트 통과 |
| 2 | 스테이징 | 서비스 1개 | 설계서 가설 유지, 중단 절차 연습 완료 |
| 3 | 운영 GameDay | Pod 일부, 짧은 시간 | 사용자 지표 영향이 중단 조건 안 |
| 4 | 운영 정기 실행 | 자동, 소규모 | 자동 중단 검증, 실패 시 알림 |
단계를 건너뛰지 않는다. 스테이징에서 중단 절차를 연습하지 않은 실험을 운영에서 처음 돌리면, 멈추는 방법을 장애 중에 찾게 된다.
발견을 개선으로 연결하기
실험의 가치는 주입이 아니라 고친 결과에서 나온다. 가설이 깨졌다면 원인별로 갈래를 나눈다.
| 발견 | 고치는 곳 | 예 |
|---|---|---|
| 타임아웃 없음·과다 | 클라이언트 설정 | 외부 호출 타임아웃을 SLO 안으로 |
| 재시도 폭주 | 재시도 정책 | 지수 백오프, 재시도 예산 |
| 대체 경로 미동작 | Circuit Breaker, fallback | 실패율 임계값과 fallback 응답 |
| 알람 늦음 | 모니터링 | 사용자 지표 기준 경보 |
| 런북 틀림 | 운영 문서 | 실제 명령으로 단계 수정 |
Circuit Breaker와 fallback 설계는 서비스 장애 시 Graceful Degradation과 Circuit Breaker 설계에서, DB 이중화 전환 시 애플리케이션 쪽 복구는 CUBRID HA 장애 전환 시 애플리케이션 복구 전략에서 다뤘다. 고친 뒤에는 같은 실험을 다시 돌려 가설이 유지되는지 확인하고, 통과한 실험을 정기 실행 목록에 넣는다.
자주 하는 실수
정상 상태 없이 주입부터 한다. 비교할 기준이 없으면 장애가 영향을 줬는지 판정할 수 없다.
중단 조건을 말로만 정한다. 실험 중에는 "조금만 더 보자"는 판단이 나오기 쉬워서, 숫자와 지속 시간으로 미리 적어야 멈출 수 있다.
처음부터 운영 전체에 주입한다. 반경이 크면 실험이 곧 장애가 되고, 이후 실험 승인을 받기 어려워진다.
결과를 티켓으로 남기지 않는다. 약점을 찾고 고치지 않으면 같은 장애를 실제로 다시 겪는다.
한 번 통과로 끝낸다. 설정과 의존성이 바뀌면 복원력도 바뀌므로 정기 실행이 필요하다.
점검표
- 서비스마다 정상 상태 지표 2~3개와 허용 범위가 숫자로 있다.
- 가설이 맞다·틀리다로 판정할 수 있는 문장이다.
- 실험 설계서에 대상, 시간, 중단 조건, 중단 명령이 있다.
- 중단 조건 중 하나 이상은 자동으로 동작한다.
- 첫 실험의 대상은 인스턴스 1대 또는 Pod 일부다.
- 실행 시간에 서비스 담당자가 자리에 있다.
- 스테이징에서 같은 실험과 중단 절차를 먼저 해 봤다.
- 실험 기록에 주입·인지·복구 시각이 남는다.
- 깨진 가설마다 개선 티켓과 담당자가 있다.
- 통과한 실험이 정기 실행 목록에 있다.
Chaos Engineering은 장애를 일으키는 기술이 아니라, 정상 상태를 숫자로 정하고 작게 주입해 확인한 약점을 고치는 일을 반복해서 복원력을 증명하는 절차다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.