데이터 레이크는 싸고 크지만 파일 묶음이라 트랜잭션도 스키마 관리도 없고, 웨어하우스는 정확하지만 비싸고 한 엔진에 묶인다. 레이크하우스는 객체 스토리지의 Parquet 파일 위에 테이블 메타데이터 계층을 얹어 두 장점을 합치는 구조다. 이 글은 그 계층을 대표하는 Apache Iceberg가 메타데이터를 어떻게 쌓고, 커밋·Time Travel·파티션·행 단위 수정을 어떻게 처리하며, 운영에서 무엇을 정리해야 하는지 정리한다.
웨어하우스·레이크·레이크하우스 비교
| 구분 | 데이터 웨어하우스 | 데이터 레이크 | 레이크하우스 |
|---|---|---|---|
| 저장 | 엔진 전용 스토리지 | 객체 스토리지(S3 등) | 객체 스토리지 |
| 형식 | 엔진 내부 형식 | Parquet·JSON 파일 | Parquet + 테이블 메타데이터 |
| 트랜잭션 | 있음 | 없음 | 파일 단위 원자적 커밋 |
| 스키마 | 엄격 | 읽을 때 해석 | 버전으로 관리 |
| 엔진 | 한 제품 | 여러 엔진, 정합성 각자 | Spark·Flink·Trino가 같은 테이블 공유 |
| 약점 | 비용, 종속 | 깨진 파일, 일관성 없음 | 메타데이터 운영 부담 |
레이크하우스는 웨어하우스를 없애는 말이 아니다. 운영 DB와 분석 저장소를 나누는 이유는 OLTP와 OLAP 분리 글에 정리했다. 레이크하우스는 그 분석 쪽 저장소를 열린 형식으로 두는 선택이다.
오픈 테이블 포맷이 푸는 세 가지 문제
디렉터리를 테이블로 쓰는 Hive 방식에는 세 가지 구멍이 있다.
- 원자적 커밋이 없다. 작업이 파일 10개 중 6개를 쓰고 죽으면 읽는 쪽은 6개를 본다. 디렉터리 나열은 S3 같은 저장소에서 느리고, 쓰는 중인 파일까지 보인다.
- 스키마 진화가 위험하다. 컬럼을 이름이나 위치로 찾으니 이름을 바꾸거나 순서를 바꾸면 예전 파일을 잘못 읽는다.
- 동시 쓰기를 막지 못한다. 두 작업이 같은 파티션을 덮어쓰면 마지막 작업만 남거나 둘이 섞인다.
Iceberg는 "테이블에 속한 파일 목록"을 메타데이터 파일로 명시하고, 새 목록으로 바꾸는 순간을 한 번의 포인터 교체로 만든다. 컬럼은 이름이 아니라 고유 ID로 추적해서 이름 변경·삭제·추가가 예전 파일과 충돌하지 않는다. Delta Lake는 _delta_log 트랜잭션 로그로, Apache Hudi는 타임라인과 레코드 인덱스로 같은 문제를 푼다. 셋 중 Iceberg는 엔진 중립적인 명세와 카탈로그 표준(REST)을 강점으로 꼽는다.
Iceberg 메타데이터 계층과 카탈로그
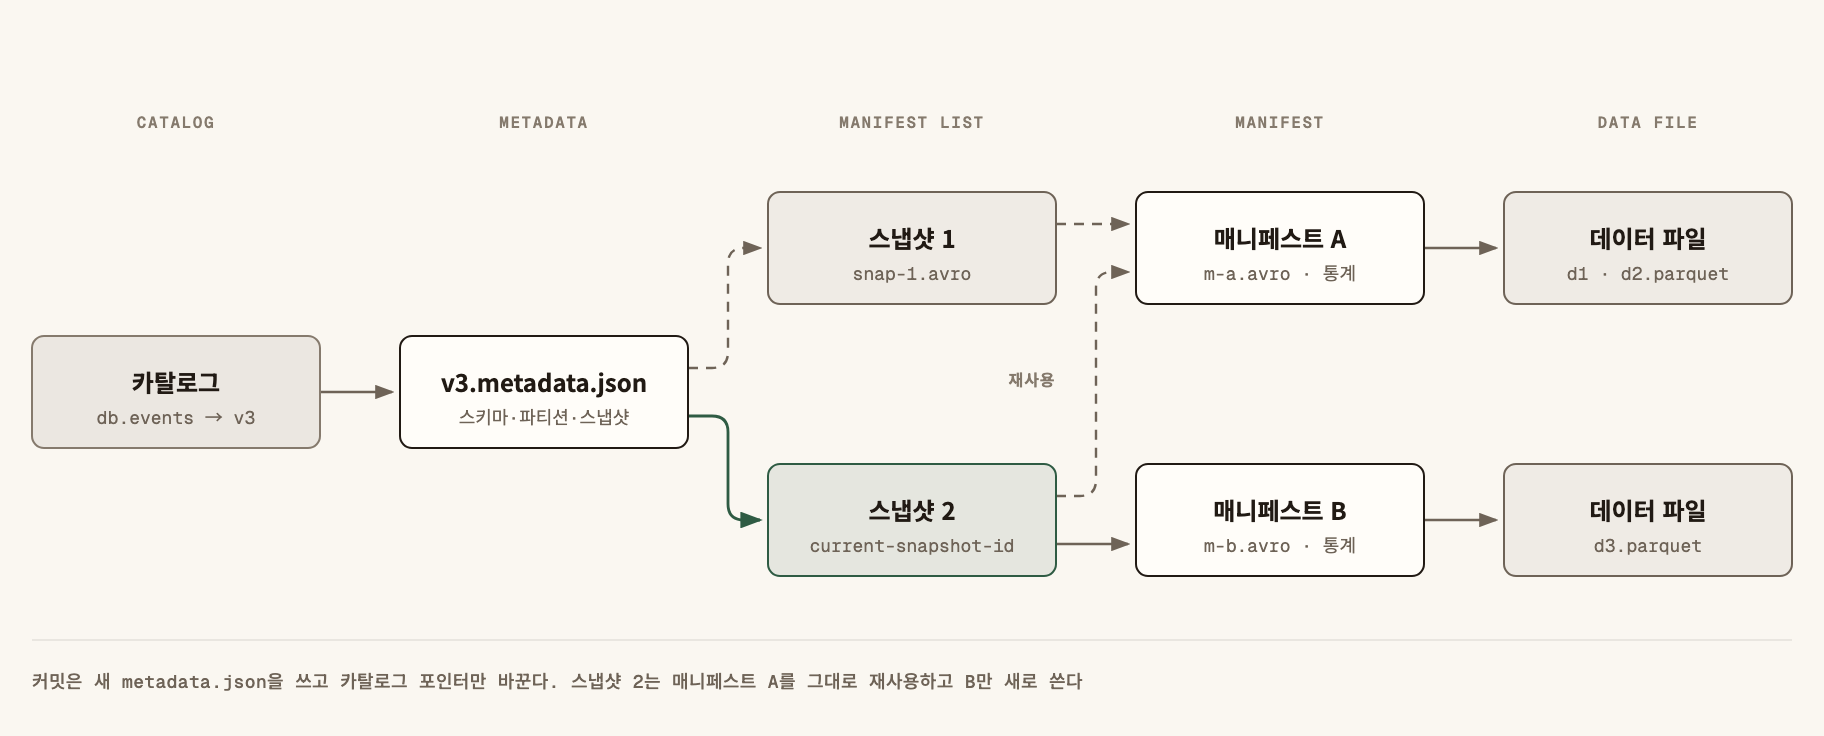
| 계층 | 담는 것 | 쓰임 |
|---|---|---|
| 카탈로그 | 테이블 이름 → 현재 metadata.json 위치 | 커밋 지점(포인터 교체) |
| metadata.json | 스키마, 파티션 스펙, 스냅샷 목록, 현재 스냅샷 ID | 테이블의 한 버전 |
| 매니페스트 리스트 | 스냅샷 하나가 쓰는 매니페스트와 파티션 범위 요약 | 파티션 단위 1차 가지치기 |
| 매니페스트 | 데이터·삭제 파일 경로, 컬럼별 최솟값·최댓값·null 수 | 파일 단위 2차 가지치기 |
| 데이터 파일 | Parquet·ORC·Avro 실제 행 | 읽기 |
새 스냅샷은 바뀐 매니페스트만 새로 쓰고 나머지는 재사용한다. 그래서 하루 1GB를 추가하는 커밋은 테이블 전체가 10TB여도 매니페스트 몇 개와 metadata.json 하나만 만든다. 쿼리 엔진은 디렉터리를 나열하지 않고 매니페스트의 통계로 읽을 파일을 고른다.
카탈로그는 이 구조의 맨 위다. REST catalog, Hive Metastore, AWS Glue, JDBC, Nessie 등이 있다. 여러 엔진이 같은 테이블을 쓰면 엔진마다 다른 카탈로그를 쓰지 않도록 하나로 정한다. 포인터가 둘이면 테이블도 둘이다.
커밋과 낙관적 동시성
쓰기 작업은 다음 순서로 커밋한다.
- 현재 metadata.json(기준 버전)을 읽는다.
- 새 데이터 파일과 매니페스트, 새 metadata.json을 쓴다. 이 단계에선 아무도 새 파일을 보지 않는다.
- 카탈로그에 "현재 포인터가 아직 기준 버전이면 새 버전으로 바꿔라"를 요청한다(compare-and-swap).
- 그사이 다른 커밋이 있었다면 최신 메타데이터를 다시 읽고, 내 변경이 그 커밋과 충돌하는지 검증한 뒤 다시 시도한다.
추가(append)끼리는 거의 충돌하지 않는다. 같은 파일을 지우거나 다시 쓰는 작업끼리, 예를 들어 압축(compaction)과 행 삭제가 같은 파일을 건드리면 한쪽이 실패한다. 재시도 횟수는 테이블 속성 commit.retry.num-retries로 정한다. 스트리밍 적재와 압축을 같이 돌리면 충돌이 잦으므로 압축은 파티션 단위로 나눠 커밋한다.
스냅샷, Time Travel, 스키마 진화
모든 커밋은 스냅샷으로 남는다. 과거 스냅샷을 그대로 읽을 수 있어 잘못 적재한 배치를 되돌리거나 지난주 보고서 숫자를 재현할 수 있다. Spark SQL 예시다.
-- 스냅샷 이력 보기
SELECT snapshot_id, committed_at, operation
FROM lake.db.events.snapshots
ORDER BY committed_at DESC;

-- 특정 스냅샷 또는 시각 기준으로 읽기
SELECT count(*) FROM lake.db.events VERSION AS OF 5937117119577207000;
SELECT count(*) FROM lake.db.events TIMESTAMP AS OF '2026-11-04 09:00:00';

-- 잘못 들어간 커밋 이전으로 되돌리기
CALL lake.system.rollback_to_snapshot('db.events', 5937117119577207000);
스키마 변경도 메타데이터만 바꾼다. 컬럼 추가·삭제·이름 변경·순서 변경, int→long 같은 넓히는 형변환은 파일을 다시 쓰지 않는다. 다만 소비자가 쓰는 컬럼을 지우는 일은 포맷이 막아 주지 않는다. 이 약속은 Data Contract 글처럼 별도로 검증한다.
Hidden Partitioning과 Partition Evolution
Hive 방식은 dt 같은 파티션 컬럼을 따로 만들고, 쿼리가 WHERE dt = '2026-11-04'를 직접 써야 가지치기가 된다. ts로만 거르면 전체를 읽는다. Iceberg는 원본 컬럼에 변환 함수를 걸어 파티션을 정의한다.
CREATE TABLE lake.db.events (
  event_id   BIGINT,
  user_id    BIGINT,
  event_type STRING,
  ts         TIMESTAMP
) USING iceberg
PARTITIONED BY (days(ts), bucket(16, user_id))
TBLPROPERTIES (
  'format-version' = '2',
  'write.merge.mode' = 'merge-on-read'
);

-- ts 조건만으로 파티션 가지치기
SELECT event_type, count(*)
FROM lake.db.events
WHERE ts >= TIMESTAMP '2026-11-04 00:00:00'
GROUP BY event_type;
데이터가 늘어 일 단위 파티션이 너무 커지면 파티션 스펙을 바꾼다. 기존 파일은 옛 스펙으로 남고 새로 쓰는 파일만 새 스펙을 따른다. 테이블을 다시 쓰지 않는다.
-- Spark에서 Iceberg SQL 확장(IcebergSparkSessionExtensions)이 켜져 있어야 한다
ALTER TABLE lake.db.events REPLACE PARTITION FIELD days(ts) WITH hours(ts);
이렇게 바꾸면 변경 전 파일은 일 단위로, 변경 뒤 파일은 시간 단위로 나뉜다. 쿼리는 그대로 ts로 거르고, 엔진이 두 스펙을 모두 가지치기한다.
Copy-on-Write와 Merge-on-Read
UPDATE·DELETE·MERGE가 들어오면 두 방식 중 하나로 처리한다. 테이블 속성 write.delete.mode, write.update.mode, write.merge.mode에 copy-on-write 또는 merge-on-read를 지정한다.
| 방식 | 쓰기 | 읽기 | 맞는 경우 |
|---|---|---|---|
| Copy-on-Write | 바뀐 행이 든 파일 전체를 다시 쓴다 | 추가 작업 없음 | 수정이 드물고 읽기가 많은 배치 테이블 |
| Merge-on-Read | 삭제 파일(position·equality delete)만 쓴다 | 데이터 파일과 삭제 파일을 합쳐 읽는다 | CDC처럼 수정이 잦은 테이블 |
행 하나를 고치려고 512MB 파일을 다시 쓰는 일이 반복되면 Copy-on-Write는 쓰기 비용이 커진다. 반대로 Merge-on-Read는 삭제 파일이 쌓일수록 읽기가 느려지므로 주기적으로 압축해 삭제 파일을 데이터 파일에 합친다. CDC와 Debezium으로 받은 변경을 Iceberg에 반영하는 파이프라인이 대표적인 Merge-on-Read 사례다. 삭제 파일은 format v2부터 쓴다. v3의 deletion vector 지원 범위는 엔진별 공식 문서를 확인한다.
운영 유지보수: 작은 파일과 스냅샷 정리
Iceberg 테이블은 그냥 두면 커진다. Flink가 1분마다 커밋하고 버킷이 16개라면 하루에 스냅샷 1,440개, 파일이 최대 23,040개 생긴다(예시). 매니페스트와 metadata.json도 같이 늘어 계획 수립이 느려진다. Spark 프로시저로 정리한다.
-- 1) 작은 파일을 512MB 목표로 합치기, 파티션 그룹 단위로 나눠 커밋
CALL lake.system.rewrite_data_files(
  table => 'db.events',
  options => map('target-file-size-bytes', '536870912',
                 'partial-progress.enabled', 'true')
);

-- 2) 오래된 스냅샷 만료(참조가 끊긴 파일도 삭제)
CALL lake.system.expire_snapshots(
  table => 'db.events',
  older_than => TIMESTAMP '2026-10-29 00:00:00',
  retain_last => 20
);

-- 3) 어떤 스냅샷도 참조하지 않는 파일 삭제
CALL lake.system.remove_orphan_files(
  table => 'db.events',
  older_than => TIMESTAMP '2026-11-01 00:00:00'
);

-- 4) 매니페스트 재배치
CALL lake.system.rewrite_manifests('db.events');
| 작업 | 주기(예시) | 안 하면 생기는 일 |
|---|---|---|
rewrite_data_files |
매일, 스트리밍 테이블은 매시간 | 파일 열기 비용이 쿼리 시간을 차지한다 |
expire_snapshots |
매일 | 스토리지 비용이 끝없이 늘고 메타데이터가 무거워진다 |
remove_orphan_files |
매주 | 실패한 작업이 남긴 파일이 쌓인다 |
rewrite_manifests |
매주 또는 필요할 때 | 계획 수립이 매니페스트 수에 비례해 느려진다 |
순서도 중요하다. 압축 뒤에 만료를 돌려야 압축으로 대체된 옛 파일이 지워진다. 만료된 스냅샷으로는 Time Travel을 할 수 없으니 보존 기간은 감사·재현 요구에 맞춰 정한다.
자주 하는 실수와 점검표
자주 하는 실수
remove_orphan_files의older_than을 몇 분으로 둔다. 아직 커밋되지 않은 진행 중 작업의 파일까지 지워 데이터가 사라진다. 가장 긴 작업 시간보다 넉넉하게 둔다.- 스냅샷 만료를 한 번도 돌리지 않는다. 지운 행이 담긴 옛 파일이 계속 남아 개인정보 삭제 요구도 실제로는 지켜지지 않는다.
- 엔진마다 다른 카탈로그를 붙인다. 같은 경로를 가리켜도 포인터가 둘이면 커밋이 서로를 덮는다.
- Hive 습관대로
dt컬럼을 따로 만든다. Hidden Partitioning의 이점을 버리고 쿼리 작성자에게 파티션 조건을 다시 떠넘긴다. - CDC 테이블에 Copy-on-Write를 쓴다. 작은 수정마다 큰 파일을 다시 써서 적재가 밀린다.
점검표
- 모든 엔진이 같은 카탈로그 하나로 테이블을 찾는다.
- 테이블이
format-version2 이상이고 수정 패턴에 맞는 쓰기 모드가 지정돼 있다. - 파티션은 변환 함수(
days,hours,bucket)로 정의했고 별도 파티션 컬럼이 없다. - 압축 작업이
partial-progress.enabled로 나눠 커밋한다. -
expire_snapshots가 매일 돌고 보존 기간이 문서로 정해져 있다. -
remove_orphan_files의 기준 시각이 가장 긴 쓰기 작업보다 길다. - Merge-on-Read 테이블의 삭제 파일 수를
files메타데이터 테이블로 감시한다. - 잘못된 적재를
rollback_to_snapshot으로 되돌리는 절차를 한 번 연습했다. - 컬럼 삭제·형변환 전에 소비자 계약을 확인한다.
Iceberg는 파일 위에 버전이 매겨진 메타데이터 계층을 얹어 레이크를 테이블로 만들지만, 그 계층을 정리하는 일까지 해야 레이크하우스가 웨어하우스만큼 믿을 만해진다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.