벡터 검색의 지연 시간과 정확도는 대부분 인덱스 하나로 정해지고, 지금 가장 널리 쓰이는 인덱스가 HNSW(Hierarchical Navigable Small World)다. 이 글은 Malkov와 Yashunin의 논문(2016년 arXiv 공개, 2018년 IEEE TPAMI 게재)이 정리한 HNSW의 층 배정, 탐색, 삽입 규칙을 따라가고, M·efConstruction·ef_search를 바꿀 때 무엇을 얻고 잃는지, pgvector에서 어떻게 쓰고 재는지를 정리한다.
한눈에 보기
| 단계 | 하는 일 | 좌우하는 값 |
|---|---|---|
| 층 배정 | 새 벡터의 최고 층을 지수 분포로 뽑는다 | mL = 1/ln(M) |
| 삽입 | 위층부터 내려오며 이웃 후보를 찾고 M개를 골라 양방향으로 잇는다 | M, efConstruction |
| 탐색 | 위층은 greedy로 건너고, 0층에서 후보 ef개를 유지하며 훑는다 | ef_search |
| 결과 | 후보 중 가까운 k개를 돌려준다. 정답 보장은 없다 | recall@k로 잰다 |
정확한 kNN은 왜 비싼가
정확한 k-최근접 이웃(kNN)은 질의 벡터와 모든 벡터의 거리를 계산한다. 768차원 벡터 100만 개라면 질의 한 번에 곱셈·덧셈이 7억 6,800만 번이고, float32 원본만 3,072MB를 매번 읽는다. 데이터가 10배 늘면 비용도 10배 는다.
그래서 벡터 DB는 근사 최근접 이웃(ANN)을 쓴다. 정답 일부를 놓칠 수 있는 대신 전체의 일부만 보고 답한다. 놓치는 비율은 recall로 재고, 그 값을 얼마로 둘지는 서비스가 정한다. RAG처럼 뒤에 리랭킹이 붙으면 1차 검색 recall이 조금 낮아도 되는 경우가 많다. 이 구성은 Hybrid Search와 Reranking 글에서 다뤘다.
계층 구조: NSW에 skip list를 얹다
HNSW의 바탕은 NSW(Navigable Small World) 그래프다. 각 벡터가 가까운 벡터 몇 개와 링크로 이어져 있고, 탐색은 "이웃 중 질의에 더 가까운 점으로 옮겨 가기"를 더 이상 나아지지 않을 때까지 반복한다. 단층 NSW는 데이터가 커지면 출발점에서 목표까지 건너야 할 단계가 늘고, 연결이 많은 점에 탐색이 몰린다.
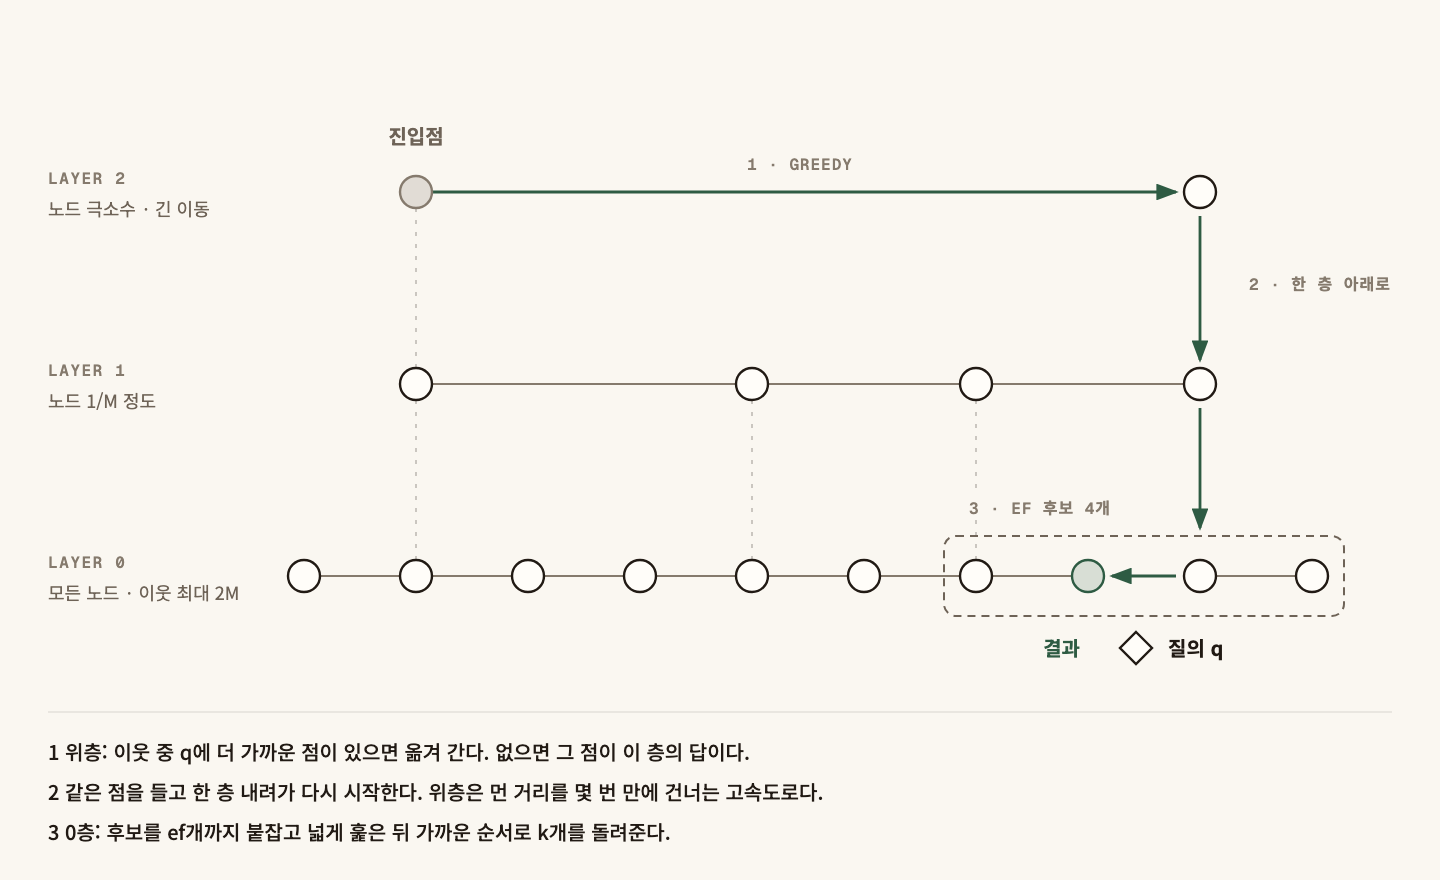
HNSW는 여기에 skip list의 생각을 더했다. 모든 벡터가 있는 0층 위에, 일부만 뽑은 1층, 그보다 더 적은 2층을 쌓는다. 위층은 점이 듬성하니 링크 하나가 먼 거리를 건넌다. 아래층으로 갈수록 점이 촘촘해져 세밀하게 접근한다. 고속도로로 근처 도시까지 가고 골목길로 집을 찾는 구조다.
층 배정. 새 벡터의 최고 층 l은 l = floor(-ln(U) × mL)로 뽑는다. U는 0과 1 사이 균등 난수, mL은 1/ln(M)이다. 이렇게 하면 l층 이상에 올라갈 확률이 M^(-l)이 된다. M=16, 벡터 100만 개라면 1층 이상은 약 62,500개, 2층 이상은 약 3,906개, 3층 이상은 약 244개, 4층 이상은 약 15개다. 층은 대략 log_M(N)개 생긴다.
탐색: 위층은 greedy, 0층은 ef 후보 목록
- 가장 높은 층에 있는 진입점(entry point) 하나에서 출발한다.
- 위층에서는 후보를 하나만 들고 greedy로 움직인다. 이웃 중 더 가까운 점이 없으면 그 점을 들고 한 층 내려간다.
- 0층에 오면 후보 목록 크기를 ef로 넓힌다. 가장 가까운 후보부터 이웃을 펼치고, 목록의 가장 먼 후보보다 가까운 점만 넣는다. 더 넣을 점이 없으면 멈춘다.
- 목록에서 가까운 k개를 돌려준다. 그래서 ef는 k 이상이어야 한다.
ef가 클수록 지역 최솟값에 갇힐 확률이 줄어 recall이 오르고, 거리 계산이 늘어 지연도 는다. 이 값은 질의마다 바꿀 수 있다는 점이 HNSW 운영의 핵심 손잡이다.
삽입: efConstruction과 이웃 선택 휴리스틱
새 벡터 q를 넣을 때도 탐색과 같은 길을 간다. 최고 층부터 q의 층까지는 greedy로 내려오고, q가 속한 층부터 0층까지는 층마다 후보를 efConstruction개 모은다. 그 후보에서 이웃 M개를 골라 양방향 링크를 건다. 링크가 늘어 이웃 수가 상한(위층 M, 0층 2M)을 넘은 기존 점은 다시 골라 줄인다.
이웃을 고르는 방법이 품질을 가른다. 단순히 가까운 순서로 M개를 고르면 한쪽 방향에 몰린 이웃만 남아 데이터 덩어리 사이를 건너는 길이 끊긴다. 논문의 휴리스틱은 후보를 가까운 순서로 보되, 후보 e와 q의 거리가 e와 이미 고른 이웃 각각의 거리보다 짧을 때만 받는다. 결과적으로 여러 방향으로 퍼진 이웃이 남고, 군집이 뚜렷한 데이터에서 recall이 덜 떨어진다.
efConstruction은 빌드 시간에만 영향을 준다. 크게 잡으면 그래프가 좋아지지만 빌드가 느려지고, 이미 만든 인덱스에는 다시 빌드하기 전까지 반영되지 않는다.
파라미터와 메모리 계산
| 값 | 올리면 좋아지는 것 | 대가 | pgvector 기본값 |
|---|---|---|---|
| M | recall, 고차원에서 길 찾기 | 메모리와 빌드 시간이 M에 비례해 는다 | 16 |
| efConstruction | 그래프 품질 → 같은 ef에서 recall | 빌드 시간. 질의 메모리는 그대로 | 64 |
| ef_search | 질의 recall | 질의 지연. 반환 행 수의 상한도 된다 | 40 |
메모리는 벡터 원본과 링크로 어림한다. 링크 ID를 4바이트로 보면 벡터 하나당 대략 차원 × 4 + 2M × 4 + 위층 링크다. 위층 링크는 평균 1/(M-1)개 층에 M개씩이라 M=16이면 4바이트 남짓이다. 768차원, M=16이면 3,072 + 128 + 4 ≈ 3,204바이트, 100만 개면 약 3.2GB다. 링크는 원본의 4% 정도이고 메모리의 대부분은 벡터 자체다. 실제 구현은 페이지·헤더 오버헤드가 붙으므로 이 값은 하한으로 본다.
그래서 메모리를 줄이려면 M보다 벡터 표현을 먼저 본다. pgvector의 halfvec(float16)은 원본을 절반으로, 양자화(SQ·PQ)는 그보다 더 줄인다. 대신 거리 계산이 근사가 되므로 recall을 다시 잰다.
pgvector에서 쓰기: 인덱스, 필터, 삭제
-- 거리 연산자와 opclass를 맞춘다: <=> 는 vector_cosine_ops
CREATE INDEX items_embedding_hnsw
  ON items USING hnsw (embedding vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);

-- 트랜잭션 안에서만 ef_search를 올린다
BEGIN;
SET LOCAL hnsw.ef_search = 100;
SELECT id FROM items ORDER BY embedding <=> $1 LIMIT 10;
COMMIT;
필터 검색. WHERE tenant_id = 7을 붙이면 pgvector는 인덱스로 ef_search개 후보를 찾은 뒤 조건을 거른다(post-filter). 조건에 맞는 행이 전체의 1%라면 후보 40개 중 평균 0.4개만 남아 LIMIT 10이 몇 행 안 나온다. 대응은 세 가지다. ef_search를 키우거나, pgvector 0.8.0 이상의 iterative scan(SET hnsw.iterative_scan = relaxed_order)으로 모자라면 더 훑게 하거나, 조건이 고정이면 테넌트별 부분 인덱스나 파티션으로 미리 나눈다(pre-filter). 반대로 조건으로 먼저 거른 뒤 정확 검색을 하는 편이 빠를 만큼 대상이 작으면 인덱스를 쓰지 않는 쪽이 낫다.
삭제와 갱신. HNSW는 삭제에 약하다. 점을 빼면 그 점을 지나던 길이 끊기므로 구현들은 보통 삭제 표시를 하고 나중에 정리한다. pgvector에서는 VACUUM이 그래프를 고치는데 오래 걸릴 수 있다. 임베딩 모델을 바꾸는 것처럼 전체가 바뀌면 행을 하나씩 갱신하지 말고 새 컬럼과 새 인덱스를 만들어 바꿔 끼운다.
recall@k 측정과 IVF·PQ 비교
recall@k는 "정확 검색의 상위 k개 중 ANN이 찾은 비율"이다. 정답은 반드시 브루트포스로 만든다. 실제 질의에서 1,000개쯤 뽑아 두면 파라미터를 바꿀 때마다 같은 잣대로 비교할 수 있다.
import numpy as np

def recall_at_k(approx_ids, exact_ids, k=10):
    # approx_ids, exact_ids: 질의별 상위 k개 id 목록
    hits = [len(set(a[:k]) & set(e[:k])) for a, e in zip(approx_ids, exact_ids)]
    return sum(hits) / (k * len(exact_ids))

def exact_topk(queries, vectors, k=10):
    q = queries / np.linalg.norm(queries, axis=1, keepdims=True)
    v = vectors / np.linalg.norm(vectors, axis=1, keepdims=True)
    return np.argsort(-(q @ v.T), axis=1)[:, :k]  # 코사인 유사도 내림차순
DB 안에서 정답을 만들려면 SET LOCAL enable_indexscan = off로 같은 쿼리를 순차 스캔시킨다. 평균만 보지 말고 recall이 낮은 질의를 따로 모아 보면 필터나 군집 문제가 드러난다.
| 방식 | 구조 | 강점 | 약점 |
|---|---|---|---|
| HNSW | 계층 그래프 | 높은 recall, 학습 없이 바로 삽입 | 메모리 많음, 빌드 느림, 삭제 약함 |
| IVF | k-means 군집 + nprobe개 군집만 검색 | 빌드 빠름, 메모리 적음 | 학습 데이터 필요, 분포가 바뀌면 재학습 |
| PQ | 벡터를 조각내 코드북 번호로 압축 | 메모리를 크게 줄임 | 거리가 근사라 단독 recall 낮음, 원본 재정렬 필요 |
실무에서는 섞어 쓴다. 메모리가 넉넉하면 HNSW, 수억 건이면 IVF-PQ에 원본 재정렬을 붙인다. 유사도 임계값으로 캐시를 맞히는 경우는 recall보다 오탐이 문제라 LLM Semantic Cache 글의 기준을 따로 본다.
자주 하는 실수와 점검표
ef_search를 LIMIT보다 작게 둔다. 후보 목록이 k보다 작으면 결과가 모자라거나 recall이 크게 떨어진다.
opclass와 연산자가 다르다. vector_l2_ops로 만들고 <=>로 정렬하면 인덱스를 쓰지 않고 순차 스캔한다.
필터 결과가 비는 것을 데이터 문제로 본다. post-filter로 후보가 걸러져 나온 현상일 수 있다.
recall을 재지 않고 파라미터를 바꾼다. 지연만 보고 ef를 낮추면 품질 저하를 사용자가 먼저 발견한다.
대량 적재 후 인덱스를 나중에 만들지 않는다. 인덱스가 있는 상태에서 수백만 건을 넣으면 삽입마다 그래프 탐색이 돌아 적재가 느려진다.
- 거리 함수(코사인·L2·내적)와 opclass, 정렬 연산자가 일치한다
- 실제 질의 1,000개와 브루트포스 정답으로 recall@10 기준선이 있다
- ef_search는 LIMIT 이상이고 질의 종류별 값이 정해져 있다
- M·efConstruction 변경은 재빌드 시간과 함께 계획되어 있다
- 벡터 수 × (차원 × 4 + 2M × 4)로 어림한 메모리가 서버 메모리 안에 든다
- 필터 비율이 낮은 조건은 부분 인덱스나 iterative scan으로 대응했다
- 대량 적재는 데이터를 먼저 넣고 인덱스를 나중에 만든다
- 삭제·갱신이 많은 테이블은 VACUUM 시간을 지켜보고 있다
- 임베딩 모델 교체는 새 컬럼·새 인덱스로 바꿔 끼우는 절차가 있다
HNSW는 듬성한 위층으로 먼 거리를 건너고 촘촘한 0층에서 후보 ef개를 훑어 정답 근처를 빠르게 찾는 구조이고, 그 근사를 믿을 수 있게 만드는 것은 파라미터 감이 아니라 브루트포스 정답으로 잰 recall이다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.