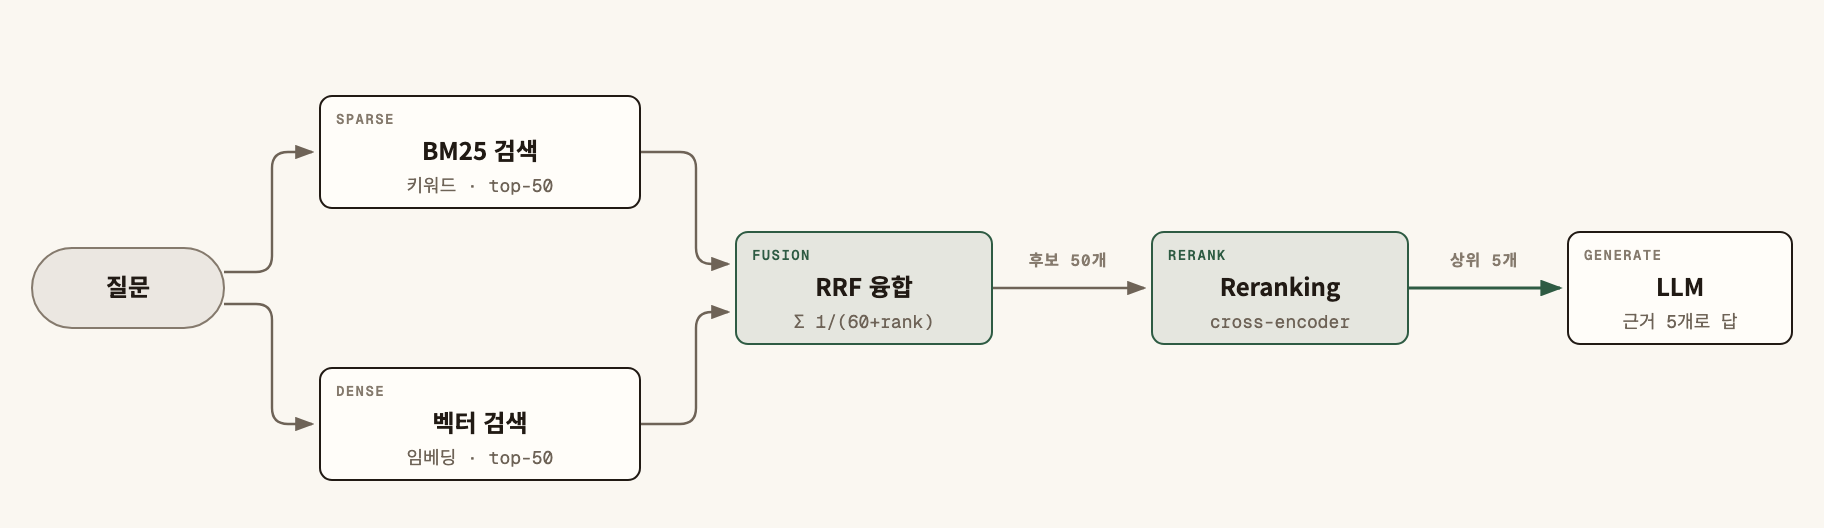
RAG 답변이 틀리는 원인의 상당수는 모델이 아니라 검색에 있다. 찾아야 할 문서를 상위 몇 개 안에 넣지 못하면 어떤 모델도 맞는 답을 쓸 수 없다. 이 글은 키워드 검색(BM25)과 벡터 검색을 함께 돌리는 Hybrid Search, 두 결과를 합치는 RRF, 후보를 다시 줄 세우는 Cross-encoder Reranking, 그리고 개선 여부를 숫자로 확인하는 평가 방법을 순서대로 정리한다.
한눈에 보기
| 단계 | 하는 일 | 기본값 예시 | 빠지면 생기는 일 |
|---|---|---|---|
| 청크·메타데이터 | 문서를 검색 단위로 자르고 속성을 붙인다 | 섹션 단위, 제목 경로 포함 | 맞는 문서가 있어도 엉뚱한 조각이 걸린다 |
| BM25 검색 | 단어가 그대로 겹치는 청크를 찾는다 | top-50 | 오류 코드·모델명·조항 번호를 놓친다 |
| 벡터 검색 | 뜻이 비슷한 청크를 찾는다 | top-50 | 표현을 바꾼 질문을 놓친다 |
| RRF 융합 | 두 순위를 하나로 합친다 | k=60 | 한쪽 점수 척도가 결과를 지배한다 |
| Reranking | 질문과 청크를 함께 읽고 다시 줄 세운다 | 50개 중 상위 5개 | 비슷하지만 답이 없는 청크가 상위에 남는다 |
| 평가 | 골든 질문셋으로 단계별 지표를 잰다 | Recall@50, nDCG@5 | 바꾼 것이 나아졌는지 알 수 없다 |
표의 숫자는 출발점으로 쓰는 예시다. 실제 값은 아래 평가 단계에서 정한다.
벡터 검색만으로는 왜 놓치나
임베딩은 문장의 뜻을 하나의 벡터로 압축한다. 그래서 "결제를 취소하고 싶다"와 "환불 절차"처럼 단어가 달라도 가깝게 놓인다. 반대로 압축 과정에서 글자 그대로의 정보가 흐려진다.
- 식별자:
ORA-01555,E1042같은 오류 코드, 제품 모델명, 법 조항 번호는 비슷하게 생긴 다른 값과 구별되지 않는다. - 드문 고유명사: 사내 시스템 이름, 약어는 임베딩 모델이 학습 중에 거의 보지 못했다.
- 부정과 조건: "적용되지 않는 경우"와 "적용되는 경우"가 가깝게 놓이기 쉽다.
BM25는 정확히 반대다. 단어가 겹치면 강하고, 표현을 바꾸면 놓친다. 두 방식이 놓치는 질문이 서로 다르기 때문에 함께 돌리는 것이 Hybrid Search의 출발점이다.
BM25와 벡터 검색을 나란히 돌리기
두 검색은 같은 청크 id를 공유하는 두 인덱스에서 따로 실행한다. 각각 후보를 넉넉히(예시: 50개) 가져와야 뒤 단계에서 고를 여지가 생긴다.
한국어 BM25는 형태소 분석이 먼저다. 공백 기준으로 자르면 "환불은", "환불을", "환불"이 서로 다른 단어가 된다. Elasticsearch·OpenSearch라면 nori 분석기를 쓰고, 분석기를 바꾼 뒤에는 색인을 다시 만든다.
메타데이터 필터는 두 검색에 똑같이 건다. 문서 버전, 부서, 열람 권한, 유효 기간 같은 조건이 한쪽에만 걸리면 융합 단계에서 걸러졌어야 할 청크가 다른 쪽으로 들어온다. 특히 권한 필터는 검색 단계에서 걸어야 한다. 답변 생성 뒤에 거르면 이미 모델 컨텍스트에 들어간 뒤다.
점수 합치기: RRF와 정규화 가중합
BM25 점수는 상한이 없고, 코사인 유사도는 -1에서 1 사이다. 그대로 더하면 BM25 쪽이 결과를 지배한다. 그래서 점수 대신 순위를 합치는 RRF(Reciprocal Rank Fusion)를 많이 쓴다.
RRF(d) = Σ 1 / (k + rank_i(d))
각 검색기에서 청크 d의 순위를 넣어 더한다. 목록에 없으면 0이다. k는 Cormack 등의 RRF 논문(2009)이 쓴 60을 기본값으로 흔히 쓴다. k가 클수록 1위와 10위의 차이가 줄어든다.
from collections import defaultdict

def rrf(rankings: list[list[str]], k: int = 60, top_n: int = 50) -> list[tuple[str, float]]:
    """rankings: 검색기별 청크 id 목록(1위부터). 목록에 없는 청크는 0점."""
    scores: dict[str, float] = defaultdict(float)
    for ranking in rankings:
        for rank, chunk_id in enumerate(ranking, start=1):
            scores[chunk_id] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda x: x[1], reverse=True)[:top_n]

bm25_ids = ["c17", "c03", "c42"]
vector_ids = ["c88", "c03", "c42"]
print(rrf([bm25_ids, vector_ids]))
# c03 0.0323, c42 0.0317, c17 0.0164, c88 0.0164
한쪽에서만 1위인 c17보다 양쪽에서 2위인 c03이 앞선다. 두 검색이 모두 고른 청크를 올리는 것이 RRF의 성질이다.
다른 방법은 두 점수를 각각 0~1로 정규화(min-max)한 뒤 α·BM25 + (1-α)·벡터로 더하는 것이다. 점수 크기의 차이를 살릴 수 있지만 α를 데이터마다 맞춰야 하고, 후보 하나가 튀면 정규화 전체가 흔들린다. 평가셋이 아직 없으면 RRF로 시작하고, 평가셋이 생긴 뒤 가중합과 비교한다.
검색 엔진이 융합을 직접 해 주기도 한다. Elasticsearch는 retriever의 rrf로 두 검색을 한 요청에 묶는다.
{
  "retriever": {
    "rrf": {
      "retrievers": [
        { "standard": { "query": { "match": { "body": "환불 규정" } } } },
        { "knn": { "field": "embedding", "query_vector": [0.12, -0.03, 0.88], "k": 50, "num_candidates": 200 } }
      ],
      "rank_window_size": 50,
      "rank_constant": 60
    }
  }
}
query_vector는 실제로는 임베딩 차원 수만큼의 값이다. 이 기능은 버전과 라이선스에 따라 쓸 수 있는지가 다르므로 공식 문서에서 확인한다. OpenSearch는 hybrid 쿼리와 검색 파이프라인의 정규화 프로세서로 같은 일을 한다.
Cross-encoder로 다시 순위 매기기
벡터 검색에 쓰는 임베딩 모델은 Bi-encoder다. 질문과 청크를 따로 벡터로 만들기 때문에 청크 벡터를 미리 계산해 둘 수 있고 빠르다. 대신 질문과 청크가 서로를 보지 못한 채 비교된다.
Cross-encoder는 질문과 청크를 한 입력으로 읽고 관련도 점수 하나를 낸다. 더 정확하지만 후보마다 모델을 한 번씩 돌려야 해서 전체 문서에는 쓸 수 없다. 그래서 RRF로 50개를 추린 뒤 그 50개만 다시 줄 세운다.
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # 한국어를 포함한 다국어 재정렬 모델 예시

def rerank(query: str, chunks: list[dict], top_n: int = 5, min_score: float | None = None):
    scores = reranker.predict([(query, c["text"]) for c in chunks])
    ranked = sorted(zip(chunks, scores), key=lambda x: x[1], reverse=True)
    if min_score is not None:  # 기준 미만이면 "근거 없음"으로 답하게 한다
        ranked = [(c, s) for c, s in ranked if s >= min_score]
    return ranked[:top_n]
- 지연 시간은 후보 수에 비례한다. 후보를 50개에서 100개로 늘리면 재정렬 시간도 대략 두 배가 된다. 후보 수는 평가 지표와 응답 시간을 같이 보고 정한다.
- 점수 척도는 모델마다 다르다.
min_score는 골든 질문셋에서 정답 청크와 오답 청크의 점수 분포를 보고 정한다. - 상위 5개만 LLM에 넘기는 이유는 컨텍스트가 길수록 관련 없는 청크가 답을 흐리기 때문이다. 컨텍스트에 무엇을 얼마나 넣을지는 AI Agent의 Context Engineering과 메모리 계층 설계에서 더 다뤘다.
청크 설계가 검색 품질의 바닥을 정한다
융합과 재정렬은 이미 있는 청크 중에서 고르는 일이다. 청크가 잘못 잘려 있으면 고를 대상이 없다.
- 의미 단위로 자른다. 글자 수로 자르면 표 머리와 표 내용, 질문과 답이 다른 청크로 갈라진다. 제목·섹션 경계를 먼저 따르고, 너무 길 때만 나눈다.
- 제목 경로를 청크 앞에 붙인다. "환불 규정 > 해외 결제 > 수수료"를 본문 앞에 넣고 임베딩하면 짧은 청크도 맥락을 갖는다.
- 작게 찾고 크게 넘긴다. 검색은 작은 청크로 하고, LLM에는 그 청크가 속한 상위 섹션을 넘기는 방식이다. 검색 정확도와 답변 맥락을 둘 다 챙긴다.
- 겹침(overlap)은 조금만. 경계에 걸친 문장을 살리는 정도면 충분하다. 많이 겹치면 같은 내용이 후보를 여러 자리 차지한다.
평가: 골든 질문셋과 Recall@k·MRR·nDCG
개선은 감으로 판단하지 않는다. 실제 사용자 질문을 모아 질문마다 정답 청크 id를 붙인 골든 질문셋을 만든다(예시: 질문 150개). 쉬운 질문만 모이지 않도록 식별자 질문, 바꿔 말한 질문, 답이 없는 질문을 섞는다.
| 지표 | 계산 | 무엇을 보나 |
|---|---|---|
| Recall@k | 상위 k개에 든 정답 청크 수 ÷ 전체 정답 청크 수 | 후보 단계가 정답을 놓치지 않았나 |
| MRR | 첫 정답 순위의 역수를 질문마다 평균 | 정답이 얼마나 위에 오나 |
| nDCG@k | 관련도 등급을 순위로 할인해 더하고 이상적인 값으로 나눔 | 여러 정답의 순서가 맞나 |
지표는 단계마다 따로 잰다. 융합 단계는 Recall@50을 본다. 여기서 빠진 정답은 Reranker가 되살릴 수 없기 때문이다. 재정렬 뒤에는 nDCG@5와 MRR을 본다. LLM이 실제로 읽는 것이 상위 5개이기 때문이다.
임베딩 모델, 청크 크기, k, 후보 수를 바꿀 때마다 같은 질문셋으로 다시 재고 결과를 기록한다. 이 측정을 배포 파이프라인에 넣는 방법은 AI Agent Eval 파이프라인과 회귀 테스트 자동화에 정리했다. 검색을 한 번에 끝내지 않고 에이전트가 반복하는 구조는 Agentic RAG와 일반 RAG의 아키텍처 차이에서, 같은 질문의 검색을 아예 건너뛰는 캐시는 LLM Semantic Cache 설계와 캐시 오염 방지에서 이어진다.
자주 하는 실수
점수를 정규화 없이 더한다. BM25 점수의 크기가 결과를 정해 벡터 검색을 붙인 의미가 없어진다.
후보를 top-5만 가져온 뒤 재정렬한다. Reranker가 고를 대상이 5개뿐이라 순서만 바뀌고 놓친 정답은 그대로다.
메타데이터 필터를 한쪽 검색에만 건다. 권한 밖 문서나 폐기된 버전이 다른 쪽 검색을 타고 들어온다.
한국어 BM25에 형태소 분석기를 빼먹는다. 조사가 붙은 단어가 모두 다른 단어가 되어 키워드 검색이 거의 맞지 않는다.
최종 답변만 보고 검색을 평가한다. 답이 틀렸을 때 검색 탓인지 생성 탓인지 나눌 수 없어 같은 실험을 반복하게 된다.
점검표
- 골든 질문셋에 식별자 질문, 바꿔 말한 질문, 답이 없는 질문이 모두 있다.
- 한국어 BM25 인덱스가 형태소 분석기를 쓴다.
- BM25와 벡터 검색이 같은 청크 id와 같은 메타데이터 필터를 쓴다.
- 권한 필터가 검색 단계에서 걸린다.
- 융합은 RRF 또는 정규화한 점수로 하고, k나 α 값을 기록해 두었다.
- 융합 단계의 Recall@50을 따로 잰다.
- Reranker 후보 수를 지표와 응답 시간으로 정했다.
- Reranker 최소 점수를 골든 질문셋의 점수 분포로 정했다.
- 설정을 바꿀 때마다 같은 질문셋으로 다시 재고 결과를 남긴다.
검색 품질은 두 검색으로 후보를 넓게 모으고, 순위로 합치고, 비싼 모델로 좁히고, 단계마다 숫자로 확인하는 구조에서 나온다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.