인덱스를 만들었는데도 쿼리가 테이블 전체를 읽는 일은 흔하다. 원인은 대부분 세 가지 중 하나다. 조건이 인덱스를 쓸 수 없는 모양이거나, 옵티마이저가 계산해 보니 전체를 읽는 편이 싸거나, 옵티마이저가 잘못된 정보로 계산했거나. 이 글은 실행계획으로 원인을 찾는 순서와, 원인마다 SQL을 어떻게 고치는지 Oracle·MySQL·PostgreSQL 예시로 정리한 것이다.
한눈에 보기
| 묶음 | 대표 원인 | 실행계획에서 보이는 신호 | 조치 |
|---|---|---|---|
| 조건이 인덱스를 못 씀 | 컬럼 가공, 암묵 형변환, LIKE '%x', 선두 컬럼 누락, OR·IS NULL |
조건이 filter로만 나오고 access가 없음 |
조건 다시 쓰기, 함수 기반 인덱스, 인덱스 컬럼 순서 조정 |
| 옵티마이저가 옳게 고름 | 결과가 테이블의 큰 부분, 클러스터링 팩터가 나쁨 | 예상 행 수가 실제와 비슷하고 큼 | Full Scan 유지, 읽을 범위 자체를 줄임 |
| 옵티마이저가 잘못 계산 | 오래된 통계, 바인드 피킹, 큰 OFFSET, 조인 컬럼 문자셋 불일치 |
예상 행 수와 실제 행 수가 크게 다름 | 통계 갱신, 히스토그램, 키셋 페이지네이션, 컬럼 타입 통일 |
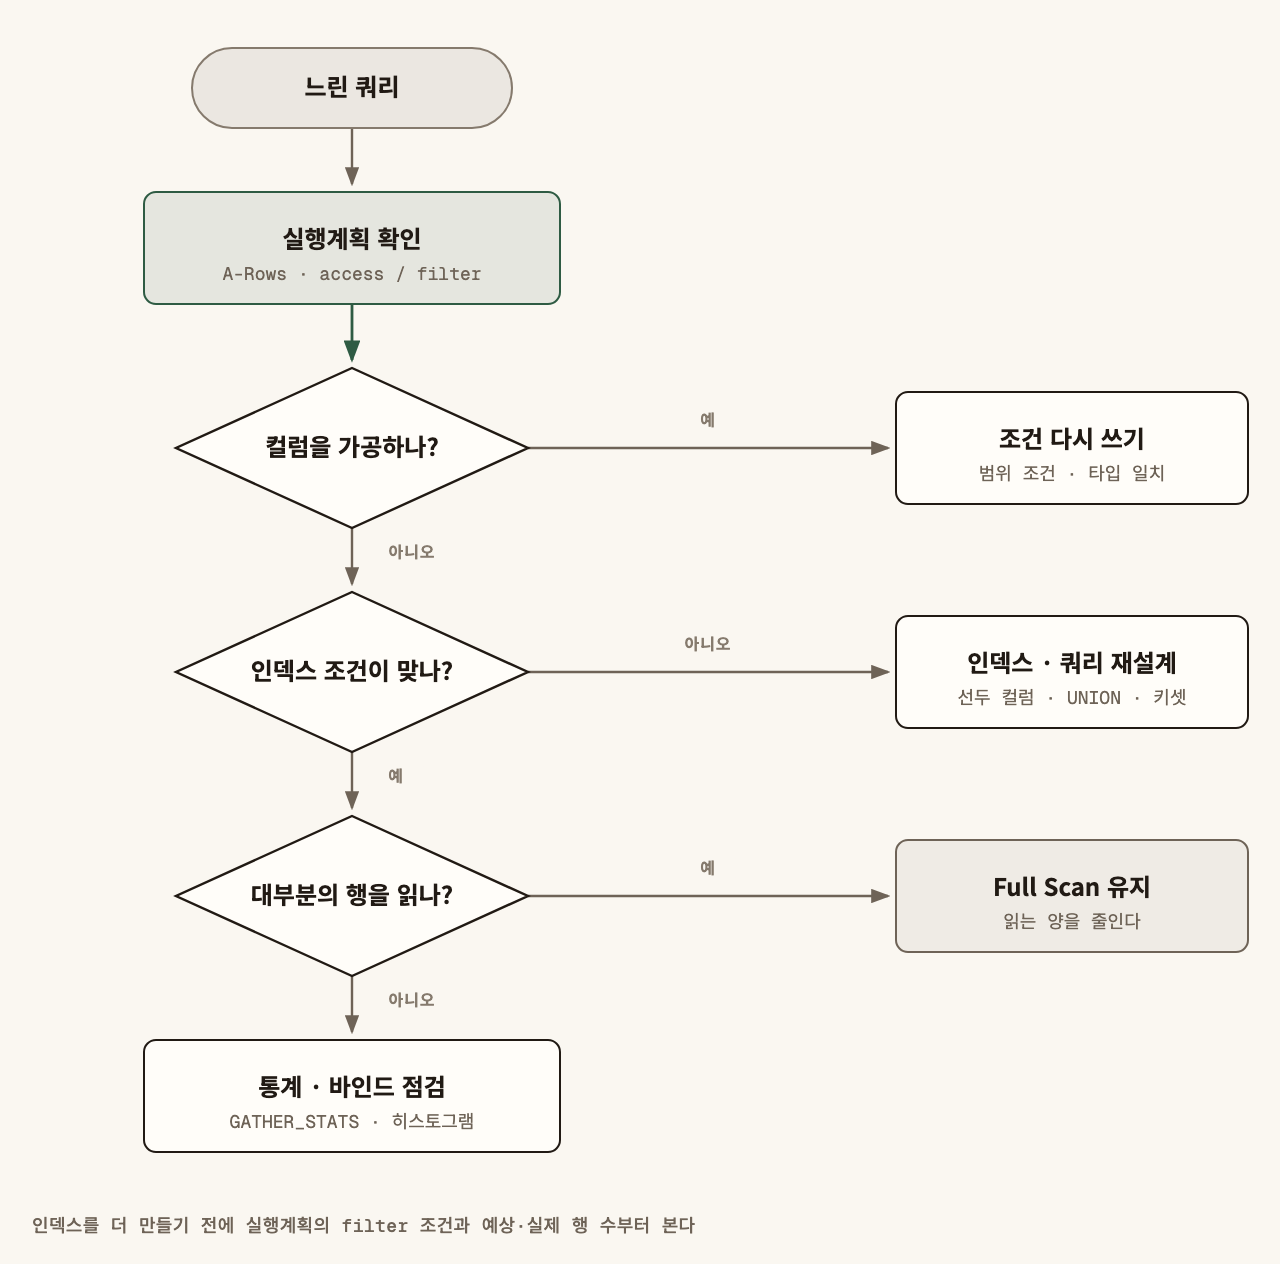
순서가 중요하다. 실행계획을 보기 전에 인덱스부터 추가하면, 쓰이지 않는 인덱스가 하나 더 늘 뿐이다.
먼저 실행계획을 본다
추측으로 고치지 않는다. 실제로 실행된 계획과 실제 행 수를 본다.
Oracle
SELECT /*+ GATHER_PLAN_STATISTICS */ *
  FROM members
 WHERE member_no = 20261031;

SELECT * FROM TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL, NULL, 'ALLSTATS LAST'));
EXPLAIN PLAN FOR는 예상 계획이라 바인드 변수 타입과 값이 반영되지 않는다. 운영에서 느린 SQL은 DISPLAY_CURSOR로 커서에 실제로 붙은 계획을 본다.
------------------------------------------------------------
| Id  | Operation         | Name    | E-Rows | A-Rows |
------------------------------------------------------------
|   0 | SELECT STATEMENT  |         |        |      1 |
|*  1 |  TABLE ACCESS FULL| MEMBERS |      1 |      1 |
------------------------------------------------------------
Predicate Information (identified by operation id):
   1 - filter(TO_NUMBER("MEMBER_NO")=20261031)
위는 예시 출력이다. TABLE ACCESS FULL과 함께 filter(TO_NUMBER("MEMBER_NO")...)가 보이면 원인은 거의 정해진다. 문자 컬럼에 숫자를 비교해 Oracle이 컬럼 쪽을 변환했다.
MySQL 은 EXPLAIN에서 type: ALL, key: NULL이면 Full Scan이다. 8.0.18부터는 EXPLAIN ANALYZE로 실제 행 수와 시간을 볼 수 있다.
PostgreSQL 은 EXPLAIN (ANALYZE, BUFFERS)에서 Seq Scan on members와 Rows Removed by Filter를 본다. ANALYZE는 쿼리를 실제로 실행하므로 UPDATE·DELETE는 트랜잭션 안에서 보고 롤백한다.
원인 1: 인덱스 컬럼을 가공한다
B-tree 인덱스는 컬럼 값 그대로 정렬돼 있다. 조건에서 컬럼을 함수나 연산으로 바꾸면 그 정렬을 쓸 수 없다.
함수와 연산
-- 인덱스를 못 쓴다 (Oracle)
WHERE TO_CHAR(order_dt, 'YYYYMMDD') = '20261031'
-- 인덱스를 못 쓴다 (MySQL)
WHERE DATE(created_at) = '2026-10-31'

-- 컬럼은 그대로 두고 값을 범위로 바꾼다 (Oracle)
WHERE order_dt >= DATE '2026-10-31'
  AND order_dt <  DATE '2026-11-01'
amount * 1.1 > 10000, SUBSTR(code, 1, 3) = 'A01'도 같다. 연산은 값 쪽으로 옮기고, 앞부분 비교는 code LIKE 'A01%'로 바꾼다.
대소문자 무시 검색처럼 가공을 피할 수 없으면 가공한 값에 인덱스를 만든다.
-- Oracle, PostgreSQL
CREATE INDEX ix_users_email_upper ON users (UPPER(email));
-- MySQL 8.0.13 이상 (괄호가 두 겹)
CREATE INDEX ix_users_email_upper ON users ((UPPER(email)));
쿼리의 식이 인덱스 식과 정확히 같아야 쓰인다. UPPER(email)로 만들고 LOWER(email)로 찾으면 다시 Full Scan이다.
암묵 형변환
문자 컬럼을 숫자와 비교하면 Oracle과 MySQL은 문자 컬럼 쪽을 숫자로 바꿔 비교한다. 결과는 컬럼에 함수를 씌운 것과 같다. 반대로 숫자 컬럼에 문자 값을 비교하면 값 쪽이 바뀌므로 인덱스는 살아 있다. PostgreSQL은 varchar 컬럼과 integer 값 비교를 암묵 변환하지 않고 오류로 막는다.
애플리케이션에서 더 자주 생긴다. VARCHAR2 컬럼인데 Java에서 setLong()으로 바인딩하거나, MyBatis에서 #{memberNo}에 Long을 넘기면 SQL 문장은 멀쩡해 보여도 실행계획에는 TO_NUMBER가 붙는다. 컬럼 타입과 바인딩 타입을 맞춘다.
원인 2: 인덱스를 쓸 수 없는 조건
앞에 붙은 와일드카드
LIKE 'abc%'는 정렬된 범위로 찾을 수 있지만 LIKE '%abc'는 시작점을 모른다. 부분 문자열 검색이 꼭 필요하면 다른 종류의 인덱스를 쓴다. PostgreSQL은 pg_trgm 확장의 GIN 인덱스, Oracle은 Oracle Text, MySQL은 단어 단위 FULLTEXT 인덱스가 있다. PostgreSQL에서 C가 아닌 콜레이션을 쓰면 LIKE 'abc%'도 일반 인덱스를 못 쓸 수 있어 text_pattern_ops 인덱스가 필요하다.
복합 인덱스의 선두 컬럼이 빠짐
(dept_id, hire_dt) 인덱스는 dept_id로 먼저 정렬돼 있다. WHERE hire_dt >= ...만 있으면 범위를 잡을 수 없다. Oracle은 선두 컬럼 값 종류가 적을 때 INDEX SKIP SCAN으로 선두 값마다 나눠 찾기도 하고, MySQL도 8.0.13부터 skip scan을 지원한다. 하지만 이것에 기대지 않는다. 자주 쓰는 조건이 선두에 오도록 인덱스를 만든다. 등치 조건 컬럼을 앞에, 범위 조건 컬럼을 뒤에 둔다.
OR, 부정, NULL
WHERE a = ? OR b = ?는 두 컬럼에 각각 인덱스가 있어도 옵티마이저가 합치지 못하면 Full Scan으로 간다. MySQL의 index merge, PostgreSQL의BitmapOr, Oracle의 OR 확장이 동작하는지 실행계획으로 확인하고, 안 되면UNION으로 나눈다.<>,NOT IN,NOT LIKE는 대부분의 행이 조건을 만족하므로 인덱스 범위가 의미가 없다.- Oracle의 단일 컬럼 B-tree 인덱스는 키가 모두 NULL인 행을 저장하지 않는다. 그래서
WHERE closed_at IS NULL은 그 인덱스를 못 쓴다.CREATE INDEX ix_orders_closed ON orders (closed_at, 0);처럼 상수를 붙인 복합 인덱스를 만들면 NULL 행도 인덱스에 들어간다. MySQL InnoDB와 PostgreSQL은 NULL도 인덱스에 저장하므로IS NULL에 인덱스를 쓸 수 있다.
원인 3: 옵티마이저가 Full Scan을 고른다
조건이 멀쩡해도 옵티마이저는 비용을 비교해 Full Scan을 고를 수 있다. 이때는 옵티마이저가 옳은 경우와 틀린 경우를 나눠 본다.
결과가 많다
인덱스로 찾은 행마다 테이블 블록을 한 번씩 읽는다. 찾는 행이 많으면 이 임의 읽기가 Full Scan의 연속 다중 블록 읽기보다 비싸진다. "몇 % 이상이면 Full Scan"이라는 고정값은 없다. 행 크기, 블록 수, 저장장치, 그리고 클러스터링 팩터에 따라 달라진다. 클러스터링 팩터는 인덱스 순서대로 읽을 때 테이블 블록이 얼마나 자주 바뀌는지를 나타내는 Oracle 통계다. 같은 값의 행이 테이블 곳곳에 흩어져 있으면 적은 행을 찾아도 많은 블록을 읽는다.
통계가 오래됐다
대량 적재나 삭제 뒤 통계를 갱신하지 않으면 옵티마이저는 예전 행 수로 계산한다. 실행계획의 예상 행 수(E-Rows, rows=)와 실제 행 수(A-Rows, actual rows=)가 크게 다르면 통계부터 의심한다.
-- Oracle
EXEC DBMS_STATS.GATHER_TABLE_STATS('APP', 'ORDERS');
-- MySQL
ANALYZE TABLE orders;
-- PostgreSQL
ANALYZE orders;
바인드 값에 따라 좋은 계획이 다르다
status = ?에서 'DONE'이 대부분이고 'ERROR'가 드물면, 좋은 계획은 값마다 다르다. Oracle은 처음 하드 파싱할 때 바인드 값을 엿보고(bind peeking) 그 값에 맞는 계획을 커서에 남긴다. 처음 들어온 값이 'DONE'이면 이후 'ERROR' 조회도 Full Scan으로 돈다. 히스토그램과 적응적 커서 공유(adaptive cursor sharing)가 이를 줄인다. PostgreSQL의 prepared statement는 몇 번 실행한 뒤 일반 계획(generic plan)으로 바뀔 수 있고, plan_cache_mode로 동작을 정할 수 있다. 값 분포가 치우친 컬럼은 히스토그램이 수집되는지 확인한다.
원인 4: 쿼리 모양과 조인
큰 OFFSET
ORDER BY id LIMIT 20 OFFSET 100000은 100,020행을 읽고 앞의 100,000행을 버린다. 뒤 페이지로 갈수록 느려지고, 옵티마이저가 Full Scan과 정렬을 고르기도 한다. 마지막으로 본 키를 기준으로 다음 페이지를 찾는다.
-- 키셋 페이지네이션 (MySQL, PostgreSQL)
SELECT id, title FROM posts
 WHERE id < :last_id
 ORDER BY id DESC
 LIMIT 20;
-- Oracle 12c 이상
SELECT id, title FROM posts
 WHERE id < :last_id
 ORDER BY id DESC
 FETCH FIRST 20 ROWS ONLY;
조인 컬럼의 타입·문자셋이 다름
조인 양쪽 컬럼의 타입이 다르면 한쪽이 변환되고, 그쪽 인덱스는 못 쓴다. MySQL에서 한 테이블은 utf8mb4, 다른 테이블은 utf8mb3이거나 콜레이션이 다르면 조인할 때 변환이 들어간다. Oracle에서 VARCHAR2와 NVARCHAR2를 조인하면 조건에 SYS_OP_C2C가 붙는다. 같은 의미의 컬럼은 테이블이 달라도 타입·길이·문자셋·콜레이션을 같게 정의한다.
Full Scan이 정답인 경우
Full Scan을 무조건 없애려 하면 오히려 느려진다. 다음은 Full Scan이 맞는 경우다.
| 상황 | Full Scan이 맞는 이유 | 억지로 인덱스를 쓰면 |
|---|---|---|
| 작은 코드 테이블 | 블록 몇 개를 한 번에 읽는 편이 싸다 | 인덱스 블록까지 읽어 일이 늘어난다 |
| 결과가 테이블의 큰 부분 | 연속 다중 블록 읽기가 임의 읽기보다 싸다 | 같은 블록을 여러 번 읽는다 |
| 배치·집계 쿼리 | 어차피 전체를 읽고 병렬로 처리한다 | 힌트로 막으면 병렬 처리도 막힌다 |
| 필요한 컬럼이 모두 인덱스에 있음 | 인덱스만 통째로 읽는다(Oracle INDEX FAST FULL SCAN, PostgreSQL Index Only Scan) |
이건 이미 좋은 계획이다 |
이때 할 일은 읽는 양 자체를 줄이는 것이다. 조회 기간 조건을 추가하거나, 파티션으로 나눠 필요한 파티션만 읽게 하거나, 집계 결과를 미리 만들어 둔다. 인덱스 힌트로 계획을 고정하는 것은 마지막 수단이다. 데이터 분포가 바뀌면 힌트가 거꾸로 성능을 떨어뜨린다.
자주 하는 실수
- 실행계획을 안 보고 인덱스를 추가한다. 조건이 컬럼을 가공하고 있으면 새 인덱스도 쓰이지 않는다.
EXPLAIN PLAN만 보고 끝낸다. 예상 계획은 바인드 타입을 모르므로 운영에서 도는 계획과 다를 수 있다.- SQL 문장만 보고 형변환을 놓친다. 바인딩 타입이 다르면 문장은 같아도 계획이 다르다.
- 인덱스 힌트로 해결한다. 원인을 남긴 채 계획만 고정하면 데이터가 바뀔 때 다시 문제가 된다.
- Full Scan이면 무조건 나쁘다고 본다. 결과가 많은 쿼리는 Full Scan이 가장 빠른 계획일 수 있다.
점검표
- 운영에서 실제로 돈 실행계획(
DISPLAY_CURSOR,EXPLAIN ANALYZE)을 확인했다 - 예상 행 수와 실제 행 수를 비교했다
- 조건절의 인덱스 컬럼에 함수·연산이 없다
- 컬럼 타입과 애플리케이션 바인딩 타입이 같다
-
LIKE가 와일드카드로 시작하지 않거나, 맞는 인덱스 종류를 쓴다 - 복합 인덱스의 선두 컬럼이 조건에 들어 있다
- Oracle에서
IS NULL조건에 쓸 인덱스가 NULL 행을 담고 있다 - 대량 변경 뒤 통계를 갱신했다
- 페이지네이션이 큰
OFFSET대신 키셋 방식이다 - 조인 컬럼의 타입·문자셋·콜레이션이 양쪽에서 같다
인덱스가 있는데 Full Scan이 나오면, 실행계획을 보고 조건이 인덱스를 쓸 수 있는 모양인지, 옵티마이저가 옳게 계산했는지를 차례로 가린 뒤 원인 하나를 고친다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.