메시지 브로커와 스트림 처리 엔진은 "exactly-once"를 지원한다고 말하지만, 네트워크 너머로 메시지를 정확히 한 번만 전달하는 방법은 없다. 실무에서 말하는 exactly-once는 전달을 최소 한 번 하되 결과가 한 번만 반영되게 만드는 것이고, 그 보장은 특정 시스템의 경계 안에서만 성립한다. 이 글은 전달 보장과 처리 보장이 어떻게 다른지, Kafka와 Flink가 무엇을 어디까지 보장하는지, 경계 밖의 이메일·결제 같은 부작용은 어떻게 막는지 정리한 것이다.
한눈에 보기
| 보장 | 어떻게 만드나 | 장애가 나면 | 어울리는 곳 |
|---|---|---|---|
| at-most-once | 처리 전에 소비 위치를 커밋하고 재시도하지 않음 | 메시지 유실 | 지표 샘플링, 실시간 위치 갱신 |
| at-least-once | 처리 뒤에 커밋하고 실패하면 재시도 | 같은 메시지 중복 처리 | 대부분의 업무 연계 기본값 |
| effectively-once | 최소 한 번 전달 + 결과와 소비 위치를 원자적으로 반영하거나 멱등 반영 | 다시 처리해도 결과는 한 번 | 정산, 재고, 집계 |
왜 '정확히 한 번 전달'은 불가능한가
보내는 쪽은 메시지를 보낸 뒤 확인 응답(ack)을 기다린다. 응답이 오지 않았을 때 보내는 쪽이 아는 것은 "응답을 못 받았다"뿐이다. 메시지가 가다가 사라졌는지, 받는 쪽이 처리하고 보낸 응답이 사라졌는지 구별할 수 없다.
이것이 두 장군 문제(Two Generals' Problem)다. 신뢰할 수 없는 통신로에서는 몇 번 확인을 주고받아도 양쪽이 같은 사실을 확실히 알 수 없다. 그래서 보내는 쪽은 둘 중 하나를 골라야 한다.
- 다시 보낸다: 받는 쪽이 이미 처리했다면 중복이 된다(at-least-once).
- 다시 보내지 않는다: 메시지가 사라졌다면 유실이 된다(at-most-once).
세 번째 선택지는 없다. 따라서 "정확히 한 번"은 전달 계층이 아니라 받는 쪽의 반영 방식으로 만들어야 한다.
실무의 exactly-once는 '효과가 한 번'이다
전달은 최소 한 번으로 두고, 같은 메시지가 두 번 와도 결과가 한 번만 남게 만든다. 이를 effectively-once라고도 부른다. 방법은 두 가지다.
1. 결과와 소비 위치를 원자적으로 반영한다. 처리 결과와 "여기까지 읽었다"는 기록을 한 트랜잭션에 넣는다. 둘 다 커밋되거나 둘 다 취소되므로, 재시작하면 결과가 없는 위치부터 다시 읽는다. Kafka 트랜잭션과 Flink 체크포인트가 이 방식이다.
2. 반영을 멱등하게 만든다. 메시지마다 고유 ID를 두고, 이미 처리한 ID면 건너뛴다. 또는 "잔액 += 1000"이 아니라 "주문 123의 상태 = 결제완료"처럼 여러 번 실행해도 같은 결과가 나오는 연산으로 바꾼다. 받는 쪽 Inbox 테이블과 멱등 키가 이 방식이며, 자세한 구현은 이전 글 Outbox·Inbox 패턴으로 연계 데이터 정합성 확보하기와 분산 환경에서 멱등 API와 중복 요청 방지 설계에 정리했다.
소비자 쪽: 커밋 순서가 보장을 정한다
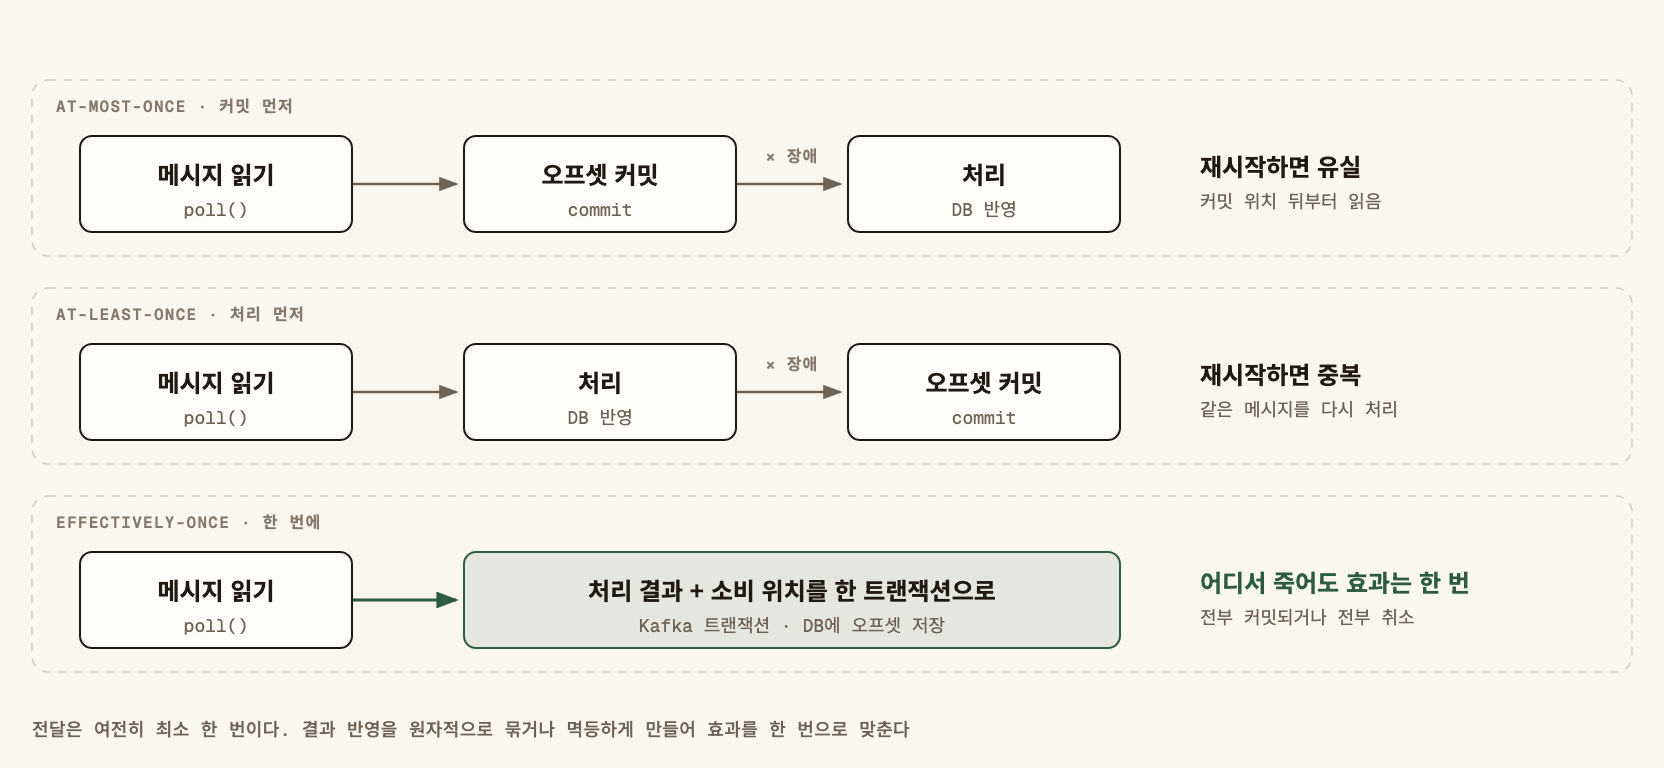
위 그림처럼 Kafka 소비자의 보장은 오프셋 커밋 시점에서 갈린다.
- 처리 전에 커밋하면, 처리 중 장애가 났을 때 그 메시지는 다시 읽히지 않는다.
- 처리 뒤에 커밋하면, 커밋 직전 장애가 났을 때 같은 메시지를 다시 처리한다.
enable.auto.commit=true인 자동 커밋은 처리와 무관하게 주기적으로 커밋하므로 둘 중 어느 쪽이 될지 장담할 수 없다. 업무 데이터를 다루는 소비자는 자동 커밋을 끄고 처리 뒤에 직접 커밋한 다음, 처리 자체를 멱등하게 만든다.
props.put("enable.auto.commit", "false");

while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
    for (ConsumerRecord<String, String> r : records) {
        handle(r);           // 메시지 ID로 이미 처리했는지 먼저 확인
    }
    consumer.commitSync();   // 처리 뒤 커밋: 최소 한 번
}
결과를 RDB에 쓴다면 오프셋을 Kafka 대신 같은 DB 테이블에 저장하는 방법도 있다. 결과와 오프셋을 한 DB 트랜잭션에 쓰고, 소비자가 시작할 때 그 오프셋으로 seek() 한다. 그러면 Kafka 트랜잭션 없이도 결과와 소비 위치가 원자적으로 맞는다.
Kafka의 exactly-once가 보장하는 범위
Kafka는 0.11 버전에서 멱등 프로듀서와 트랜잭션(KIP-98)을 추가했다.
- 멱등 프로듀서 (
enable.idempotence=true): 프로듀서마다 ID를, 파티션별 메시지마다 순번을 붙인다. 네트워크 오류로 프로듀서가 같은 배치를 다시 보내도 브로커가 순번을 보고 중복을 버린다. 범위는 한 프로듀서 세션의 한 파티션이다. - 트랜잭션 (
transactional.id): 여러 파티션에 쓰는 메시지와 소비 오프셋 커밋을 하나로 묶는다. 커밋되면 전부 보이고, 취소되면 전부 버려진다. - 읽기 격리 (
isolation.level=read_committed): 소비자가 커밋된 트랜잭션의 메시지만 읽는다. 기본값read_uncommitted로 두면 취소된 메시지도 읽힌다.
이 셋을 합친 "읽고-변환하고-쓰기" 루프는 다음과 같다.
producerProps.put("transactional.id", "order-enricher-1");
consumerProps.put("isolation.level", "read_committed");
consumerProps.put("enable.auto.commit", "false");

producer.initTransactions();
while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
    producer.beginTransaction();
    try {
        for (ConsumerRecord<String, String> r : records) {
            producer.send(new ProducerRecord<>("orders-enriched", r.key(), enrich(r.value())));
        }
        // 다음에 읽을 위치(마지막 오프셋 + 1)를 같은 트랜잭션으로 커밋
        producer.sendOffsetsToTransaction(nextOffsets(records), consumer.groupMetadata());
        producer.commitTransaction();
    } catch (KafkaException e) {
        producer.abortTransaction();   // 소비 위치도 마지막 커밋 지점으로 되돌려 다시 읽는다
        // ProducerFencedException 같은 치명 오류는 abort 대신 프로듀서를 닫는다(예시에서는 생략)
    }
}
Kafka Streams는 이 루프를 processing.guarantee=exactly_once_v2 설정 하나로 대신한다. 상태 저장소의 변경 로그도 같은 트랜잭션에 들어간다.
여기서 범위를 정확히 봐야 한다. 이 보장은 Kafka에서 읽어 Kafka에 쓰는 경우에만 성립한다. 루프 안에서 RDB에 INSERT하거나 외부 API를 부르면, 그 작업은 Kafka 트랜잭션에 들어가지 않는다. 트랜잭션이 취소되고 다시 처리될 때 DB INSERT는 두 번 실행된다.
Flink: 체크포인트와 2단계 커밋 싱크
Flink는 소스에서 주기적으로 체크포인트 배리어를 흘려보내고, 배리어가 지나간 시점의 연산자 상태와 소스 읽기 위치를 함께 스냅숏으로 저장한다. 장애가 나면 마지막 체크포인트로 상태와 읽기 위치를 함께 되돌린다. 여기까지가 Flink 내부 상태의 exactly-once다.
바깥 시스템까지 맞추려면 싱크가 둘 중 하나를 지원해야 한다.
- 트랜잭션 싱크: 체크포인트 사이에 쓴 데이터를 외부 트랜잭션에 쌓아 두고(pre-commit), 체크포인트가 완료되면 커밋한다. 2단계 커밋이다. Kafka 싱크의 exactly-once 모드가 이 방식이다.
- 멱등 싱크: 키 기준 upsert처럼 같은 레코드를 다시 써도 결과가 같은 저장소.
트랜잭션 싱크에는 대가가 있다. 하류 소비자가 read_committed로 읽으면 데이터는 체크포인트가 끝나야 보이므로, 체크포인트 간격만큼 지연이 생긴다. 또 Kafka 브로커의 트랜잭션 제한 시간이 체크포인트 간격과 복구 시간보다 짧으면 커밋 전에 트랜잭션이 취소되어 데이터를 잃을 수 있다.
경계 밖 부작용: 이메일, 결제, 외부 API
이메일 발송, 결제 승인, 문자 전송은 트랜잭션으로 되돌릴 수 없다. 이런 작업은 위 두 시스템의 exactly-once 범위 밖이므로 따로 설계한다.
- 결제·외부 API: 메시지 ID에서 만든 멱등 키를 요청에 실어 보낸다. 상대가 같은 키의 두 번째 요청을 첫 결과로 돌려주는지 연동 규격에서 확인한다.
- 발송 기록: 부작용 전에 Inbox 테이블에 메시지 ID를 기록하고, 이미 있으면 건너뛴다. 기록과 발송 사이에 죽으면 발송이 빠질 수 있으므로, 상태를
보내는 중 → 보냄으로 나누고 오래 머문보내는 중을 점검한다. - 중복 허용 판단: 알림 메일처럼 두 번 가도 피해가 작은 작업은 at-least-once를 받아들이는 편이 단순하다.
정리 표
| 상황 | 택할 방법 | 안 하면 생기는 일 |
|---|---|---|
| Kafka → 가공 → Kafka | 트랜잭션 또는 Kafka Streams exactly_once_v2 |
재처리 때 출력 토픽에 중복 |
| Kafka → RDB | 결과와 오프셋을 한 DB 트랜잭션에 저장, 또는 메시지 ID 유니크 키 | 재시작 때 같은 행이 두 번 반영 |
| Flink → 외부 저장소 | 트랜잭션 싱크 또는 키 기준 upsert | 복구 때 체크포인트 이후 출력이 중복 |
| 결제·외부 API 호출 | 메시지 ID 기반 멱등 키 | 같은 결제가 두 번 승인 |
| 알림 발송 | 발송 기록 테이블 또는 중복 허용 | 같은 알림이 여러 번 감 |
자주 하는 실수
"브로커가 exactly-once를 켰으니 끝났다"고 본다. 보장 범위는 Kafka 안쪽까지이고, 소비자가 쓰는 DB와 외부 API는 포함되지 않는다.
자동 커밋을 켠 채 업무 데이터를 처리한다. 커밋 시점이 처리와 무관해서 유실과 중복이 모두 생길 수 있다.
프로듀서만 트랜잭션으로 바꾸고 소비자는 기본 격리 수준으로 둔다. read_uncommitted로 읽으면 취소된 트랜잭션의 메시지까지 처리한다.
transactional.id를 인스턴스마다 무작위로 만든다. 재시작한 인스턴스가 이전 인스턴스의 미완료 트랜잭션을 정리하지 못한다. 인스턴스가 맡은 역할별로 고정된 값을 쓴다.
재처리를 한 번도 시험하지 않는다. 소비자를 처리 도중 강제 종료하고 다시 띄워 결과 행 수가 그대로인지 보기 전에는 보장을 믿을 수 없다.
점검표
- 업무 데이터를 처리하는 소비자는
enable.auto.commit=false다. - 오프셋 커밋은 처리가 끝난 뒤에 한다.
- 모든 메시지에 고유 ID가 있고, 받는 쪽이 그 ID로 중복을 거른다.
- 트랜잭션 메시지를 읽는 소비자는
isolation.level=read_committed다. -
transactional.id는 인스턴스 역할별로 고정되어 있다. - 소비 루프 안의 DB 쓰기와 외부 호출을 목록으로 적고, 각각의 중복 방지 방법을 정했다.
- 외부 결제·API 호출에 메시지 ID 기반 멱등 키를 싣는다.
- Flink 싱크가 트랜잭션 또는 멱등 쓰기를 지원하는지 확인했다.
- 브로커 트랜잭션 제한 시간이 체크포인트 간격과 복구 시간보다 길다.
- 처리 도중 강제 종료 후 재시작해 결과 건수가 그대로인지 시험했다.
정확히 한 번 전달은 불가능하므로, 전달은 최소 한 번으로 두고 결과 반영을 원자적으로 묶거나 멱등하게 만들어 효과를 한 번으로 맞추되, 그 보장이 어느 경계까지인지 시스템마다 확인해야 한다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.