같은 입력에 다른 답을 내는 LLM은 "어제 통과한 테스트가 오늘 실패하는" 문제를 기본으로 안고 있고, 그대로 두면 팀은 빨간 CI를 무시하는 법부터 배운다. 이 글은 비결정성이 어디서 오는지 나누고, 녹화 재생·스키마 계약·불변식·N회 샘플링의 네 층으로 테스트를 짜서 실패를 다시 일으킬 수 있게 만드는 방법을 정리한다.
한눈에 보기
| 층 | 무엇을 확인하나 | 실제 모델 호출 | 언제 돌리나 |
|---|---|---|---|
| 1. 녹화 재생 | 프롬프트 조립, 응답 파싱, 도구 호출 분기 | 없음 | PR마다 |
| 2. 스키마 계약 | 응답이 정해진 JSON 구조를 지키는가 | 녹화본 + 실모델 | PR마다, 야간 |
| 3. 불변식 | 없는 문서 인용, 길이 초과, 금지 표현 | 녹화본 + 실모델 | PR마다, 야간 |
| 4. N회 샘플링 | 같은 입력을 여러 번 돌린 통과율 | 실모델 N회 | 야간, 모델·프롬프트 변경 시 |
1층에 가까울수록 결정적이고 싸며, 4층으로 갈수록 실제 모델의 흔들림을 그대로 받는다. 한 층이 다른 층을 대신하지 않는다.
여러 실행 결과를 기준선과 비교해 병합을 막는 평가 파이프라인은 AI Agent Eval 파이프라인과 회귀 테스트 자동화에서 다뤘다. 이 글은 그 앞 단계, 테스트 하나하나를 다시 돌려도 같은 판정이 나오게 짜는 방법에 집중한다.
비결정성은 어디서 오나
원인을 나눠야 무엇을 고정하고 무엇을 견딜지 정할 수 있다.
- 샘플링 설정.
temperature와top_p가 0보다 크면 매번 다른 토큰을 고른다. 의도된 흔들림이다. - temperature 0도 완전히 같지 않다. GPU의 부동소수점 덧셈은 순서에 따라 결과가 미세하게 달라지고, 서버가 요청을 어떤 배치로 묶느냐에 따라 연산 순서가 바뀐다. 1위와 2위 토큰의 확률이 거의 같으면 이 차이로 다른 토큰이 뽑히고, 그 뒤 문장 전체가 갈라진다. Anthropic 문서도 temperature 0에서 결과가 완전히 결정적이지 않다고 적고 있다.
- seed는 최선 노력이다. seed 파라미터를 받는 API도 있지만 같은 결과를 보장하지 않는다. OpenAI는 백엔드 구성이 바뀌었는지 보라고 응답에
system_fingerprint를 돌려준다. - 모델 버전.
latest같은 별칭은 어느 날 다른 스냅숏을 가리킨다. 코드는 그대로인데 출력 분포가 바뀐다. - 도구와 검색 결과. 검색 인덱스가 갱신되면 같은 질문에 다른 문서가 붙고, 외부 API 응답도 바뀐다.
- 시각. 프롬프트에 "오늘 날짜"가 들어가면 날마다 입력이 다르다.
앞의 셋은 모델 바깥에서 고칠 수 없고, 뒤의 셋은 입력으로 끌어내 고정할 수 있다. 테스트 설계는 이 경계에서 시작한다.
1층: 녹화 재생 단위 테스트
서비스 코드 대부분은 LLM이 아니라 LLM 주변이다. 프롬프트를 조립하고, 응답을 파싱하고, 도구 호출 여부로 분기한다. 이 부분은 실제 모델 없이 결정적으로 시험할 수 있다.
방법
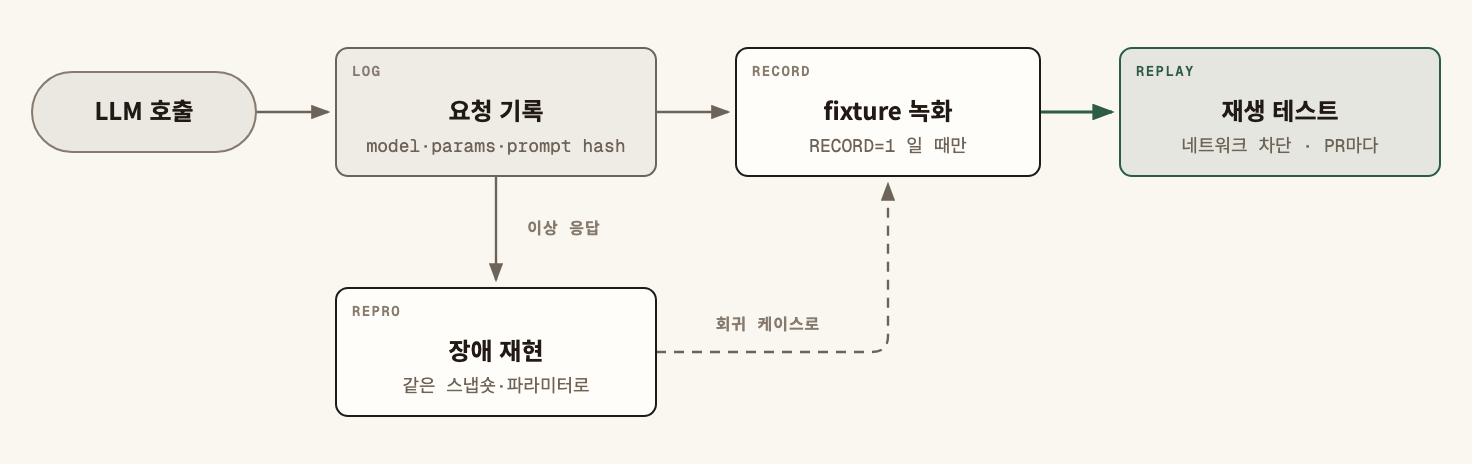
- 실모델을 한 번 호출해 요청과 응답을 파일(fixture)로 녹화한다.
- 테스트는 요청의 해시로 녹화 파일을 찾아 응답을 재생한다. CI에서는 네트워크를 막는다.
- 녹화가 없으면 조용히 실모델로 가지 말고 실패시킨다. 그래야 녹화가 빠진 걸 알 수 있다.
- 프롬프트나 모델이 바뀌면 해시가 바뀌어 녹화가 없다고 실패한다. 다시 녹화하는 건 사람이 명시적으로 한다.
HTTP 단위로 녹화하는 vcrpy 같은 도구도 쓸 수 있다. 다만 요청 본문에 타임스탬프나 무작위 ID가 섞이면 매칭이 깨지니, 비교 키를 직접 정하는 편이 다루기 쉽다.
2층·3층: 스키마 계약과 불변식
정확한 문자열 비교는 LLM 테스트에서 가장 먼저 버려야 할 습관이다. 대신 "어떤 답이 나와도 지켜야 하는 것"을 검사한다.
스키마 계약
- 응답을 JSON 구조로 받고 Pydantic 같은 검증기로 파싱한다. 필수 필드, 열거값, 길이 제한을 여기서 잡는다.
- 구조화 출력(structured output)을 지원하는 API라도 검증은 서비스 쪽에서 다시 한다. 스키마를 바꾼 뒤 녹화본이 옛 구조로 남아 있는 것도 이 테스트가 잡는다.
불변식(속성) 검사
- 인용한 문서 ID가 실제로 검색된 문서 안에 있는가.
- 요약에 나온 숫자가 원문에 있는 숫자인가.
- 길이 상한, 금지 표현, 답변 언어.
- 뜻이 같은 질문 두 개(바꿔 쓴 질문)에 같은 분류가 나오는가.
불변식은 녹화본에도, 실모델 출력에도 그대로 쓸 수 있다. 같은 검사 함수를 1층과 4층이 함께 쓰면 판정 기준이 하나로 유지된다.
4층: N회 샘플링과 통과율
실모델의 흔들림 자체를 시험하려면 한 번이 아니라 여러 번 돌려 통과율을 본다.
- 같은 입력을 N회 호출하고, 각 출력에 스키마·불변식 검사를 돌린다.
- 문자열로 판정할 수 없는 품질(요약이 핵심을 담았는가)은 LLM 심판(LLM-as-judge)에게 채점 기준표(rubric)를 주고 맞음/틀림을 구조화된 값으로 받는다. 심판 모델도 스냅숏을 고정한다.
- 의미 유사도(임베딩 코사인 유사도)는 기준 답과 너무 멀어진 출력만 거르는 보조 신호로 쓴다.
N이 작으면 판정이 흔들린다. 예를 들어 N=10, 8회 이상 통과를 기준으로 잡으면, 실제 통과 확률이 0.9인 프롬프트도 약 7%의 확률로 떨어지고, 0.8로 나빠진 프롬프트도 약 68%의 확률로 통과한다. 그래서 4층은 PR을 막는 문지기보다 야간에 추이를 보는 감시로 두고, 기준선을 깨면 N을 늘려 다시 돌린다.
모델·프롬프트 고정과 요청 기록
재현의 절반은 테스트가 아니라 기록이다. 운영에서 이상한 답이 나왔을 때 같은 조건으로 다시 호출할 수 있어야 한다.
{
  "request_id": "req_20261104_0912",
  "model": "<날짜·버전이 붙은 스냅숏 이름>",
  "params": {"temperature": 0, "top_p": 1, "max_tokens": 800},
  "prompt_version": "summary@v14",
  "prompt_sha256": "3f2a9c",
  "retrieved_ids": ["d1", "d2"],
  "tool_results_ref": "logs/tool/req_20261104_0912.json",
  "now": "2026-11-04T09:12:00+09:00",
  "system_fingerprint": "제공하는 API만"
}
| 무엇을 고정하나 | 어디에 남기나 | 없으면 생기는 일 |
|---|---|---|
| 모델 스냅숏 | 설정 파일, 요청 로그 | 별칭이 바뀐 날 원인 없이 품질이 변한다 |
| 프롬프트 버전·해시 | 저장소, 요청 로그 | 어느 프롬프트가 낸 답인지 모른다 |
| 샘플링 파라미터 | 요청 로그 | 재현 호출의 조건이 다르다 |
| 검색·도구 결과 | 별도 파일 참조 | 같은 질문에 다른 문서가 붙어 재현이 안 된다 |
| 현재 시각 | 입력 인자 | 날짜가 바뀌면 녹화 해시가 깨진다 |
같은 원리가 이웃 설계에도 걸린다. 캐시 키에 모델·프롬프트 버전이 없으면 옛 답이 새 버전 답으로 나간다(LLM Semantic Cache 설계와 캐시 오염 방지). 모델 라우터를 쓰면 어느 모델로 보냈는지도 로그에 있어야 한다(AI Agent의 비용 최적화: Model Routing과 Token Budget).
pytest로 묶은 예시
1층부터 4층까지를 한 파일로 줄인 예시다. build_request와 call_llm은 서비스 코드라고 가정한다.
# tests/test_summary.py
import hashlib, json, os, pathlib
import pytest
from pydantic import BaseModel, Field, ValidationError
from app.llm import build_request, call_llm  # 서비스 코드(예시)

FIXTURES = pathlib.Path(__file__).parent / "fixtures"
DOCS = [{"id": "d1", "text": "..."}, {"id": "d2", "text": "..."}]
TODAY = "2026-11-04"  # 시각도 입력으로 고정한다

class Summary(BaseModel):
    title: str = Field(max_length=60)
    bullets: list[str] = Field(min_length=1, max_length=5)
    source_ids: list[str]

def request_key(req: dict) -> str:
    body = json.dumps(req, sort_keys=True, ensure_ascii=False)
    return hashlib.sha256(body.encode()).hexdigest()[:16]

def recorded(req: dict) -> str:
    path = FIXTURES / f"{request_key(req)}.json"
    if os.environ.get("RECORD") == "1":  # 다시 녹화는 사람이 명시적으로
        text = call_llm(req)
        path.write_text(json.dumps({"request": req, "response": text}, ensure_ascii=False, indent=2))
        return text
    if not path.exists():
        pytest.fail(f"녹화 없음: {path.name} (RECORD=1 로 녹화)")
    return json.loads(path.read_text())["response"]

def check(raw: str) -> bool:
    """스키마 계약 + 불변식. 녹화본과 실모델 출력에 같은 기준을 쓴다."""
    try:
        out = Summary.model_validate_json(raw)
    except ValidationError:
        return False
    cited_ok = set(out.source_ids) <= {d["id"] for d in DOCS}
    return cited_ok and all(len(b) <= 120 for b in out.bullets)

def test_summary_replay():
    req = build_request(docs=DOCS, today=TODAY)
    assert check(recorded(req))

N, MIN_PASS = 10, 8  # 예시 기준

@pytest.mark.live
def test_summary_pass_rate():
    req = build_request(docs=DOCS, today=TODAY)
    passed = sum(check(call_llm(req)) for _ in range(N))
    assert passed >= MIN_PASS, f"{passed}/{N} 통과"
live 표시는 pytest.ini의 markers에 등록하고, PR에서는 pytest -m "not live", 야간에는 pytest -m live로 나눠 돌린다.
자주 하는 실수
- 응답 문자열을 그대로 비교한다. 쉼표 하나만 달라도 실패해 결국 아무도 실패를 믿지 않게 된다.
- 녹화가 없으면 실모델로 넘어간다. CI가 몰래 과금되고, 녹화가 빠진 사실을 아무도 모른다.
- temperature 0이면 재현된다고 믿는다. 배치와 부동소수점 때문에 문장이 갈라질 수 있고, 별칭 모델은 아예 바뀐다.
- N회 테스트를 PR 차단에 쓴다. N이 작으면 같은 코드가 붙었다 떨어졌다 해 깜박이는(flaky) 테스트가 된다.
- 요청 로그에 프롬프트 버전과 검색 결과를 남기지 않는다. 운영 장애를 다시 일으킬 수 없어 추측으로 고치게 된다.
점검표
- 모델을 별칭이 아닌 스냅숏 이름으로 호출한다.
- 프롬프트 파일에 버전이 있고 요청 로그에 해시가 남는다.
- 현재 시각과 검색 결과를 함수 인자로 받아 테스트에서 고정할 수 있다.
- PR 테스트는 네트워크 없이 녹화본만으로 끝난다.
- 녹화가 없으면 테스트가 실패하고, 다시 녹화는 명시적 명령으로만 한다.
- 응답을 스키마 검증기로 파싱하는 테스트가 있다.
- 정확한 문자열 대신 불변식을 검사하고, 그 함수를 녹화본과 실모델이 함께 쓴다.
- 실모델 N회 테스트는 별도 표시로 분리해 야간에 돌린다.
- 통과율 기준과 N을 함께 적고, 기준을 깨면 N을 늘려 다시 확인한다.
- 운영 요청 로그 한 줄로 같은 조건의 재호출을 할 수 있다.
LLM의 답은 고정할 수 없지만 답 주변의 입력·버전·판정 기준은 고정할 수 있고, 그것을 층별로 나눠 고정하는 것이 재현 가능한 LLM 테스트의 전부다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.