LLM 응답을 코드가 받아 쓰는 순간부터 그 응답은 사람이 읽는 글이 아니라 시스템 사이의 데이터가 된다. 스키마를 강제하면 JSON 문법은 거의 깨지지 않지만, 값이 맞는지는 여전히 보장되지 않는다. 이 글은 구조화된 응답을 받는 네 가지 방법, 스키마 설계 규칙, 파싱·스키마·의미 3단 검증, 실패했을 때의 재시도·수리·폴백, 버전 관리와 관측 지표를 정리한 것이다.
한눈에 보기
| 방법 | 보장되는 것 | 보장되지 않는 것 | 맞는 경우 |
|---|---|---|---|
| 프롬프트로 "JSON으로 답해" | 없음(대체로 지킴) | 문법, 필드 이름, 타입 | 시제품, 사람이 다시 보는 출력 |
| JSON mode | 올바른 JSON 문법 | 필드 구성, 타입 | 필드가 자유로운 메모·요약 |
| 스키마 강제(constrained decoding) | 문법 + 스키마의 필드·타입·enum | 값의 의미, 업무 규칙 | 분류, 추출, 폼 채우기 |
| Tool use로 인자 받기 | 도구 입력 스키마 형태 | 도구를 부를지 여부(강제하지 않으면), 값의 의미 | 결과가 곧 함수 호출인 에이전트 |
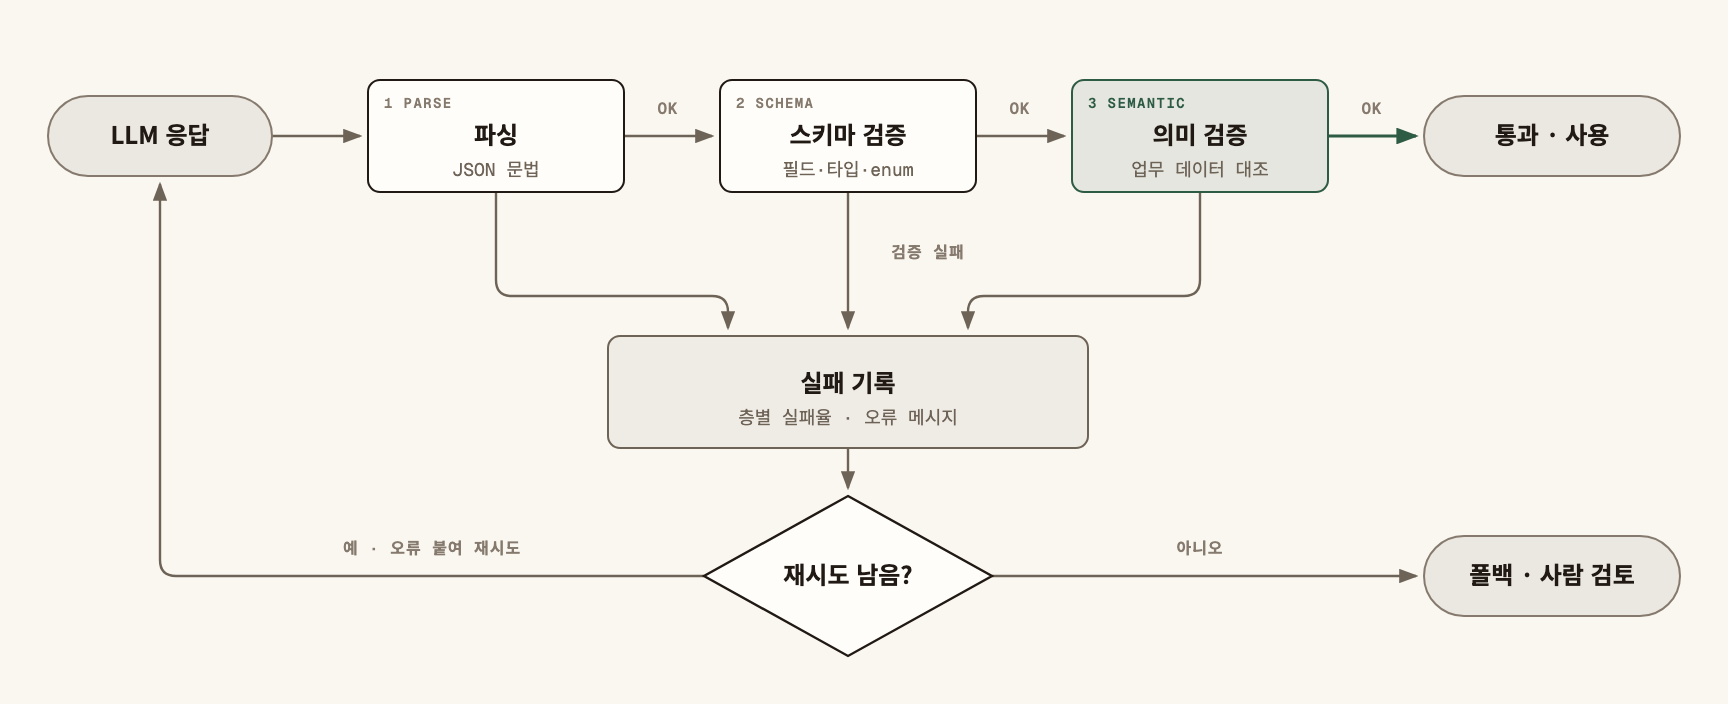
어느 방법을 쓰든 마지막 칸의 "보장되지 않는 것"은 애플리케이션이 직접 검증해야 한다. 아래 흐름이 이 글 전체의 뼈대다.
구조를 받는 네 가지 방법
프롬프트 지시는 가장 쉽고 가장 약하다. 모델이 앞뒤에 설명 문장을 붙이거나, 코드 블록 기호로 감싸거나, 따옴표를 빠뜨리면 파서가 바로 실패한다.
JSON mode는 출력이 올바른 JSON이 되도록 디코딩을 제한한다. 문법 오류는 사라지지만 category 대신 type이라는 키가 오거나 숫자가 문자열로 오는 일은 막지 못한다.
스키마 강제는 JSON Schema를 함께 보내고, 디코딩 단계에서 스키마에 맞지 않는 토큰을 고르지 못하게 한다. OpenAI는 response_format에 json_schema와 strict: true를 주는 방식이고, 다른 벤더도 비슷한 기능을 제공한다. 지원하는 JSON Schema 키워드(pattern, minLength, 중첩 깊이 등)는 벤더마다 다르므로 문서에서 확인한다.
Tool use는 도구 정의의 입력 스키마(Claude API에서는 input_schema)에 맞춘 인자를 받는다. 결과가 "어떤 함수를 이 인자로 호출하라"인 에이전트에서는 가장 자연스럽다. 도구를 반드시 부르게 하려면 tool_choice로 특정 도구를 지정한다. 지정하지 않으면 모델이 도구 대신 글로 답할 수 있다. 도구 인자가 곧 실행이 되는 구조의 위험은 AI Agent의 Tool Calling 보안과 Prompt Injection 방어에서 다뤘다.
스키마 강제가 보장하는 것과 보장하지 않는 것
스키마는 모양을 보장한다. category가 네 개 enum 중 하나이고 amount가 정수라는 것까지다. 다음은 보장하지 않는다.
- 값이 사실인가. 존재하지 않는 주문번호도 형식만 맞으면 통과한다.
- 필드 사이 규칙. "환불이면 금액이 있어야 한다" 같은 조건은 대부분의 스키마 강제 기능이 표현하지 못한다.
- 답이 끝까지 생성됐는가. 출력 토큰 상한에 걸리면 JSON이 중간에 끊긴다. 응답의 종료 사유(stop reason)가 길이 초과인지 먼저 본다.
- 거절. 안전 정책으로 거절하면 스키마 밖의 응답이 올 수 있다. 파싱 실패와 섞어 세면 원인을 잘못 짚는다.
그래서 스키마 강제를 켜도 검증은 뺄 수 없다. LLM 응답은 시스템 경계로 들어오는 외부 입력이다.
스키마 설계 규칙
할 일
- 자유 문자열 대신 enum. 분류 결과를
string으로 받으면 "환불", "환불 요청", "refund"가 섞인다. 값의 집합이 정해져 있으면 enum으로 닫고, 애매한 입력을 위한other를 하나 둔다.other가 없으면 모델이 가장 가까운 값을 억지로 고른다. - 모르면 null. 입력에 없는 값을 채우라고 하면 지어낸다. "없으면 null"을 허용하고 설명(
description)에 그 규칙을 적는다. strict 모드에서는 모든 필드를required에 넣어야 하는 경우가 많으므로, 선택 필드는["string", "null"]처럼 null을 허용하는 타입으로 표현한다. - 필드는 짧고 평평하게. 중첩이 깊을수록 생성 토큰과 실패 지점이 늘어난다. 같은 정보를 두 번 쓰게 하는 필드는 하나로 줄인다.
- 근거 필드는 결론 앞에. 모델은 앞에서부터 순서대로 생성한다.
reason필드를category앞에 두면 결론을 쓰기 전에 근거를 먼저 적게 할 수 있다. 근거가 그럴듯하다고 결론이 맞는 것은 아니므로 길이 상한만 둔다. additionalProperties: false. 모르는 키가 섞여 들어오면 하위 코드가 조용히 무시하다가 나중에 혼란을 만든다.
산출물: 스키마 파일 하나를 단일 원천으로 두고, 모델에 보내는 JSON Schema와 검증 코드를 모두 여기서 만든다. Pydantic이면 model_json_schema()를 쓴다. 손으로 두 벌을 관리하면 어긋난다.
3단 검증: 파싱, 스키마, 의미
층마다 실패의 의미와 대응이 달라서 검증을 세 층으로 나눈다.
- 파싱: 문자열이 JSON인가. 실패하면 대개 잘림이나 앞뒤 군더더기다.
- 스키마: 필드·타입·enum·필드 사이 규칙이 맞는가. 실패하면 모델이 형식을 어긴 것이다.
- 의미: 값이 업무 데이터와 맞는가. 주문번호가 실제로 있는지, 금액이 주문 금액을 넘지 않는지. 실패하면 모델이 사실을 틀린 것이다.
Pydantic v2로 쓰면 1·2단이 model_validate_json 한 번에 끝나고, 3단은 데이터 조회가 필요하므로 따로 둔다.
# Python 3.10 이상, Pydantic v2
from typing import Annotated, Literal
from pydantic import BaseModel, Field, StringConstraints, model_validator

OrderId = Annotated[str, StringConstraints(pattern=r"^ORD-\d{8}$")]

class Ticket(BaseModel):
    schema_version: Literal["2"]
    reason: Annotated[str, Field(max_length=200)]   # 결론보다 앞에 둔다
    category: Literal["refund", "exchange", "inquiry", "other"]
    order_id: OrderId | None
    amount: Annotated[int, Field(ge=0)] | None

    @model_validator(mode="after")
    def refund_needs_order(self):
        if self.category == "refund" and (self.order_id is None or self.amount is None):
            raise ValueError("refund에는 order_id와 amount가 필요하다")
        return self

def parse_ticket(raw: str, orders: dict[str, int]) -> Ticket:
    t = Ticket.model_validate_json(raw)              # 1단 파싱 + 2단 스키마
    if t.order_id is not None:                       # 3단 의미 검증
        if t.order_id not in orders:
            raise ValueError(f"없는 주문번호: {t.order_id}")
        if t.amount is not None and t.amount > orders[t.order_id]:
            raise ValueError("환불 금액이 주문 금액보다 크다")
    return t
model_validate_json은 JSON 문법 오류도 ValidationError로 올리고, 이 예외는 ValueError의 하위 클래스다. 지표를 층별로 나누려면 ValidationError를 먼저 잡아 구분한다.
실패 처리: 재시도, 수리, 폴백
| 실패 층 | 첫 대응 | 두 번째 대응 | 하지 말 것 |
|---|---|---|---|
| 잘림(종료 사유가 길이) | 출력 상한을 올리거나 필드를 줄인다 | 입력을 나눠 여러 번 묻는다 | 같은 설정으로 재시도 |
| 파싱·스키마 실패 | 오류 메시지를 붙여 한 번 재시도 | 폴백 | 정규식으로 JSON을 오려 내기 |
| 의미 실패 | 근거 데이터(주문 목록 등)를 붙여 재시도 | 사람 검토 큐 | 그럴듯한 값으로 자동 보정 |
| 거절 | 재시도하지 않고 기록 | 정책 검토 | 프롬프트를 바꿔 우회 |
재시도는 "다시 해"가 아니라 무엇이 틀렸는지를 붙여야 효과가 있다. 검증 오류 문자열을 그대로 다음 메시지에 넣는다.
def classify(text, call_llm, orders, max_attempts=2):
    messages = [{"role": "user", "content": text}]
    for _ in range(max_attempts):
        raw = call_llm(messages)
        try:
            return parse_ticket(raw, orders)
        except ValueError as e:                      # ValidationError 포함
            messages += [
                {"role": "assistant", "content": raw},
                {"role": "user", "content": f"응답이 규칙을 어겼다. 아래 오류만 고쳐 같은 형식으로 다시 답하라.\n{e}"},
            ]
    return None                                      # 폴백: 호출한 쪽이 사람 검토 큐로 보낸다
재시도는 1~2회로 제한한다. 재시도마다 토큰과 지연이 늘고, 트래픽이 몰리면 호출 한도를 먼저 소진한다. 한도와 재시도를 함께 설계하는 방법은 Rate Limiting 알고리즘 비교와 분산 환경 구현에 정리했다. 수리(잘린 JSON의 괄호를 닫아 주는 식의 기계적 복구)는 필드 값이 바뀌지 않는 경우에만 쓰고, 값을 추측해 채우는 수리는 하지 않는다. 생성과 검수를 다른 에이전트로 나누는 구조는 Maker–Checker Loop로 AI Agent 결과물 검증하기를 참고한다.
스키마 버전 관리와 관측 지표
스키마는 LLM과 애플리케이션 사이의 계약이다. 필드를 바꾸면 저장된 과거 결과, 그 결과를 읽는 하위 서비스, 회귀 테스트 데이터가 함께 영향을 받는다.
- 응답에
schema_version을 넣고, 읽는 쪽은 버전별로 분기한다. - 필드 추가는 null 허용으로 먼저 넣고, 소비자가 모두 읽게 된 뒤에 필수로 바꾼다. 필드 삭제는 그 반대 순서다.
- 스키마를 바꾸면 고정된 입력 세트로 이전 버전과 결과를 비교한다. 비결정성을 줄인 회귀 테스트 구성은 LLM 서비스의 비결정성과 재현 가능한 테스트 설계와 AI Agent Eval 파이프라인과 회귀 테스트 자동화에서 다뤘다. 계약을 테스트로 묶는 발상은 Contract Testing으로 Frontend·Backend API 호환성 검증과 같다.
| 지표 | 무엇을 알려 주나 | 없으면 생기는 일 |
|---|---|---|
| 층별 실패율(파싱·스키마·의미) | 어느 층이 깨지는지 | 프롬프트만 계속 고친다 |
| 재시도율, 재시도 후 성공률 | 재시도가 실제로 도움이 되는지 | 비용만 늘어난 재시도를 모른다 |
| 폴백율 | 사람에게 넘어가는 비율 | 검토 큐가 넘친 뒤에야 안다 |
| 잘림·거절 건수 | 설정·정책 문제 | 모델 품질 문제로 오판한다 |
| 스키마·모델 버전별 분포 | 변경의 영향 | 배포 뒤 품질 저하의 원인을 못 찾는다 |
자주 하는 실수
- 스키마 강제를 켰으니 검증을 뺀다. 모양은 맞아도 값이 틀린 응답이 그대로 DB에 들어간다.
- 선택 필드를 비우지 못하게 만든다. null을 허용하지 않으면 모델은 입력에 없는 값을 지어내 채운다.
- 오류 내용 없이 같은 요청을 다시 보낸다. 같은 조건이면 같은 실패가 반복되고 비용만 두 배가 된다.
- 스키마를 코드와 프롬프트에 따로 적는다. 한쪽만 바뀌면 검증은 통과하는데 모델은 옛 형식으로 답하는 일이 생긴다.
- 실패를 한 숫자로만 센다. 잘림, 거절, 의미 오류는 고치는 곳이 전혀 다르다.
점검표
- 구조화 응답에 스키마 강제나 tool use를 쓰고, 프롬프트 지시에만 기대지 않는다.
- 분류 필드는 enum이고
other값이 있다. - 입력에 없을 수 있는 필드는 null을 허용하고, 설명에 "없으면 null"이라고 적었다.
- 모델에 보내는 JSON Schema와 검증 코드가 한 원천에서 만들어진다.
- 파싱·스키마·의미 검증을 층별로 나눠 실패를 기록한다.
- 응답의 종료 사유를 확인해 잘림을 따로 처리한다.
- 재시도는 1~2회이고, 검증 오류 내용을 붙여 보낸다.
- 재시도 후에도 실패하면 사람 검토 큐 같은 폴백으로 간다.
- 응답에
schema_version이 있고, 스키마 변경 때 고정 입력 세트로 회귀 비교를 한다. - 층별 실패율, 재시도율, 폴백율을 대시보드에서 본다.
스키마 강제는 응답의 모양을 맞춰 줄 뿐이므로, LLM 응답을 외부 입력으로 보고 파싱·스키마·의미 세 층에서 검증하고, 실패는 층별로 세어 재시도와 폴백을 정해 두어야 운영에서 믿고 쓸 수 있다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.