수억 건짜리 테이블은 조회보다 관리에서 먼저 무너진다. 오래된 데이터를 지우는 DELETE가 몇 시간씩 돌고, VACUUM이 끝나지 않고, 인덱스 하나 만들 때마다 서비스 점검 공지를 낸다. 이 글은 PostgreSQL 선언적 파티셔닝으로 이 문제를 푸는 방법을 정리한다. 방식 고르기, partition pruning 확인, 제약과 인덱스 만들기, 파티션 수명 관리, 운영 중인 큰 테이블을 옮기는 절차까지 다룬다.
한눈에 보기
| 문제 | 파티셔닝으로 얻는 것 | 대가 |
|---|---|---|
| 오래된 데이터 삭제가 느리다 | 파티션 하나를 떼어 내 DROP |
파티션을 미리 만들고 떼는 배치가 필요 |
| 최근 데이터만 읽는데 전체를 훑는다 | 조건에 맞는 파티션만 읽는 pruning | 조건에 파티션 키가 없으면 효과 없음 |
| VACUUM·인덱스 작업이 한 번에 너무 크다 | 파티션 단위로 나눠 실행 | 부모 테이블 통계는 따로 챙겨야 함 |
| 기본키 하나로 전체 유일성을 보장했다 | 그대로는 안 된다 | PK·UNIQUE에 파티션 키를 넣어야 함 |
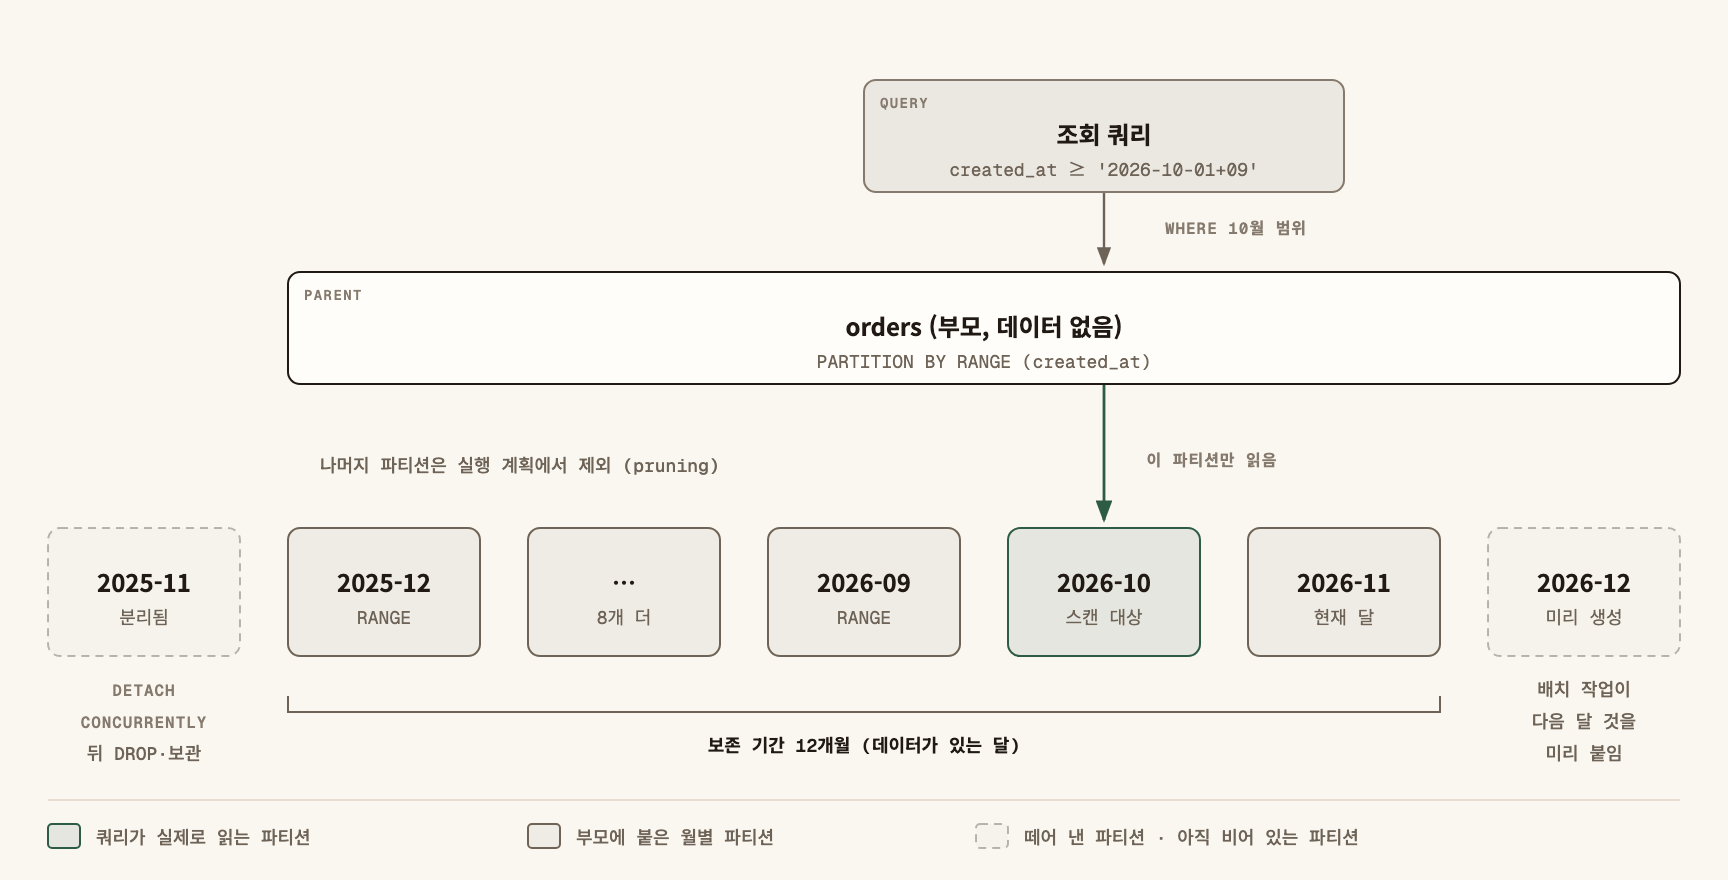
부모 테이블 orders는 데이터를 갖지 않는다. 행은 모두 월별 파티션에 들어가고, 조회 조건이 10월 범위면 실행 계획에는 10월 파티션만 남는다.
방식 고르기: RANGE, LIST, HASH
파티셔닝은 "자주 지우는 단위"와 "자주 거르는 조건"이 같을 때 가장 효과가 크다. 로그·주문·이력처럼 시간이 지나면 버리는 데이터가 대표적이다. 반대로 수백만 건 수준이거나 조회 조건이 제각각이면 인덱스 정비가 먼저다.
| 방식 | 나누는 기준 | 맞는 데이터 | 주의 |
|---|---|---|---|
| RANGE | 값의 구간 (날짜) | 주문, 로그, 이력 | 다음 구간을 미리 만들어야 함 |
| LIST | 정해진 값 목록 | 지역, 테넌트 등급 | 새 값이 생기면 받을 곳이 필요 |
| HASH | 키의 해시 나머지 | 고르게 쪼갤 기준이 없을 때 | 개수를 늘리려면 데이터를 다시 나눠야 함 |
CREATE TABLE orders (
    id          bigserial,
    customer_id bigint      NOT NULL,
    amount      numeric(12,2) NOT NULL,
    created_at  timestamptz NOT NULL,
    PRIMARY KEY (id, created_at)
) PARTITION BY RANGE (created_at);

CREATE TABLE orders_2026_10 PARTITION OF orders
    FOR VALUES FROM ('2026-10-01 00:00+09') TO ('2026-11-01 00:00+09');
RANGE 경계는 FROM을 포함하고 TO는 포함하지 않는다. timestamptz 경계는 만들 때의 세션 시간대로 해석되므로 +09처럼 오프셋을 직접 적는다. 선언적 파티셔닝은 PostgreSQL 10부터, HASH·DEFAULT 파티션과 파티션 테이블의 기본키는 11부터 쓸 수 있다. 쓰는 버전의 기능은 PostgreSQL 공식 문서에서 확인한다.
파티션 키와 partition pruning
파티셔닝의 조회 이득은 pruning 하나에서 나온다. 조건에 파티션 키가 그대로 들어가야 플래너가 읽지 않을 파티션을 지운다.
-- 10월 파티션만 읽는다
EXPLAIN SELECT count(*) FROM orders
WHERE created_at >= '2026-10-01 00:00+09' AND created_at < '2026-11-01 00:00+09';

-- 모든 파티션을 읽는다: 키를 함수로 감쌌다
EXPLAIN SELECT count(*) FROM orders
WHERE date_trunc('month', created_at) = '2026-10-01 00:00+09';
두 번째 쿼리는 계획에 Append 아래로 모든 파티션이 늘어선다. 컬럼을 함수나 형변환으로 감싸면 인덱스를 못 타는 것과 같은 이유다. 그 원리는 DB 인덱스가 있는데도 Full Scan이 발생하는 이유에서 다뤘다.
now()나 바인드 변수처럼 실행할 때 값이 정해지는 조건은 실행 시작 시점에 걸러진다. 이때는 EXPLAIN ANALYZE 결과의 Subplans Removed: N으로 확인한다. 파티션 키는 거의 모든 중요한 쿼리의 WHERE에 들어가는 컬럼으로 고른다.
기본키·유니크 제약과 인덱스
파티션 테이블의 PK와 UNIQUE 제약은 파티션 키 컬럼을 모두 포함해야 한다. 각 파티션이 자기 안에서만 유일성을 검사하기 때문이다. 그래서 위 예시의 PK는 id 하나가 아니라 (id, created_at)이다. id만으로 전체 유일성이 꼭 필요하면 시퀀스로 값을 보장하고, 다른 테이블이 이 테이블을 참조하는 외래키 설계도 다시 본다.
부모에 CREATE INDEX를 걸면 모든 파티션에 인덱스가 만들어진다. 다만 파티션 테이블에는 CONCURRENTLY를 쓸 수 없어 쓰기가 막힌다. 운영 중에는 세 단계로 나눈다.
-- 1. 부모에만 빈 인덱스(아직 INVALID)
CREATE INDEX orders_customer_idx ON ONLY orders (customer_id);

-- 2. 파티션마다 잠금 없이 생성
CREATE INDEX CONCURRENTLY orders_2026_10_customer_idx ON orders_2026_10 (customer_id);

-- 3. 부모 인덱스에 붙인다. 모든 파티션이 붙으면 부모 인덱스가 VALID가 된다
ALTER INDEX orders_customer_idx ATTACH PARTITION orders_2026_10_customer_idx;
파티션 수명 관리: 미리 만들기, DEFAULT, 떼어 내기
미리 만들기. RANGE 파티션은 다음 구간이 없으면 그 시각부터 INSERT가 실패한다. 매일 도는 배치가 2~3개월 앞까지 만들어 두게 한다. CREATE TABLE ... PARTITION OF는 부모에 ACCESS EXCLUSIVE 잠금을 잡는다. 바쁜 테이블이면 따로 만든 테이블을 ATTACH PARTITION으로 붙인다. 이쪽은 부모에 SHARE UPDATE EXCLUSIVE만 잡는다(PostgreSQL 12 이상). 이 작업을 대신하는 확장으로 pg_partman이 있지만, 코어 기능이 아니라 설치가 필요한 확장이다.
DEFAULT 파티션. 어느 구간에도 맞지 않는 행을 받아 주니 안전해 보이지만 함정이 있다. 새 파티션을 만들 때마다 PostgreSQL이 DEFAULT 파티션을 훑어 새 구간에 해당하는 행이 없는지 확인한다. 거기 행이 쌓이면 파티션 생성이 느려지고, 겹치는 행이 있으면 실패한다. 또 DEFAULT가 있으면 DETACH ... CONCURRENTLY를 쓸 수 없다. 미리 만들기 배치를 믿을 수 있다면 DEFAULT는 두지 않는다. 둔다면 행 수를 감시한다.
떼어 내기. 보존 기간이 지난 파티션은 떼어 낸 뒤 지운다.
ALTER TABLE orders DETACH PARTITION orders_2025_11 CONCURRENTLY;
DROP TABLE orders_2025_11;   -- 보관이 필요하면 pg_dump 뒤에 지운다
DETACH ... CONCURRENTLY는 PostgreSQL 14부터 있고 트랜잭션 블록 안에서는 실행할 수 없다. 중간에 끊기면 ALTER TABLE orders DETACH PARTITION orders_2025_11 FINALIZE;로 마무리한다. 수천만 건 DELETE와 달리 파일을 통째로 지우므로 VACUUM 부담도 남지 않는다.
운영 중인 큰 테이블을 파티션으로 옮기기
일반 테이블을 파티션 테이블로 바꾸는 ALTER 명령은 없다. 전체를 복사하면 시간과 디스크가 두 배로 든다. 기존 테이블을 "과거 전체를 담은 파티션 하나"로 붙이는 방법이 가장 짧다.
- 같은 컬럼의 새 부모
orders_p를PARTITION BY RANGE (created_at)로 만든다. PK는(id, created_at). - 기존 테이블에 범위 CHECK를
NOT VALID로 걸고VALIDATE CONSTRAINT로 검증한다. 검증은 쓰기를 막지 않는다. 이 CHECK 덕분에created_at SET NOT NULL도 전체를 훑지 않는다(PostgreSQL 12 이상). (id, created_at)유니크 인덱스를CONCURRENTLY로 미리 만든다. 제약 없는 인덱스는 부모 PK에 붙지 않으므로, 이 인덱스로 PK를 바꿔 둬야ATTACH가 인덱스를 새로 만들며 오래 잠그지 않는다. 기존 PK(id)를 참조하는 외래키는 먼저 정리한다.- 짧은 트랜잭션에서
lock_timeout을 걸고 PK를 바꾸고, 이름을 바꾼 뒤ATTACH PARTITION한다. - 다음 달부터는 월별 파티션에 쌓이고, 과거 덩어리는 보존 기간이 지나면 통째로 지운다.
ALTER TABLE orders ADD CONSTRAINT orders_range_chk
    CHECK (created_at IS NOT NULL AND created_at < '2026-12-01 00:00+09') NOT VALID;
ALTER TABLE orders VALIDATE CONSTRAINT orders_range_chk;
ALTER TABLE orders ALTER COLUMN created_at SET NOT NULL;
CREATE UNIQUE INDEX CONCURRENTLY orders_id_created_uk ON orders (id, created_at);

BEGIN;
SET LOCAL lock_timeout = '3s';
ALTER TABLE orders DROP CONSTRAINT orders_pkey;
ALTER TABLE orders ADD CONSTRAINT orders_legacy_pkey
    PRIMARY KEY USING INDEX orders_id_created_uk;
ALTER TABLE orders RENAME TO orders_legacy;
ALTER TABLE orders_p RENAME TO orders;
ALTER TABLE orders ATTACH PARTITION orders_legacy
    FOR VALUES FROM (MINVALUE) TO ('2026-12-01 00:00+09');
COMMIT;
CHECK가 파티션 조건을 이미 보장하므로 ATTACH가 전체를 다시 훑지 않는다. 기본값·시퀀스·외래키·권한·트리거는 새 부모로 옮겨야 하니 목록을 만들어 대조한다. 과거 데이터를 월별로 다시 쪼개야 한다면 묶음 단위로 옮긴다. 그 방법은 대량 데이터 처리에서 Cursor·Batch·Bulk Insert 비교를 참고한다.
운영 비용: autovacuum, 통계, 파티션 개수
| 항목 | 일어나는 일 | 대응 |
|---|---|---|
| autovacuum | 파티션마다 따로 돌아 작업이 작아진다 | 쓰기가 몰리는 최신 파티션의 설정만 조정 |
| 부모 통계 | 부모는 데이터가 없어 autovacuum이 ANALYZE하지 않는다 |
배치에서 부모에 ANALYZE 실행 |
| 파티션 개수 | pruning이 안 되는 쿼리는 모든 파티션을 계획·잠금 | 개수를 늘리기 전에 계획 시간 측정 |
| 파티션 간 조회 | 넓은 기간 집계는 여전히 많이 읽는다 | 분석 쿼리는 별도 저장소로 분리 |
일 단위로 나눠 몇 년을 보관하면 파티션이 수천 개가 된다. 이때 조건 없는 쿼리 하나가 계획 시간과 메모리를 크게 늘린다. 보존 기간과 조회 범위를 보고 월 단위로 시작하는 편이 안전하다. 몇 년치를 훑는 집계가 주 용도라면 파티셔닝보다 OLTP와 OLAP 아키텍처 분리가 맞는 답이다.
자주 하는 실수
- 파티션 키를 조회 조건과 다른 컬럼으로 잡는다.
created_at으로 나누고order_date로 조회하면 pruning이 일어나지 않고, 파티션 수만큼 느려진다. - 조건에서 키를 함수로 감싼다.
date_trunc,::date같은 변환은 모든 파티션을 읽게 만든다. 범위 조건으로 바꿔 쓴다. timestamptz경계를 오프셋 없이 적는다. 만든 세션의 시간대로 해석돼 월 경계가 9시간 어긋날 수 있다.- 미리 만들기 배치를 감시하지 않는다. 배치가 한 번 실패한 채로 다음 달 1일 0시가 지나면 모든
INSERT가 실패한다. - DEFAULT 파티션에 행이 쌓이는 것을 방치한다. 다음 파티션 생성이 실패하고, 떼어 내기도
CONCURRENTLY없이 해야 한다.
점검표
- 주요 쿼리의
WHERE에 파티션 키가 함수 없이 들어간다. - 주요 쿼리
EXPLAIN에서 필요한 파티션만 남는 것을 확인했다. - PK·UNIQUE 제약에 파티션 키가 포함돼 있다.
-
timestamptz경계에 오프셋(+09)을 적었다. - 배치가 최소 2개월 앞 파티션까지 만들고, 실패하면 알림이 온다.
- DEFAULT 파티션이 없거나, 있다면 행 수를 감시한다.
- 보존 기간이 지난 파티션을
DETACH ... CONCURRENTLY뒤 지우는 절차가 있다. - 운영 중 인덱스는
ON ONLY→CONCURRENTLY→ATTACH순서로 만든다. - 부모 테이블
ANALYZE가 배치에 들어 있다. - 쓰는 PostgreSQL 버전에서 위 기능이 지원되는지 공식 문서로 확인했다.
파티셔닝은 큰 테이블을 빠르게 만드는 기술이라기보다, 지우고 고치는 단위를 작게 만드는 기술이다. 파티션 키를 조회 조건에 맞추고, 만들기와 떼어 내기를 배치로 돌리면 수억 건 테이블도 월 단위 작은 테이블처럼 다룰 수 있다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.