AI Agent의 비용은 호출 한 번의 단가보다 루프가 몇 바퀴 도는지, 바퀴마다 무엇을 다시 보내는지에서 결정된다. 이 글은 Agent 비용이 생기는 지점을 작업 단위로 재는 법, 쉬운 일을 작은 모델에 보내는 Model Routing, 작업마다 한도를 거는 Token Budget, 그리고 컨텍스트 줄이기·Prompt Caching·Batch 처리까지 순서대로 정리한다.
한눈에 보기
| 레버 | 줄이는 것 | 대가 |
|---|---|---|
| 작업 단위 측정 | 보이지 않던 낭비(재시도, 실패 작업) | 로그 필드 몇 개 추가 |
| Model Routing | 쉬운 작업의 단가 | 잘못 보내면 품질 저하, 검사 비용 |
| Token Budget | 끝없이 도는 루프, 긴 출력 | 한도에 걸린 작업은 부분 결과 |
| 컨텍스트 줄이기 | 바퀴마다 다시 보내는 입력 | 요약 과정에서 정보 손실 |
| Prompt Caching | 같은 앞부분의 입력 단가 | 프롬프트 순서를 고정해야 함 |
| Batch·캐시 | 실시간이 아닌 작업, 반복 질문 | 응답 지연, 캐시 오염 위험 |
순서가 중요하다. 재지 않고 줄이면 무엇이 줄었는지 알 수 없다. 그래서 측정이 먼저이고, 라우팅과 예산은 그다음이다.
비용은 어디서 나오나
Agent는 모델을 한 번 부르고 끝나지 않는다. 모델이 도구를 부르고, 도구 결과를 받아 다시 모델을 부른다. 이때 모델은 상태를 기억하지 않으므로 지금까지의 대화 전체를 매번 다시 입력으로 보낸다.
예시로 계산해 보자. 시스템 프롬프트와 도구 정의가 3,000토큰, 사용자 요청이 500토큰이다. 한 바퀴마다 모델 출력 300토큰과 도구 결과 1,500토큰이 기록에 쌓인다.
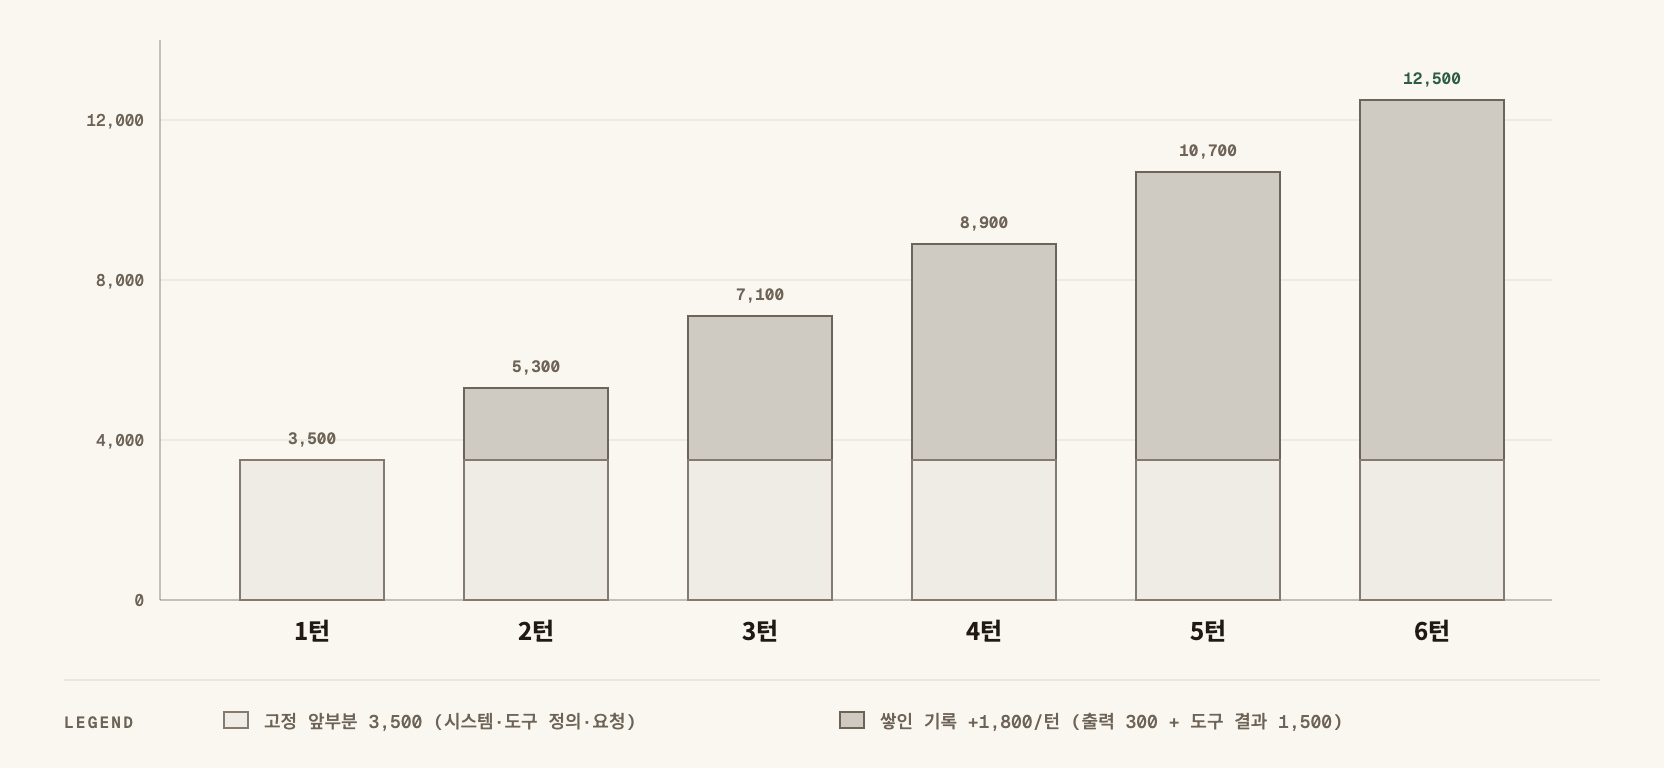
- 6턴 입력 합계: 3,500 + 5,300 + 7,100 + 8,900 + 10,700 + 12,500 = 48,000토큰 (예시)
- 6턴 출력 합계: 300 × 6 = 1,800토큰
출력 단가가 입력보다 비싼 요금제가 일반적이지만, 출력 단가를 입력의 5배로 잡아도 출력 쪽은 입력 9,000토큰어치다. 이 작업 비용의 대부분은 다시 보낸 입력이다. 여기에 세 가지가 더 붙는다.
- 도구 결과: 로그 파일 전체, 검색 결과 50건 같은 큰 출력이 한 번 들어오면 이후 모든 턴에 따라다닌다.
- 재시도: 형식 오류나 일시 장애로 같은 호출을 다시 하면 그 턴의 입력을 통째로 다시 낸다.
- 실패한 작업: 끝까지 돌고 결과를 버린 작업도 같은 돈을 쓴다.
호출이 아니라 작업 단위로 잰다
호출당 비용만 보면 위의 낭비가 보이지 않는다. 호출마다 아래 필드를 남기고, 같은 task_id로 묶는다.
{"task_id": "t-1042", "step": 3, "model": "small", "input_tokens": 7100,
 "cached_input_tokens": 5300, "output_tokens": 300, "retry": 0,
 "outcome": "tool_call"}
지표는 성공한 작업 하나당 비용으로 둔다. 실패·포기한 작업의 비용도 분자에 넣는다. 그래야 "싼 모델로 바꿨더니 실패가 늘어 오히려 비싸졌다"가 숫자로 드러난다. 같은 이유로 비용 지표는 품질 지표와 함께 본다. 품질 회귀를 잡는 방법은 AI Agent Eval 파이프라인과 회귀 테스트 자동화에 정리했다.
Model Routing: 쉬운 일은 작은 모델로
모든 작업을 가장 큰 모델에 보낼 이유는 없다. 분류, 추출, 짧은 요약은 작은 모델로도 대부분 맞는다. 라우팅 방식은 세 가지다.
- 규칙 기반: 작업 유형으로 정한다.
classify,extract는 작은 모델,plan,code_change는 큰 모델. 가장 단순하고 예측 가능하다. - 분류기 라우터: 작은 모델이나 별도 분류기가 요청 난이도를 먼저 판정한다. 유형만으로 구분이 안 될 때 쓴다. 라우터 호출 비용과 잘못 보낸 비율을 같이 재야 한다.
- Cascade: 일단 작은 모델로 풀고, 검사를 통과하지 못하면 큰 모델로 올린다. 검사는 JSON 스키마 검증, 테스트 실행, 인용 근거 확인처럼 기계적으로 판정할 수 있어야 한다.
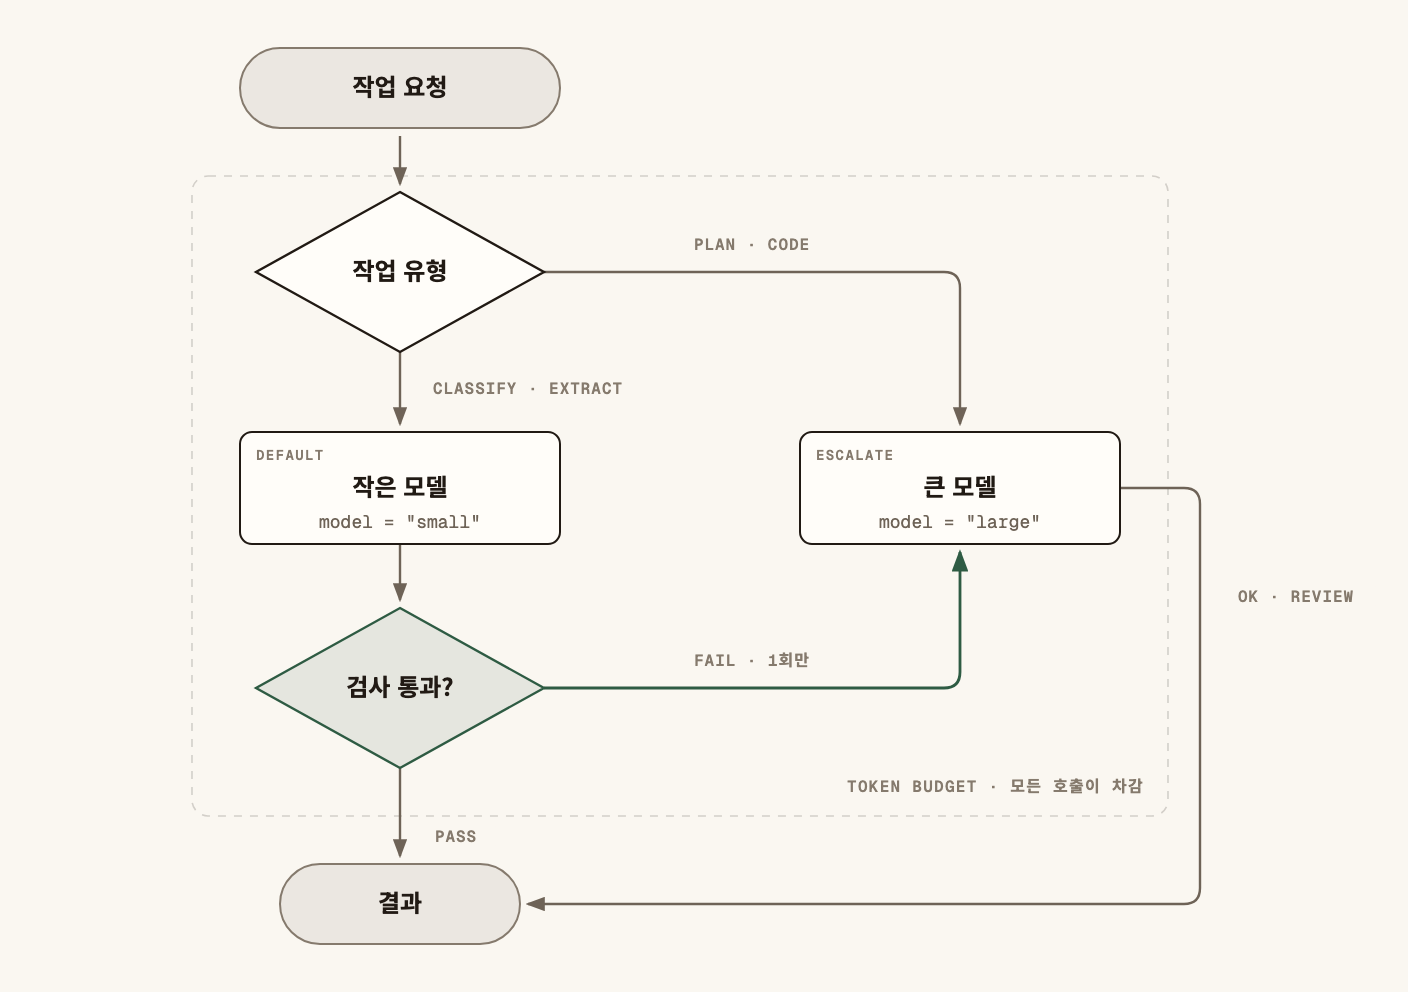
Cascade를 예시로 계산해 보자. 작은 모델 작업 단가를 a, 큰 모델을 10a로 두고 작업 1,000건 중 80%가 작은 모델에서 검사를 통과한다고 하자.
- 전부 큰 모델: 1,000 × 10a = 10,000a
- Cascade: 1,000 × a + 200 × 10a = 3,000a (올라간 200건은 두 번 낸다)
이 예시에서는 70%가 줄지만, 통과율이 낮아지면 이득이 빠르게 줄어든다. 통과율이 10%면 1,000a + 900 × 10a = 10,000a로 전부 큰 모델과 같아진다. 통과율은 운영 로그로 계속 확인한다.
Token Budget: 작업과 단계마다 한도
라우팅이 단가를 줄인다면 예산은 양을 막는다. 한도는 세 겹으로 건다.
- 단계 수(
max_steps): 같은 도구를 반복 호출하는 루프를 끊는다. - 작업 토큰 합계(
max_tokens): 입력과 출력을 합친 상한. - 호출당 출력(
max_output): 장황한 답을 막는다.
한도에 닿았을 때 그냥 예외를 던지면 그때까지 쓴 비용이 전부 버려진다. 남은 예산이 줄면 마무리 모드로 바꾸고, 한도를 넘으면 부분 결과와 상태를 돌려준다. 아래는 프레임워크에 묶이지 않은 스케치다. call_llm은 쓰는 SDK를 감싼 함수이고, usage 키 이름은 공급자 응답에 맞춘다.
from dataclasses import dataclass

ROUTES = {"classify": "small", "extract": "small", "summarize": "small",
          "code_change": "large", "plan": "large"}

@dataclass
class Budget:
    max_steps: int = 8
    max_tokens: int = 60_000   # 작업 하나가 쓸 입력+출력 토큰 합
    used: int = 0
    steps: int = 0

    def charge(self, usage):
        self.used += usage["input_tokens"] + usage["output_tokens"]
        self.steps += 1

    def left(self):
        return self.max_tokens - self.used

    def exhausted(self):
        return self.steps >= self.max_steps or self.left() <= 0


def run_task(task, call_llm, check):
    budget = Budget()
    model = ROUTES.get(task["type"], "small")
    messages = [task["prompt"]]
    while not budget.exhausted():
        wrap_up = budget.left() < budget.max_tokens * 0.2   # 남은 예산 20% 미만이면 마무리 모드
        reply, usage = call_llm(model, messages,
                                max_output=512 if wrap_up else 2048, wrap_up=wrap_up)
        budget.charge(usage)
        if reply["done"]:
            if check(reply):
                return {"status": "ok", "model": model, "tokens": budget.used, "result": reply["text"]}
            if model == "large":
                return {"status": "needs_review", "model": model, "tokens": budget.used, "result": reply["text"]}
            model = "large"            # 검사 실패: 큰 모델로 한 번만 올린다
            continue
        messages += reply["messages"]  # 모델 응답과 도구 결과
    return {"status": "partial", "model": model, "tokens": budget.used, "result": messages[-1]}
한도는 호출 전에 검사하므로 마지막 호출 하나만큼 넘을 수 있다. 정확히 막아야 하면 호출 전에 입력 토큰을 세어 비교한다. 예산 값은 처음부터 정하지 말고 작업 유형별 로그의 상위 퍼센타일을 보고 정한다.
컨텍스트 줄이기와 Prompt Caching
다시 보내는 입력을 줄이는 방법은 두 갈래다. 보내는 양을 줄이거나, 같은 부분을 싸게 보내는 것이다.
줄이기
- 큰 도구 결과는 앞부분 N줄과 파일 경로만 넣고, 나머지는 필요할 때 다시 읽게 한다.
- 오래된 턴은 요약으로 바꾼다. 요약은 결정 사항과 남은 할 일을 남기고 원문 로그를 버린다.
- 이번 단계에 필요 없는 도구 정의는 뺀다. 도구가 많으면 정의만으로 수천 토큰이 된다.
어떤 계층의 정보를 언제 컨텍스트에 올릴지는 AI Agent의 Context Engineering과 메모리 계층 설계에서 자세히 다뤘다.
Prompt Caching
공급자 대부분이 같은 앞부분(prefix)을 다시 보낼 때 낮은 단가를 적용하는 캐시를 제공한다. 위 예시에서 6턴 입력 48,000토큰 중 35,500토큰(74%)은 바로 앞 호출과 같은 앞부분이다.
- 변하지 않는 것(시스템 프롬프트, 도구 정의, 고정 문서)을 앞에, 변하는 것을 뒤에 둔다.
- 시스템 프롬프트에 현재 시각이나 요청 ID를 넣지 않는다. 한 글자만 바뀌어도 그 뒤가 전부 캐시를 벗어난다.
- 기록 중간을 요약으로 바꾸면 그 지점부터 캐시가 깨진다. 요약은 자주 하지 말고 묶어서 한다.
자동 적용 여부, 최소 길이, 유지 시간은 공급자마다 다르니 문서를 확인하고 로그의 cached_input_tokens로 실제 적중을 본다.
Batch와 응답 캐시
야간 리포트, 대량 분류처럼 즉시 답이 필요 없는 작업은 Batch API(OpenAI Batch API, Anthropic Message Batches API 등)로 보내면 할인된 단가를 받는 대신 결과가 늦게 온다. 같은 질문이 반복되는 서비스라면 응답 캐시도 쓴다. 다만 비슷한 질문에 다른 답이 필요한 경우를 가려야 한다. 이 부분은 LLM Semantic Cache 설계와 캐시 오염 방지에, 자체 서빙 모델의 단가를 낮추는 방법은 LLM Inference 최적화: KV Cache·Quantization·Batching에 정리했다. 검색 단계를 Agent가 여러 번 도는 구조는 Agentic RAG와 일반 RAG의 아키텍처 차이에서 비용 관점으로도 다룬다.
정리 표
| 장치 | 어디에 거나 | 없으면 생기는 일 |
|---|---|---|
task_id 묶음 로그 |
모든 호출 | 비싼 작업 유형을 찾지 못한다 |
| 작업 유형 라우팅 표 | 작업 시작 | 분류 작업에도 큰 모델 단가를 낸다 |
| Cascade 검사 | 작은 모델 결과 뒤 | 틀린 결과가 그대로 나가거나 전부 큰 모델로 간다 |
max_steps·max_tokens |
루프 매 바퀴 | 도구를 반복 호출하는 작업 하나가 하루 예산을 쓴다 |
| 마무리 모드·부분 결과 | 예산 80% 지점 | 한도에 걸린 작업의 비용이 전부 버려진다 |
| 고정 앞부분 | 프롬프트 구성 | 캐시 적중이 0에 가깝다 |
자주 하는 실수
호출당 평균 비용만 본다. 턴 수와 재시도가 늘어나는 변화가 평균에 묻힌다.
검사 없이 Cascade를 건다. 작은 모델이 "완료"라고 하면 그대로 나가므로 비용은 줄고 품질만 떨어진다.
한도에 닿으면 예외로 끝낸다. 그때까지 쓴 토큰이 결과 없이 사라지고, 사용자는 같은 요청을 다시 보내 비용이 두 배가 된다.
시스템 프롬프트 맨 앞에 시각을 넣는다. 매 호출 앞부분이 달라져 Prompt Caching이 걸리지 않는다.
재시도를 무조건 한다. 스키마 오류처럼 같은 입력이면 같은 실패가 나는 오류는 재시도해도 비용만 쌓인다. 일시 장애만 재시도한다.
점검표
- 모든 LLM 호출 로그에
task_id, 모델, 입력·캐시·출력 토큰, 재시도 횟수가 있다. - 성공한 작업 하나당 비용을 작업 유형별로 볼 수 있다.
- 작업 유형별 기본 모델이 표로 정해져 있다.
- Cascade를 쓰는 작업에는 기계적으로 판정되는 검사가 있다.
- Cascade 통과율을 주 단위로 확인한다.
- 모든 작업에
max_steps와 토큰 합계 한도가 있다. - 한도에 닿은 작업은 부분 결과와 상태를 돌려준다.
- 큰 도구 결과는 잘라서 넣고 원문 위치를 남긴다.
- 시스템 프롬프트와 도구 정의가 매 호출 같은 순서·같은 내용이다.
- 실시간이 아닌 대량 작업은 Batch로 보낸다.
Agent 비용은 작업 단위로 재고, 쉬운 일은 작은 모델로 보내며, 모든 루프에 예산을 걸고, 같은 앞부분은 캐시로 보낼 때 통제된다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.