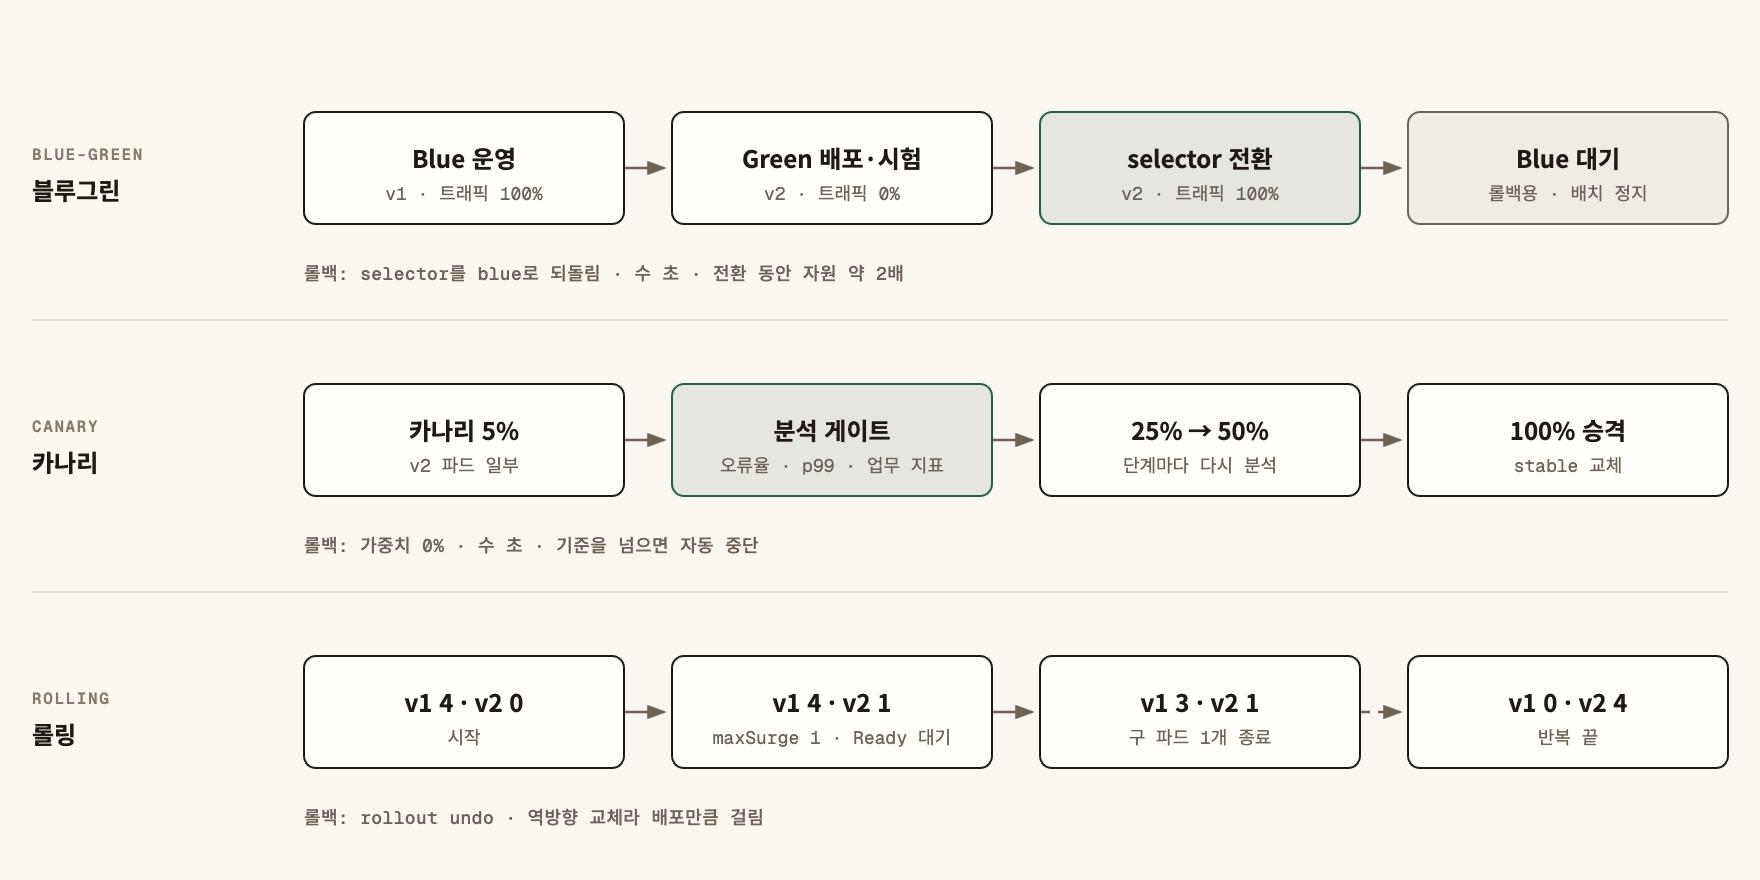
무중단 배포 방식은 세 가지가 가장 흔하다. Blue-Green은 환경을 통째로 바꾸고, Canary는 트래픽 일부로 먼저 시험하고, Rolling은 인스턴스를 하나씩 교체한다. 셋은 서버 비용, 롤백 속도, 장애가 닿는 범위가 서로 다르고, 공통으로 "구버전과 새 버전이 잠시 함께 돈다"는 조건을 요구한다. 이 글은 세 전략을 같은 기준으로 비교하고 Kubernetes 설정 예시와 고르는 기준을 정리한다.
한눈에 보기
| 기준 | Blue-Green | Canary | Rolling |
|---|---|---|---|
| 추가 자원 | 전환 동안 약 2배 | 카나리 몫만큼 소량 | maxSurge만큼 |
| 롤백 속도 | 수 초(전환 되돌림) | 수 초(가중치 0%) | 수 분(역방향 재배포) |
| 장애 영향 범위 | 전환 순간 전체 사용자 | 설정한 비율만 | 교체된 인스턴스 비율만큼, 점점 커짐 |
| 버전 공존 | 전환 전후 짧게 | 분석 기간 내내 | 배포 시간 내내 |
| 검증 방식 | 전환 전 별도 환경 테스트 | 실사용 지표 비교 | 헬스체크 위주 |
| 필요한 도구 | 로드밸런서·Service 전환 | 가중치 라우팅 + 지표 분석 | Kubernetes 기본 기능 |
Blue-Green: 환경을 통째로 바꾼다
운영 중인 Blue 옆에 같은 규모의 Green을 띄우고, 검증이 끝나면 트래픽을 한 번에 Green으로 돌린다. Blue는 지우지 않고 롤백용으로 남겨 둔다.
장점
- 롤백이 가장 빠르다. 전환 지점만 되돌리면 된다.
- 전환 전에 Green을 운영과 같은 설정으로 끝까지 시험할 수 있다.
주의할 점
- 자원이 2배 든다. 클라우드에서는 전환 시간만큼만 내면 되지만 온프레미스에서는 서버 한 벌을 상시 확보해야 한다.
- 전환 순간 모든 사용자가 새 버전을 받는다. Green 검증에서 놓친 결함은 전체 장애가 된다.
- 대기 중인 환경의 스케줄러와 메시지 소비자를 꺼야 한다. Blue와 Green이 같은 배치를 동시에 돌리면 정산·발송이 두 번 실행된다.
Kubernetes에서는 Service의 selector를 바꾸는 방식이 가장 단순하다.
apiVersion: v1
kind: Service
metadata:
  name: order-api
spec:
  selector:
    app: order-api
    track: blue        # green으로 바꾸면 전환
  ports:
    - port: 80
      targetPort: 8080
kubectl patch service order-api \
  -p '{"spec":{"selector":{"app":"order-api","track":"green"}}}'
selector를 바꿔도 이미 맺어진 keep-alive 연결은 Blue 파드에 남는다. Blue를 바로 줄이지 말고 연결이 빠질 시간을 둔다.
Canary: 일부 트래픽으로 먼저 시험한다
새 버전에 트래픽 5%만 보내고, 지표가 기준 안에 있으면 25%, 50%, 100%로 올린다. 기준을 넘으면 0%로 되돌린다. 장애가 나도 영향은 그 비율의 사용자에 그친다.
장점
- 실제 사용자 요청으로 검증한다. 테스트 환경에서 재현되지 않는 데이터·트래픽 패턴을 잡는다.
- 단계마다 자동 판정을 걸 수 있어 사람 판단을 줄인다.
주의할 점
- 지표 수집과 비교 기준이 없으면 그냥 느린 Rolling이다.
- 트래픽이 적으면 5%로는 표본이 모자란다. 분당 요청 100건이면 5%는 5건이고, 오류 1건이 20% 오류율이 된다. 비율 대신 "최소 요청 수"를 단계 통과 조건에 넣는다.
Argo Rollouts의 Rollout 리소스로 단계를 선언한 예다.
apiVersion: argoproj.io/v1alpha1
kind: Rollout
metadata:
  name: order-api
spec:
  replicas: 10
  selector:
    matchLabels:
      app: order-api
  template:
    metadata:
      labels:
        app: order-api
    spec:
      containers:
        - name: app
          image: registry.example.com/order-api:1.8.0
  strategy:
    canary:
      steps:
        - setWeight: 5
        - pause: {duration: 10m}
        - analysis:
            templates:
              - templateName: error-rate   # 오류율을 재는 AnalysisTemplate(따로 정의)
        - setWeight: 25
        - pause: {duration: 10m}
        - setWeight: 50
        - pause: {}          # 사람이 promote할 때까지 대기
trafficRouting을 설정하지 않으면 비율을 파드 수로 맞춘다. replicas 10에서 5%는 파드 1개가 되어 실제로는 약 10%가 흐른다. 정확한 비율이 필요하면 Gateway API나 서비스 메시의 가중치 라우팅을 연결한다. Gateway API만 쓴다면 HTTPRoute의 weight로 직접 나눌 수도 있다.
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: order-api
spec:
  parentRefs:
    - name: public-gateway
  rules:
    - backendRefs:
        - name: order-api-stable
          port: 80
          weight: 95
        - name: order-api-canary
          port: 80
          weight: 5
Rolling: 인스턴스를 하나씩 교체한다
Kubernetes Deployment의 기본 전략이다. 새 파드가 준비되면 구 파드를 하나 내리고, 이를 끝까지 반복한다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-api
spec:
  replicas: 4
  minReadySeconds: 10
  progressDeadlineSeconds: 600
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1          # 최대 5개까지 띄움
      maxUnavailable: 0    # 가용 파드 4개 아래로 내려가지 않음
  selector:
    matchLabels:
      app: order-api
  template:
    metadata:
      labels:
        app: order-api
    spec:
      containers:
        - name: app
          image: registry.example.com/order-api:1.8.0
          readinessProbe:
            httpGet:
              path: /actuator/health/readiness
              port: 8080
            periodSeconds: 5
두 값의 기본은 각각 25%다. maxUnavailable: 0은 용량을 지키는 대신 배포가 느리고, 여유 노드가 없으면 새 파드가 Pending에 걸려 배포가 멈춘다. 이때 progressDeadlineSeconds가 지나면 Deployment의 Progressing 조건이 ProgressDeadlineExceeded로 바뀐다. 자동으로 되돌리지는 않으므로 CI나 경보가 이 조건을 보고 멈춰야 한다.
주의할 점
- readinessProbe가 없으면 준비 안 된 파드로 트래픽이 들어간다. Rolling의 안전장치는 사실상 이 하나다.
- 롤백(
kubectl rollout undo deployment/order-api)도 같은 속도의 역방향 Rolling이다. 파드 40개를 바꾸는 데 10분 걸렸다면 되돌리는 데도 비슷하게 걸린다. - 구 파드가 내려갈 때 처리 중인 요청을 끝내는 설계는 Kubernetes Pod Lifecycle과 Graceful Shutdown 설계에서 따로 다룬다.
세 전략의 공통 조건: DB 스키마는 두 버전을 모두 받아야 한다
세 방식 모두 구버전과 새 버전이 같은 DB를 동시에 쓴다. Blue-Green도 롤백하는 순간 구버전이 새 스키마 위에서 돈다. 그래서 스키마 변경은 확장(expand)과 축소(contract)로 나눈다.
- 확장: 새 컬럼·테이블을 추가만 한다. NOT NULL이면 기본값을 둔다. 구버전은 새 컬럼을 모른 채 그대로 동작한다.
- 이행: 새 버전을 배포하고, 필요하면 옛 컬럼과 새 컬럼에 함께 쓴다. 기존 데이터는 배치로 옮긴다.
- 축소: 롤백할 일이 없다고 판단한 다음 릴리스에서 옛 컬럼을 지운다.
컬럼 이름 변경을 한 번에 하면 세 전략 모두 배포 도중 구버전이 오류를 낸다. 배포 전략으로는 이 문제를 풀 수 없다.
세션과 상태가 있는 서비스
- 메모리 세션: Blue-Green 전환이나 Rolling 교체 때 로그인 세션이 사라진다. 세션을 Redis 같은 외부 저장소로 빼거나 토큰 방식으로 바꾼다.
- 버전 왕복: Canary에서 요청마다 무작위로 나누면 한 사용자가 화면마다 다른 버전을 본다. 화면과 API 응답 형식이 바뀌었다면 사용자 ID나 쿠키 기준으로 고정한다.
- 메시지 소비자: 큐 소비자는 HTTP 가중치를 따르지 않는다. 소비자 수 비율대로 메시지를 나눠 받으므로, 새 버전 소비자를 따로 몇 개 띄울지 정해야 한다.
- 긴 연결: WebSocket과 gRPC 스트림은 전환 뒤에도 구버전에 붙어 있다. 재연결을 유도하는 종료 처리가 필요하다.
무엇을 보고 다음 단계로 넘어가나
검증 신호는 절대값이 아니라 "새 버전 대 기존 버전"으로 비교한다. 같은 시간대의 같은 트래픽을 보기 때문에 시간대별 변동이 지워진다.
| 신호 | 예시 기준 | 놓치면 생기는 일 |
|---|---|---|
| 오류율 | 5xx 비율이 기존 대비 0.5%p 이상 높으면 중단 | 일부 기능 장애가 100%까지 퍼짐 |
| 지연 | p99가 기존보다 20% 이상 느리면 중단 | 평균은 같은데 느린 요청만 늘어남 |
| 자원 | 파드당 CPU·메모리, 재시작 횟수 | 메모리 누수가 몇 시간 뒤 터짐 |
| 업무 지표 | 주문 성공률, 결제 승인율 | 오류 없이 잘못된 결과를 돌려줌 |
수치는 예시다. 서비스의 SLO에서 뽑아야 하고, 남은 Error Budget이 적을수록 단계를 더 잘게 나눈다. 이 연결은 SRE Error Budget으로 배포 속도와 안정성 관리하기에서 자세히 다룬다.
같이 쓰는 기법: Feature Flag와 Shadow
- Feature Flag: 코드는 배포하되 기능은 꺼 둔다. 배포와 출시를 나누므로 Rolling만으로도 위험을 줄일 수 있다. 다만 오래된 플래그를 지우지 않으면 분기가 쌓인다.
- Shadow(미러링): 운영 요청을 복사해 새 버전에 보내고 응답은 버린다. 사용자 영향이 없지만, 새 버전이 DB에 쓰거나 외부 API를 부르면 부작용이 두 번 일어난다. 읽기 API에만 쓰거나 쓰기를 막은 환경에서 쓴다.
어떻게 고르나
| 상황 | 추천 | 이유 |
|---|---|---|
| 내부 시스템, 트래픽 적음, 도구 최소 | Rolling + readinessProbe | 기본 기능만으로 무중단 |
| 롤백이 몇 초 안에 끝나야 하고 자원 여유 있음 | Blue-Green | 전환 지점 하나로 되돌림 |
| 사용자 많고 결함 영향 범위를 줄여야 함 | Canary + 자동 분석 | 일부 사용자로 먼저 검증 |
| 스키마나 API가 하위 호환되지 않음 | 먼저 expand/contract로 나눔 | 어떤 전략도 혼재 기간을 피할 수 없음 |
배포 선언 자체를 Git으로 관리하는 방법은 GitOps와 Argo CD 기반 선언적 배포 아키텍처, 온프레미스 공공 환경의 롤백 자동화는 공공 SI 환경의 CI/CD 배포·백업·롤백 자동화를 참고한다.
자주 하는 실수
Canary를 걸어 놓고 지표를 안 본다. 판정 없이 시간만 기다리면 결함이 그대로 100%까지 간다.
Blue-Green 대기 환경의 배치를 끄지 않는다. 두 환경이 같은 작업을 동시에 실행해 데이터가 중복된다.
컬럼 이름 변경과 배포를 한 번에 한다. 혼재 기간에 구버전이 실패하고, 롤백해도 복구되지 않는다.
readinessProbe를 livenessProbe와 같은 경로로 둔다. DB가 잠깐 느려질 때 파드가 재시작되어 장애가 커진다.
트래픽 적은 서비스에 5% Canary를 쓴다. 표본이 적어 판정이 우연에 좌우된다.
점검표
- 구버전이 새 스키마에서, 새 버전이 구 스키마에서 각각 동작하는지 확인했다
- 롤백 절차를 문서가 아니라 실제로 한 번 실행해 걸린 시간을 쟀다
- Rolling의
maxSurge·maxUnavailable과 노드 여유 용량을 함께 계산했다 - 모든 파드에 readinessProbe가 있고 liveness와 경로가 다르다
- Canary 단계마다 오류율·p99·업무 지표의 중단 기준이 정해져 있다
- 단계 통과 조건에 최소 요청 수가 들어 있다
- Blue-Green 대기 환경의 스케줄러와 메시지 소비자가 꺼져 있다
- 세션이 파드 메모리에 의존하지 않는다
- Shadow 트래픽이 쓰기 작업을 일으키지 않는다
세 전략의 차이는 "새 버전을 얼마나 많은 사용자에게, 얼마나 빨리 되돌릴 수 있게 내보내느냐"이고, 어느 쪽을 고르든 두 버전이 함께 돌아도 깨지지 않는 스키마와 판정 기준이 먼저 있어야 한다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.