롤링 배포를 할 때마다 502 응답이 몇 건씩 찍힌다면 원인은 대개 애플리케이션 코드가 아니라 종료 순서다. Kubernetes는 Pod를 지울 때 트래픽 차단과 종료 신호를 동시에 진행하므로, 둘의 순서를 맞추는 일은 설계하는 쪽의 몫이다. 이 글은 Pod 생애 주기와 프로브의 역할을 정리하고 preStop, SIGTERM, 유예 시간, Spring Boot 설정, PID 1, PodDisruptionBudget을 하나의 종료 설계로 묶는다.
한눈에 보기
| 순서 | 누가 | 무엇을 | 관련 설정 |
|---|---|---|---|
| 1 | API 서버 | 삭제 시각을 기록하고 Pod를 Terminating으로 표시 | kubectl delete, 롤링 배포 |
| 2 | EndpointSlice 컨트롤러 → kube-proxy·Ingress | 엔드포인트에서 빼고 라우팅 규칙을 고침 (수 초 걸림) | 없음 |
| 3 | kubelet | preStop 훅 실행, 끝날 때까지 SIGTERM 보류 | lifecycle.preStop |
| 4 | kubelet → 컨테이너 PID 1 | SIGTERM 전달, 앱이 새 요청을 거절하고 처리 중인 요청을 마침 | server.shutdown |
| 5 | kubelet | 유예 시간이 끝나도 살아 있으면 SIGKILL | terminationGracePeriodSeconds |
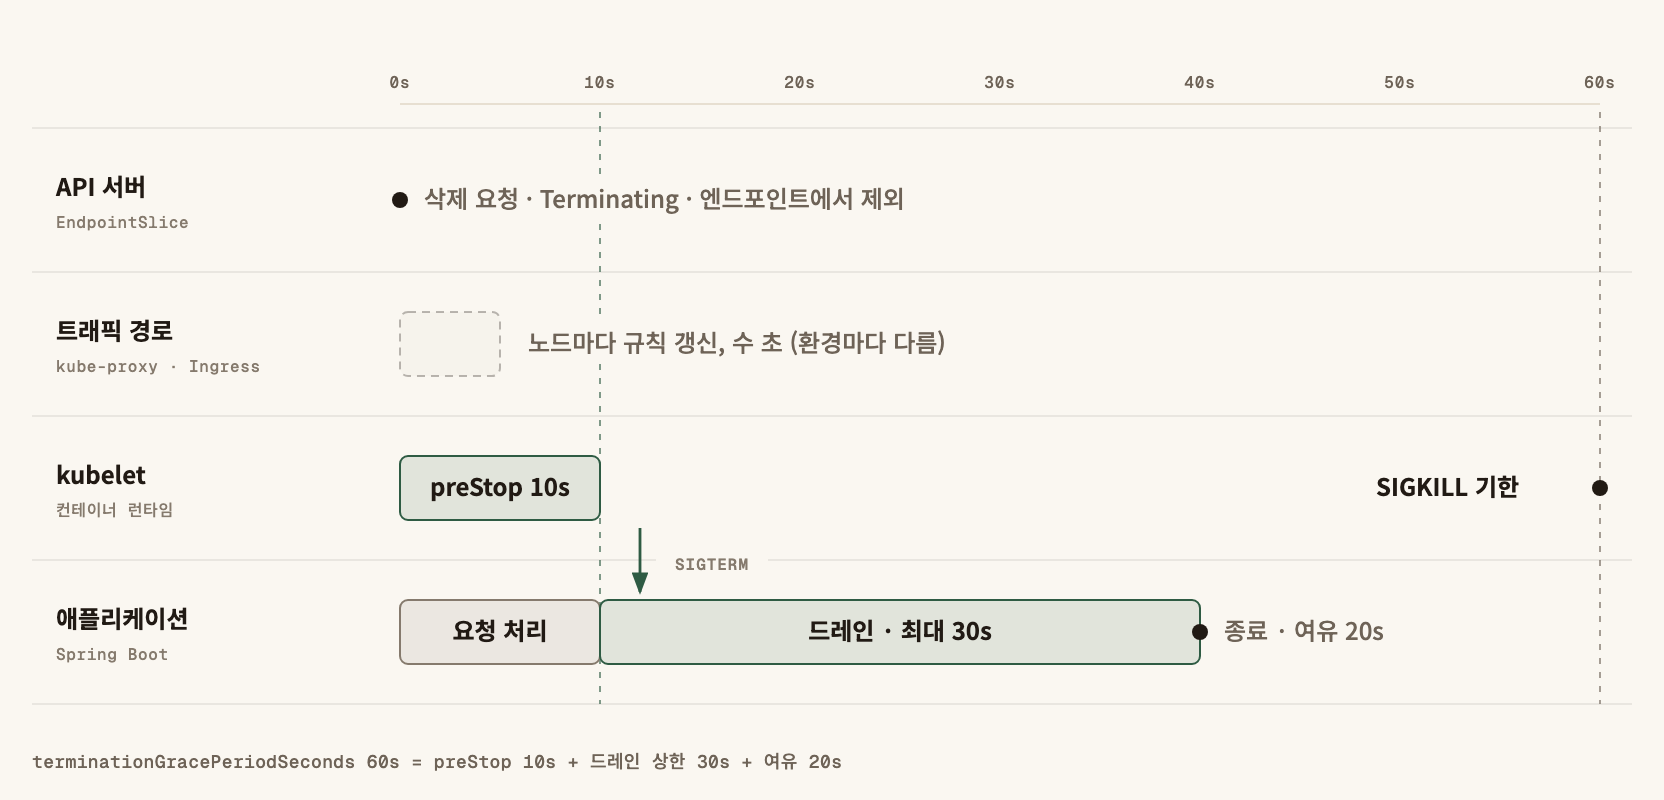
2번과 3~5번은 동시에 시작한다. 이 둘이 경쟁한다는 사실이 이 글의 출발점이다.
Pod phase와 컨테이너 상태는 다른 층이다
Pod phase는 다섯 개뿐이다: Pending, Running, Succeeded, Failed, Unknown. 컨테이너 상태는 따로 Waiting, Running, Terminated 세 가지가 있다. 흔히 보는 CrashLoopBackOff는 Waiting의 이유(reason)이고, OOMKilled는 Terminated의 이유다.
- Terminating은 phase가 아니다. kubectl이 삭제 시각(
deletionTimestamp)이 붙은 Pod를 그렇게 보여 줄 뿐이다. phase만 세는 대시보드는 종료 중인 Pod를 Running으로 센다. - Running은 요청을 받을 준비가 됐다는 뜻이 아니다. 컨테이너가 하나 이상 실행 중이라는 뜻이다. 트래픽을 받을지는
Ready조건이 정하고, 그 조건은 readiness 프로브가 만든다.
세 가지 프로브는 실패했을 때 하는 일이 다르다
| 프로브 | 실패하면 | 확인할 것 | 넣지 말 것 |
|---|---|---|---|
| startup | 성공 전까지 나머지 프로브를 멈춤, 한도를 넘으면 재시작 | 기동이 끝났는가 | 긴 기동을 liveness 지연으로 버티기 |
| readiness | Service 엔드포인트에서 빠짐 (재시작 없음) | 지금 요청을 받을 수 있는가 | 무거운 쿼리 |
| liveness | kubelet이 컨테이너를 재시작 | 스스로 회복 못 하는 상태인가 | DB·외부 API 확인 |
liveness에 DB 연결 확인을 넣으면 DB가 잠깐 흔들릴 때 모든 Pod가 함께 재시작한다. 장애 하나가 전체 중단으로 커진다. 외부 의존성은 readiness에서도 신중하게 다룬다. 모든 Pod가 동시에 빠지면 Service에 남는 엔드포인트가 없다.
종료 순서와 경쟁 조건
삭제 요청이 들어오면 두 갈래가 함께 움직인다.
- 트래픽 갈래: EndpointSlice 컨트롤러가 Pod를 엔드포인트에서 뺀다. 각 노드의 kube-proxy가 iptables·IPVS 규칙을 고치고, Ingress 컨트롤러와 클라우드 로드밸런서도 각자 대상 목록을 갱신한다. 끝나는 시점은 노드와 컴포넌트마다 다르다.
- 종료 갈래: kubelet이 preStop을 실행하고, 끝나면 SIGTERM을 보낸다. 유예 시간은 삭제 시점부터 흐르고 preStop 시간도 여기에 포함된다.
preStop이 없으면 SIGTERM이 거의 즉시 간다. 앱이 리스너를 닫았는데 아직 규칙을 못 고친 노드가 요청을 보내면 연결 거부나 502가 난다. readiness 프로브를 실패시키는 것만으로는 막지 못한다. Terminating Pod는 이미 엔드포인트에서 빠지는 중이고, 문제는 그 전파가 늦다는 데 있다.
preStop sleep으로 순서를 맞춘다
SIGTERM을 늦춰 라우팅 갱신이 끝날 시간을 번다. 그동안 앱은 들어오는 요청을 평소처럼 처리한다.
lifecycle:
  preStop:
    sleep:
      seconds: 10
sleep 동작은 Kubernetes 1.29에 알파로 들어와 1.30부터 기본으로 켜졌다. 그 이전 버전이면 exec로 ["sleep", "10"]을 쓴다. 이때는 이미지에 sleep 실행 파일이 있어야 하는데 distroless 이미지에는 없다. 클러스터 버전과 이미지를 먼저 확인한다.
길이는 Ingress와 로드밸런서의 해제 지연보다 길게 잡는다. 5~15초에서 시작해 배포 중 5xx 비율을 보고 조정한다. 클라우드 로드밸런서는 대상 해제 지연을 따로 설정하므로 그 값도 맞춘다.
Spring Boot graceful shutdown
server:
  shutdown: graceful
spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
management:
  endpoint:
    health:
      probes:
        enabled: true
- SIGTERM을 받으면 내장 웹 서버(Tomcat, Jetty, Reactor Netty 등)가 새 요청을 거절하고 처리 중인 요청을 기다린다. 30초가 지나면 남은 요청을 끊고 다음 종료 단계로 간다.
- Spring Boot 3.4부터
server.shutdown기본값이graceful이다. 그 이전 버전은 직접 켜야 한다. timeout-per-shutdown-phase는 이름대로 종료 단계마다 적용된다. 웹 서버 드레인 뒤에도 커넥션 풀 정리, 메시지 리스너 정지 같은 작업이 이어진다.- 프로브용 엔드포인트는
/actuator/health/liveness,/actuator/health/readiness다.
시간 예산: 유예 시간은 preStop과 드레인의 합보다 길게
| 구간 | 시간 |
|---|---|
| preStop sleep | 10초 |
| Spring 드레인 상한 | 30초 |
| 종료 훅·풀 정리 여유 | 20초 |
terminationGracePeriodSeconds |
60초 |
기본 유예 시간 30초를 그대로 두면 preStop 10초 뒤 드레인 20초째에 SIGKILL이 온다. 오래 걸리는 요청이 그대로 끊긴다. 종합하면 Deployment는 이렇게 된다.
spec:
  template:
    spec:
      terminationGracePeriodSeconds: 60
      containers:
        - name: api
          image: registry.example.com/api:1.4.2
          ports:
            - containerPort: 8080
          startupProbe:
            httpGet: { path: /actuator/health/liveness, port: 8080 }
            periodSeconds: 5
            failureThreshold: 30
          readinessProbe:
            httpGet: { path: /actuator/health/readiness, port: 8080 }
            periodSeconds: 5
            failureThreshold: 3
          livenessProbe:
            httpGet: { path: /actuator/health/liveness, port: 8080 }
            periodSeconds: 10
            failureThreshold: 3
          lifecycle:
            preStop:
              sleep:
                seconds: 10
startup 프로브는 5초 간격으로 30번, 최대 150초까지 기동을 기다린다. 그동안 liveness가 기동 중인 앱을 죽이지 않는다.
PID 1과 신호 전달
SIGTERM은 컨테이너의 PID 1에게만 간다. 셸 형식으로 쓰면 PID 1이 /bin/sh가 되고, 셸은 신호를 자식에게 넘기지 않는다. 앱은 SIGTERM을 받지 못한 채 유예 시간을 다 쓰고 SIGKILL로 끝난다.
# 나쁨: sh -c 가 PID 1
CMD java -jar /app/app.jar

# 좋음: java 가 PID 1
ENTRYPOINT ["java", "-jar", "/app/app.jar"]
- 시작 스크립트가 꼭 필요하면 마지막 줄을
exec java ...로 써서 셸을 java로 바꾼다. - 자식 프로세스를 여러 개 띄우는 이미지는 tini 같은 작은 init을 PID 1로 둔다. 신호를 넘기고 좀비 프로세스를 거둔다.
- 종료 코드로 확인한다. SIGTERM을 받아 끝난 JVM은 143(128+15), SIGKILL로 끝나면 137(128+9)이다. 배포 때마다 137이 보이면 신호가 안 갔거나 유예 시간이 모자란 것이다. 137은 OOMKilled에서도 나오니 reason을 같이 본다.
오래 걸리는 작업: 컨슈머와 배치
- 메시지 컨슈머: SIGTERM을 받으면 새로 가져오기를 멈추고, 처리 중인 메시지를 끝낸 뒤 오프셋을 커밋한다. 커밋 전에 끊기면 같은 메시지가 다시 온다. 그래서 컨슈머는 멱등하게 만든다(분산 환경에서 멱등 API와 중복 요청 방지 설계 참고).
- 배치: 체크포인트 단위로 끊어 재시작해도 이어서 돌게 한다. 몇 시간짜리 작업을 유예 시간으로 버티려 하지 말고 Job으로 분리한다.
- WebSocket·SSE: 긴 연결은 드레인이 끝나지 않는다. 종료 때 서버가 연결을 닫고 클라이언트가 재연결하게 만든다.
PodDisruptionBudget: 동시에 몇 개까지 빠질지
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: api-pdb
spec:
  maxUnavailable: 1
  selector:
    matchLabels:
      app: api
PDB는 Eviction API를 거치는 자발적 중단에만 적용된다. kubectl drain, 클러스터 오토스케일러의 노드 축소가 여기에 든다. kubectl delete pod, 노드 장애, Deployment 롤링 배포에는 적용되지 않는다. 롤링 배포의 동시 교체 수는 maxUnavailable·maxSurge가 정한다. replica가 1인데 minAvailable: 1을 걸면 drain이 영원히 끝나지 않는다.
정리 표
| 설정 | 기본값 | 없으면 생기는 일 |
|---|---|---|
| preStop sleep | 없음 | 라우팅 갱신 전에 리스너가 닫혀 502 |
server.shutdown: graceful |
3.4 이전은 immediate | 처리 중인 요청이 즉시 끊김 |
terminationGracePeriodSeconds |
30초 | 드레인 도중 SIGKILL |
| exec 형식 ENTRYPOINT | 없음 | SIGTERM 미전달, 매번 137 |
| startup 프로브 | 없음 | 느린 기동 중 liveness가 재시작 반복 |
| PDB | 없음 | 노드 drain 때 replica가 한꺼번에 빠짐 |
자주 하는 실수
- 유예 시간을 기본 30초로 둔 채 preStop을 넣는다. preStop이 유예 시간을 먹어서 드레인할 시간이 줄어든다.
- liveness에 DB 확인을 넣는다. 외부 장애가 전체 재시작으로 번진다.
- readiness 실패로 종료 경쟁을 해결했다고 믿는다. 엔드포인트 전파 지연은 그대로 남는다.
- 셸 형식 CMD를 쓴다. 앱은 SIGTERM을 못 받고 유예 시간 끝에 강제 종료된다.
- replica 1에
minAvailable: 1PDB를 건다. 노드 점검이 멈춘다.
점검표
-
terminationGracePeriodSeconds가 preStop + 드레인 상한 + 여유보다 길다. - preStop sleep 길이가 Ingress·로드밸런서 해제 지연보다 길다.
- 클러스터 버전이
sleep동작을 지원하는지, 아니면 이미지에sleep이 있는지 확인했다. - Spring Boot
server.shutdown이graceful이다(버전별 기본값 확인). - ENTRYPOINT가 exec 형식이고, 컨테이너 안 PID 1이 앱 프로세스다.
- liveness 프로브가 외부 의존성을 확인하지 않는다.
- 기동이 느린 앱에 startup 프로브가 있다.
- 롤링 배포 중 5xx와 종료 코드 137 건수를 대시보드에서 본다.
- 컨슈머는 종료 때 오프셋을 커밋하고 중복 메시지를 견딘다.
- replica 수와 PDB 값이 drain을 막지 않는다.
Graceful Shutdown은 설정 한 줄이 아니라, 트래픽이 먼저 빠지고 그다음 앱이 요청을 마치고 마지막에 유예 시간이 닫히도록 세 시계를 한 줄로 세우는 일이다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.