CUBRID를 쓰는 공공 시스템에서 "특정 시간만 되면 화면이 멈춘다"는 장애의 상당수는 오래 열려 있는 트랜잭션이 잡은 배타 락(X_LOCK) 때문이다. 쿼리는 빠른데 락을 기다리느라 요청이 쌓이고, 결국 커넥션 풀까지 바닥난다. 이 글은 흔한 패턴으로 재구성한 장애 사례를 따라 X_LOCK 대기를 찾고, 장기 트랜잭션을 줄이는 방법을 정리한 것이다. 특정 사업의 기록이 아니며 수치는 예시다.
락 기초: X_LOCK은 커밋할 때까지 간다
CUBRID는 행 단위로 락을 건다. 행을 수정하거나 지우면 그 행에 배타 락(X_LOCK)이 걸리고, 트랜잭션이 커밋하거나 롤백할 때까지 풀리지 않는다. 같은 행을 수정하려는 다른 트랜잭션은 그동안 기다린다.
| 락 | 주로 언제 | 다른 트랜잭션에 주는 영향 |
|---|---|---|
| X_LOCK(배타) | INSERT·UPDATE·DELETE한 행 | 같은 행을 수정하려는 쪽은 대기 |
| IX_LOCK(의도 배타) | 행에 X_LOCK을 걸 때 테이블에 표시 | 테이블 전체 락을 원하는 쪽과 충돌 |
| SCH_M_LOCK(스키마 변경) | ALTER 등 DDL | 그 테이블을 쓰는 모든 작업과 충돌 |
CUBRID 10 이상은 MVCC를 쓰므로 일반 조회는 수정 중인 행 때문에 막히지 않는다. 문제는 수정끼리의 대기, 그리고 락이 행에서 테이블로 커지는 경우다.
재구성 사례: 오전 9시의 멈춤
| 항목 | 상황 |
|---|---|
| 증상 | 매일 08:50~09:20에 신청 저장 화면이 30초 넘게 걸리다 타임아웃 |
| 지표 | 쿼리 실행 시간은 짧은데 WAS 스레드 대부분이 DB 응답 대기, 커넥션 풀 포화 |
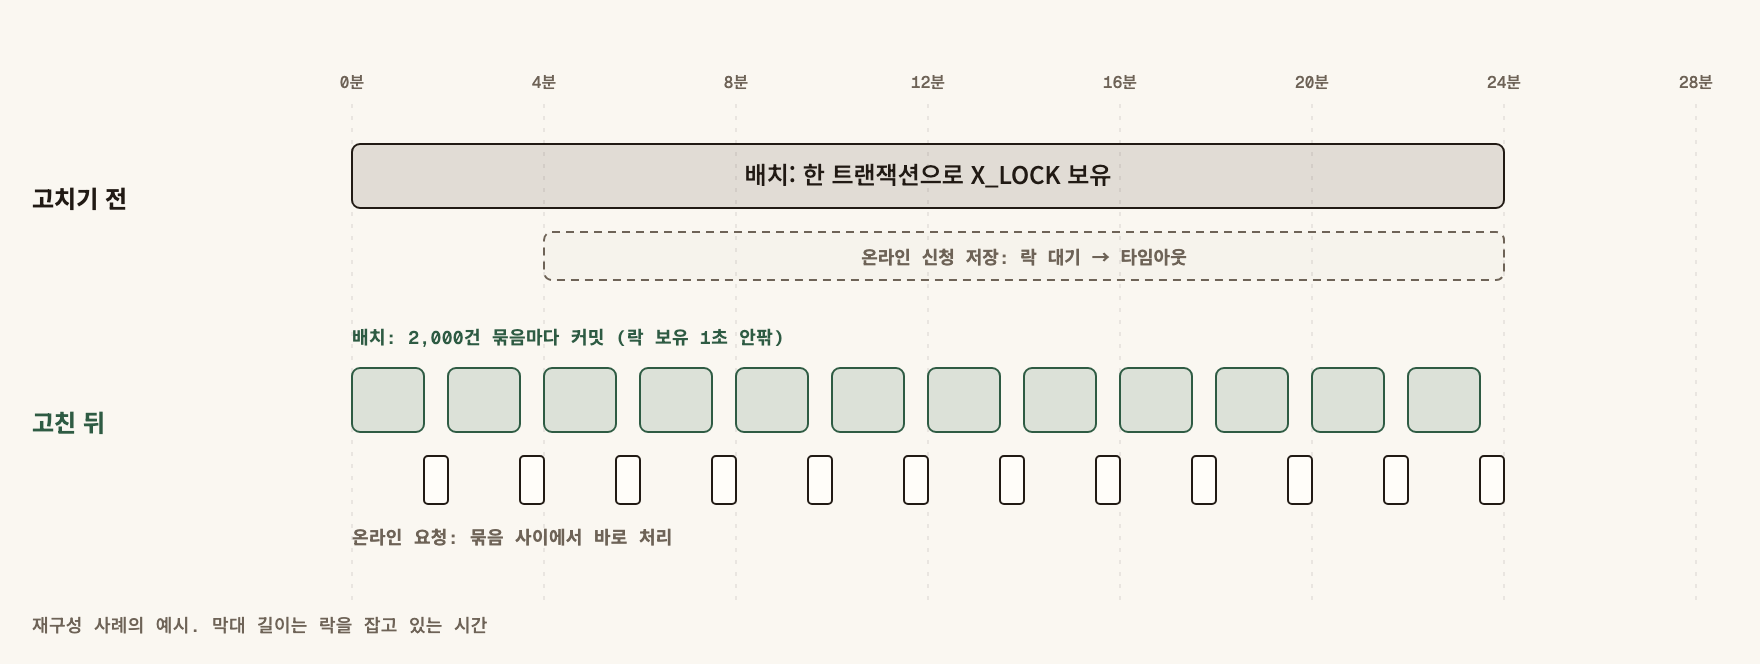
| 원인 1 | 08:30에 시작하는 정산 배치가 대상 행 수십만 건을 하나의 트랜잭션으로 UPDATE |
| 원인 2 | 온라인 신청 저장이 트랜잭션 안에서 외부 연계를 호출하며 X_LOCK을 몇 초씩 보유 |
배치가 커밋하지 않는 동안 그 행들에 걸린 X_LOCK이 그대로 남았다. 온라인 업무가 같은 신청 건의 상태를 바꾸려다 줄줄이 대기했고, 대기하는 요청들이 커넥션을 붙잡아 상관없는 화면까지 느려졌다.
1단계: 지금 누가 락을 잡고 있는지 본다
장애 시간에는 추측하지 말고 락 정보를 덤프한다.
# 트랜잭션 목록: 오래 실행 중인 트랜잭션과 클라이언트, 실행 중 SQL 확인
cubrid tranlist <db_name>

# 락 테이블: 어떤 객체(행·테이블)에 누가 어떤 락을 잡고, 누가 기다리는지
cubrid lockdb -o lock_$(date +%H%M).txt <db_name>
명령 옵션과 출력 형식은 버전마다 조금씩 다르니 사용하는 버전의 매뉴얼로 확인한다. lockdb 출력에서 같은 객체에 대해 보유자(holder) 와 대기자(waiter) 가 함께 나오는 항목을 찾는다. 보유자의 트랜잭션 번호를 tranlist와 맞춰 보면 어느 프로그램의 어떤 SQL인지 나온다. 이번 사례에서는 보유자가 배치 계정의 트랜잭션 하나였고, 수십 개의 온라인 트랜잭션이 대기자로 줄을 서 있었다.
급한 경우 cubrid killtran -i <트랜잭션 번호> <db_name>으로 보유 트랜잭션을 끊을 수 있다. 끊긴 트랜잭션은 롤백되므로 배치라면 재실행 계획이 있을 때만 쓴다. 근본 해결은 아래 단계다.
2단계: 배치는 짧게 나눠 커밋한다
한 번에 수십만 건을 수정하는 트랜잭션은 락 보유 시간이 길 뿐 아니라, 한 트랜잭션이 한 테이블에 잡은 행 락 수가 임계값(lock_escalation)을 넘으면 락이 테이블 단위로 커질 수 있다. 그러면 그 테이블을 수정하는 모든 작업이 멈춘다.
<!-- MyBatis: 대상 키를 미리 읽고, 키 범위 단위로 나눠 처리 -->
<update id="settleChunk">
  UPDATE apply SET status = 'SETTLED', settled_at = SYSDATETIME
  WHERE apply_id BETWEEN #{fromId} AND #{toId} AND status = 'APPROVED'
</update>
for (Range r : planner.chunks(targetIds, 2_000)) {   // 2,000건 단위
    settleService.settleChunk(r);                     // 메서드마다 별도 트랜잭션, 끝나면 커밋
}
- 묶음 크기는 락 보유 시간이 1초 안팎이 되도록 정한다.
- 중간에 실패해도 다시 시작할 수 있게 처리 위치를 기록한다.
- 배치 시간을 온라인 피크와 겹치지 않게 옮긴다.
3단계: 온라인 트랜잭션에서 기다림을 뺀다
- 외부 연계는 커밋 뒤로. 트랜잭션 안에서 다른 기관 응답을 기다리는 동안 X_LOCK이 유지된다. DB 저장만 하고 커밋한 뒤 연계한다.
- 잠그는 범위를 좁힌다.
SELECT ... FOR UPDATE는 정말 갱신할 행만 키 조건으로 잠근다. 조건 컬럼에 인덱스가 없으면 스캔이 길어져 락 보유 시간도 길어진다. - 잠그는 순서를 통일한다. 두 트랜잭션이 행 A, B를 서로 반대 순서로 잠그면 교착 상태가 된다. 여러 행을 수정할 때는 키 오름차순처럼 같은 순서로 처리한다.
- 사용자 입력을 기다리며 트랜잭션을 열어 두지 않는다. 화면 단위 트랜잭션이나 긴 대화형 편집은 낙관적 잠금(버전 컬럼)으로 바꾼다.
4단계: 무한 대기를 막는다
락 대기에 상한이 없으면 대기 요청이 커넥션을 끝없이 붙잡는다.
- DB 설정의
lock_timeout값을 확인한다. 무한 대기(-1)로 되어 있다면 업무 특성에 맞는 초 단위 값으로 정하고, 대기 초과 오류를 애플리케이션이 받아 사용자에게 "잠시 뒤 다시 시도" 안내를 하게 한다. - 애플리케이션 쪽에도 쿼리 타임아웃(JDBC, MyBatis
timeout)과 트랜잭션 타임아웃을 둔다. - 타임아웃 값은 커넥션 풀 대기 시간, 웹 서버 타임아웃과 함께 맞춘다. 안쪽이 바깥보다 먼저 끊어져야 원인이 로그에 남는다.
5단계: 다시 생기지 않게 감시한다
- 일정 시간(예: 30초) 넘게 열린 트랜잭션을 주기적으로 찾아 알린다(
tranlist결과 수집 또는 APM). - APM에서 DB 대기 시간과 락 대기 건수를 대시보드에 올린다.
- 새 배치는 "한 트랜잭션에서 수정하는 최대 행 수"를 코드 리뷰 항목으로 둔다.
- MVCC에서 오래 열린 트랜잭션은 옛 버전 데이터 정리도 늦춘다. 조회 전용이라도 트랜잭션을 길게 열어 두지 않는다.
자주 하는 실수
- 쿼리 튜닝만 한다. 쿼리는 빠른데 락을 기다리는 문제는 실행 계획에 나타나지 않는다.
- 배치를 한 트랜잭션으로 돌린다. 락 보유 시간이 길어지고 락이 테이블 단위로 커질 위험이 있다.
- 트랜잭션 안에서 외부 연계를 기다린다. 연계 지연이 곧 락 보유 시간이 된다.
- 락 대기에 상한이 없다. 대기 요청이 커넥션 풀을 다 잡는다.
- 장애 시간에 락 정보를 남기지 않는다. 지나고 나면 원인을 재현하기 어렵다.
점검표
- 장애 시
tranlist·lockdb를 떠 두는 절차가 있다 - 배치는 묶음 단위로 커밋하고 재시작 위치를 기록한다
- 배치 시간이 온라인 피크와 겹치지 않는다
- 온라인 트랜잭션 안에 외부 연계 호출이 없다
-
FOR UPDATE는 인덱스 키 조건으로 필요한 행만 잠근다 - 여러 행을 잠글 때 순서가 통일되어 있다
- DB
lock_timeout과 애플리케이션 타임아웃이 정해져 있다 - 오래 열린 트랜잭션과 락 대기를 감시·알림한다
X_LOCK 병목은 락 자체가 아니라 락을 오래 쥐고 있는 트랜잭션의 문제다. 배치는 잘게 커밋하고, 온라인 트랜잭션에서는 기다림을 빼고, 대기에는 상한을 두면 "그 시간만 되면 멈추는" 장애는 사라진다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.