HikariCP 커넥션 풀이 고갈되면 DB는 한가한데 애플리케이션 요청이 30초씩 멈췄다가 한꺼번에 실패한다. 풀 크기를 늘리는 것이 첫 반응이지만, 원인이 커넥션을 오래 잡는 코드라면 늘린 만큼 DB 부하만 커진다. 이 글은 고갈이 어떻게 보이는지, 무엇이 고갈을 만드는지, 지표로 원인을 가리는 방법, 그리고 풀 크기를 숫자로 정하는 순서를 정리한 것이다.
한눈에 보기
| 단계 | 보는 것 | 판단 |
|---|---|---|
| 증상 | Connection is not available 예외, 요청 대기 |
풀이 비었는지 확인 |
| 지표 | active·pending·usage·acquire | 오래 잡나, 돌려주지 않나, 수요가 큰가 |
| 원인 | 긴 트랜잭션, 외부 호출, 누수, 중첩 획득 | 코드부터 고친다 |
| 용량 | 리틀의 법칙, DB 코어 수, 교착 하한 | 세 숫자 사이에서 풀 크기를 정한다 |
| 설정 | timeout, lifetime, keepalive, 누수 감지 | 실패를 빨리, 끊김 없이 |
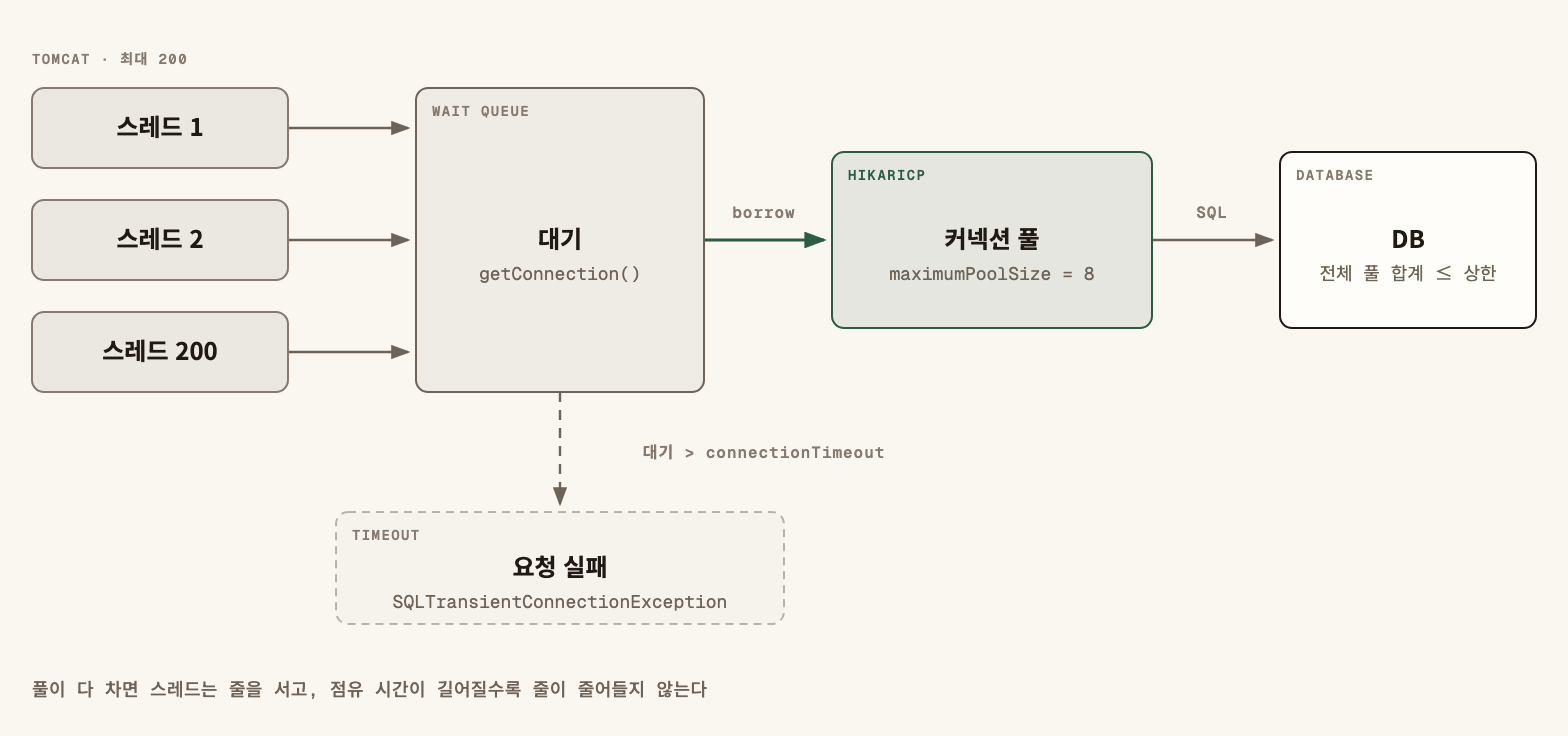
풀은 병목을 일부러 만드는 장치다. 스레드 200개가 DB에 동시에 들어가지 못하게 앞에서 줄을 세운다. 문제는 줄이 생기는 것이 아니라 줄이 줄어들지 않는 것이다.
고갈은 이렇게 보인다
애플리케이션 로그에 이런 예외가 쌓인다. Spring에서는 CannotGetJdbcConnectionException이나 CannotCreateTransactionException에 싸여 올라오기도 한다.
java.sql.SQLTransientConnectionException: HikariPool-1 - Connection is not available, request timed out after 30000ms.
- 응답 시간이 connectionTimeout 근처로 몰린다. 기본값 30초를 바꾸지 않았다면 실패한 요청의 응답 시간이 30초 언저리에 모인다.
- DB는 한가하다. DB CPU와 세션 수는 평소와 비슷한데 애플리케이션만 느리다. 일이 DB에서 막힌 것이 아니라 풀 앞에서 막혔다는 뜻이다.
- 스레드 덤프에 같은 자리가 반복된다. 요청 스레드 다수가
HikariPool.getConnection에서 기다린다. - 풀 상태 로그.
com.zaxxer.hikari로거를 DEBUG로 두면total,active,idle,waiting수가 주기적으로 찍힌다.active가 최대치이고waiting이 0보다 크면 고갈이다.
커넥션을 오래 잡는 원인
풀 크기가 같아도 커넥션 하나를 잡는 시간이 길어지면 고갈된다. 가장 흔한 원인이다.
트랜잭션 안의 외부 호출. @Transactional 메서드 안에서 외부 API나 파일 업로드를 부르면 그동안 커넥션을 쥐고 있다. 외부 API가 3초 걸리면 커넥션도 3초 묶인다. 트랜잭션 경계 설계는 별도 글에서 다뤘으니 여기서는 "DB 작업만 트랜잭션 안에 둔다"는 원칙만 짚는다.
긴 트랜잭션. 화면 하나를 그리려고 조회 수십 번을 한 트랜잭션에 묶거나, 배치가 수만 건을 한 번에 커밋하면 커넥션을 오래 쥔다. OSIV(spring.jpa.open-in-view)가 켜져 있으면 뷰 렌더링이 끝날 때까지 커넥션을 반납하지 않는다.
느린 쿼리와 락 대기. 인덱스를 타지 않는 쿼리, 다른 트랜잭션의 락을 기다리는 쿼리도 그 시간만큼 커넥션을 잡는다. 이때 DB 세션 목록에는 같은 쿼리나 락 대기가 여러 개 보인다.
돌려주지 않거나 두 개를 잡는 원인
커넥션 누수. DataSource.getConnection()으로 직접 꺼낸 뒤 예외 경로에서 close()를 하지 않으면 커넥션이 풀로 돌아오지 않는다. 트래픽과 상관없이 active가 계단처럼 올라가고 내려오지 않는다. try-with-resources로 닫고, leakDetectionThreshold를 켜면 정해진 시간 넘게 반납하지 않은 커넥션을 꺼낸 위치의 스택이 Connection leak detection triggered 경고로 찍힌다.
요청 하나가 커넥션 두 개를 잡는다. 바깥 트랜잭션이 커넥션을 쥔 채로 REQUIRES_NEW 메서드를 부르거나, 다른 DataSource 경로로 커넥션을 하나 더 꺼내면 스레드 하나가 커넥션 두 개를 원한다. 풀 크기 8에서 스레드 8개가 하나씩 쥐고 두 번째를 기다리면, 아무도 반납하지 않으니 모두 connectionTimeout까지 멈춘다. 부하가 높을 때만 나타나서 테스트에서 놓치기 쉽다.
스레드 수가 풀보다 훨씬 많다. Tomcat 기본 최대 스레드는 200이고 풀 기본값은 10이다. 이 차이 자체는 정상이다. 다만 점유 시간이 늘어나는 순간 190개 스레드가 줄을 서고, 그 줄이 웹 서버 스레드까지 모두 묶어 정적 파일 요청이나 헬스 체크까지 느려진다.
지표로 먼저 확인한다
Spring Boot에 Actuator와 Micrometer가 있으면 HikariCP 지표가 자동으로 등록된다. Prometheus 이름 기준으로 다음을 본다.
| 지표 | 뜻 | 고갈 때 모양 |
|---|---|---|
hikaricp_connections_active |
사용 중인 커넥션 | 최대치에 붙어 있음 |
hikaricp_connections_pending |
커넥션을 기다리는 스레드 | 0보다 큼 |
hikaricp_connections_timeout_total |
획득 시간 초과 횟수 | 증가 |
hikaricp_connections_acquire_seconds |
커넥션을 받기까지 걸린 시간 | 길어짐 |
hikaricp_connections_usage_seconds |
커넥션을 잡고 있던 시간 | 원인 구분의 열쇠 |
원인은 usage로 가린다. usage가 평소보다 길면 커넥션을 오래 잡는 쪽이다. usage는 그대로인데 active가 내려오지 않으면 누수다. usage도 정상이고 누수도 없는데 pending이 있으면 수요가 풀보다 크다.
# 평균 점유 시간(초)
rate(hikaricp_connections_usage_seconds_sum[5m]) / rate(hikaricp_connections_usage_seconds_count[5m])
# 평균적으로 바쁜 커넥션 수 = 초당 점유 시간의 합 (리틀의 법칙)
rate(hikaricp_connections_usage_seconds_sum[5m])
# 기다리는 스레드
max by (pool) (hikaricp_connections_pending)
두 번째 식이 다음 절의 용량 산정에 쓰는 실측값이다.
용량 산정: 세 숫자로 범위를 좁힌다
풀 크기는 "필요한 만큼"과 "DB가 감당할 만큼" 사이에서, "교착이 나지 않는 만큼" 위에서 정한다. 아래 숫자는 모두 예시다.
1. 필요량: 리틀의 법칙. 동시에 바쁜 커넥션 수는 처리량 × 평균 점유 시간이다.
- 예시: 피크 800 TPS를 인스턴스 4대가 나눠 받으면 대당 200 TPS. 평균 점유 시간이 30ms면 200 × 0.03 = 평균 6개가 바쁘다.
- 순간 몰림을 받으려고 30% 여유를 두면 7.8, 올려서 8개.
- 같은 서비스에서 트랜잭션 안에 외부 호출이 들어가 점유 시간이 300ms가 되면 200 × 0.3 = 60개가 필요하다. 풀을 60으로 늘리면 4대 합계 240개가 DB로 간다. 이 경우 답은 풀이 아니라 코드다.
2. 상한: DB가 동시에 처리할 수 있는 양. HikariCP 위키는 출발점으로 connections = (core_count × 2) + effective_spindle_count를 제시한다. core_count는 하이퍼스레딩을 뺀 물리 코어 수이고, 자주 쓰는 데이터가 메모리에 다 올라와 있으면 effective_spindle_count는 0에 가깝다. 이 값은 앱 한 대가 아니라 DB 전체에 들어가는 활성 커넥션 수의 출발점이다.
- 예시: DB 물리 코어 16개, 데이터가 캐시에 다 올라와 있으면 16 × 2 + 0 = 32.
- 앱 풀 합계 8 × 4대 = 32. 출발점과 맞는다. 이후 부하 테스트로 조정한다.
3. 하한: 교착이 나지 않는 크기. 스레드 하나가 커넥션을 여러 개 잡는 구조라면 풀은 Tn × (Cm − 1) + 1 이상이어야 한다. Tn은 동시에 커넥션을 쓰는 최대 스레드 수, Cm은 스레드 하나가 동시에 잡는 최대 커넥션 수다.
- 예시:
REQUIRES_NEW로 커넥션 2개를 잡는 요청이 동시에 8개면 8 × (2 − 1) + 1 = 9 이상. 풀 8로는 교착이 날 수 있다. - Tomcat 스레드 200개가 모두 그 경로를 탈 수 있으면 201이 필요하다. 이 숫자가 나오면 풀을 키우지 말고 중첩 획득을 없앤다.
마지막으로 DB의 최대 접속 수 설정이 모든 풀의 합을 덮는지 본다. 배포 중 인스턴스가 한 대 더 뜨는 순간과 배치·관리 도구 접속까지 더한다. 예시: 8 × 5대 + 배치 10 + 관리 5 = 55 이상.
설정 값과 예시
| 설정 | 기본값 | 정하는 기준 |
|---|---|---|
maximumPoolSize |
10 | 위의 세 숫자 |
minimumIdle |
maximumPoolSize와 같음 | 같은 값으로 두어 고정 크기 풀로 쓰는 것이 권장 |
connectionTimeout |
30000ms | 클라이언트 타임아웃보다 짧게, 실패를 빨리 |
maxLifetime |
1800000ms(30분) | DB·인프라가 끊는 시간보다 몇 초 이상 짧게 |
keepaliveTime |
버전마다 다름 | 방화벽 유휴 끊김 시간보다 짧게, maxLifetime보다 짧게 |
idleTimeout |
600000ms(10분) | minimumIdle이 최대보다 작을 때만 동작 |
leakDetectionThreshold |
0(꺼짐) | 정상 최장 점유 시간보다 길게 |
spring:
  datasource:
    hikari:
      pool-name: main-pool
      maximum-pool-size: 8
      minimum-idle: 8
      connection-timeout: 3000          # 3초 안에 못 받으면 실패 (예시)
      max-lifetime: 1740000             # 29분: DB 쪽 30분 제한(예시)보다 짧게
      keepalive-time: 300000            # 5분마다 유휴 커넥션 확인
      leak-detection-threshold: 10000   # 10초 넘게 반납하지 않으면 스택 경고
connectionTimeout을 30초로 두면 고갈 때 요청이 30초씩 쌓여 웹 스레드까지 묶인다. 사용자가 기다릴 수 있는 시간 안에서 실패시키고, 실패율 경보로 알아채는 편이 회복이 빠르다. maxLifetime이 DB나 방화벽의 끊는 시간보다 길면 이미 끊긴 커넥션을 빌려 줘 첫 쿼리가 실패한다.
| 설정·지표 | 무엇을 막나 | 없으면 생기는 일 |
|---|---|---|
| usage 지표 | 원인 오판 | 누수인데 풀만 키움 |
| leakDetectionThreshold | 반납 안 한 코드 방치 | 며칠에 한 번 고갈, 재기동으로만 회복 |
| 짧은 connectionTimeout | 대기 줄의 연쇄 | 웹 스레드 전부가 30초씩 묶임 |
| maxLifetime·keepaliveTime | 끊긴 커넥션 대여 | 아침 첫 요청마다 통신 오류 |
| 교착 하한 계산 | 중첩 획득 교착 | 피크 때만 전체 정지 |
자주 하는 실수
- 고갈되면 풀부터 키운다. 점유 시간이 원인이면 늘린 커넥션도 금방 차고, DB에 동시 쿼리만 늘어 모두 느려진다.
- 인스턴스 수를 곱하지 않는다. 풀 50은 한 대 기준으로 무난해 보여도 10대면 DB에 500개가 붙는다.
- connectionTimeout 기본값 30초를 그대로 둔다. 고갈이 장애로 번지는 시간을 벌어 줄 뿐이다.
- 누수 감지를 운영에서 끈다. 스택 하나 찍는 비용은 작고, 없으면 누수 위치를 찾을 길이 없다.
- REQUIRES_NEW를 편의로 쓴다. 요청마다 커넥션 두 개를 잡게 되고, 풀 크기 계산이 교착 하한에 묶인다.
점검표
- active, pending, timeout, usage, acquire 지표가 대시보드에 있다
- pending이 0보다 크거나 timeout이 늘면 경보가 온다
- 평균 점유 시간을 실측했고 트랜잭션 안에 외부 호출이 없다
- 풀 크기를 리틀의 법칙(처리량 × 점유 시간)으로 계산한 근거가 있다
- 모든 인스턴스 풀의 합이 DB 코어 기준 출발점과 크게 어긋나지 않는다
- DB 최대 접속 수가 배포 중 인스턴스와 배치·관리 접속까지 덮는다
- 스레드 하나가 커넥션 두 개를 잡는 경로가 없거나 교착 하한 이상으로 풀을 잡았다
- connectionTimeout이 클라이언트 타임아웃보다 짧다
- maxLifetime과 keepaliveTime이 DB·방화벽 끊김 시간보다 짧다
- leakDetectionThreshold가 켜져 있고 경고 로그를 수집한다
커넥션 풀 고갈은 대부분 크기가 아니라 점유 시간의 문제이므로, usage 지표로 원인을 먼저 가리고 리틀의 법칙과 DB 상한 사이에서 풀 크기를 숫자로 정한다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.