Virtual Thread는 스레드를 거의 공짜로 만들어 블로킹 코드 그대로 높은 동시성을 얻게 해 준다. 하지만 켜기만 하면 빨라지는 기능이 아니다. carrier 스레드를 붙잡는 pinning과, 스레드 수 제한이 사라져 DB 커넥션·외부 API가 먼저 무너지는 자원 고갈이 대표적인 함정이다. 이 글은 두 함정이 생기는 원리, 찾는 방법, 도입 전에 바꿀 설정과 코드를 정리한 것이다.
한눈에 보기
| 항목 | 플랫폼 스레드(기존) | Virtual Thread | 도입할 때 볼 것 |
|---|---|---|---|
| 생성 비용 | OS 스레드 1개, 스택 수백 KB~수 MB | JVM 객체, 스택은 힙에 필요한 만큼 | 풀링하지 않는다 |
| 동시 요청 상한 | 스레드 풀 크기(예: Tomcat 200) | 사실상 없음 | 하류 자원 한도를 따로 건다 |
| 블로킹 I/O 중 | OS 스레드가 그대로 대기 | carrier에서 내려가고(unmount) carrier는 다른 일 | pinning이면 내려가지 못한다 |
| 이득이 큰 작업 | CPU 계산 위주 | I/O 대기 위주(DB, HTTP 호출) | CPU 바운드에는 이득 없음 |
| 장애 분석 | jstack |
JSON 스레드 덤프, JFR | 도구를 미리 바꿔 둔다 |
Virtual Thread는 무엇을 바꾸나
Virtual Thread는 Java 21에서 정식 기능이 됐다(JEP 444). JVM은 Virtual Thread를 소수의 carrier 스레드 위에 올려 실행한다. carrier는 ForkJoinPool 기반 스케줄러가 관리하고, 기본 개수는 CPU 코어 수다.
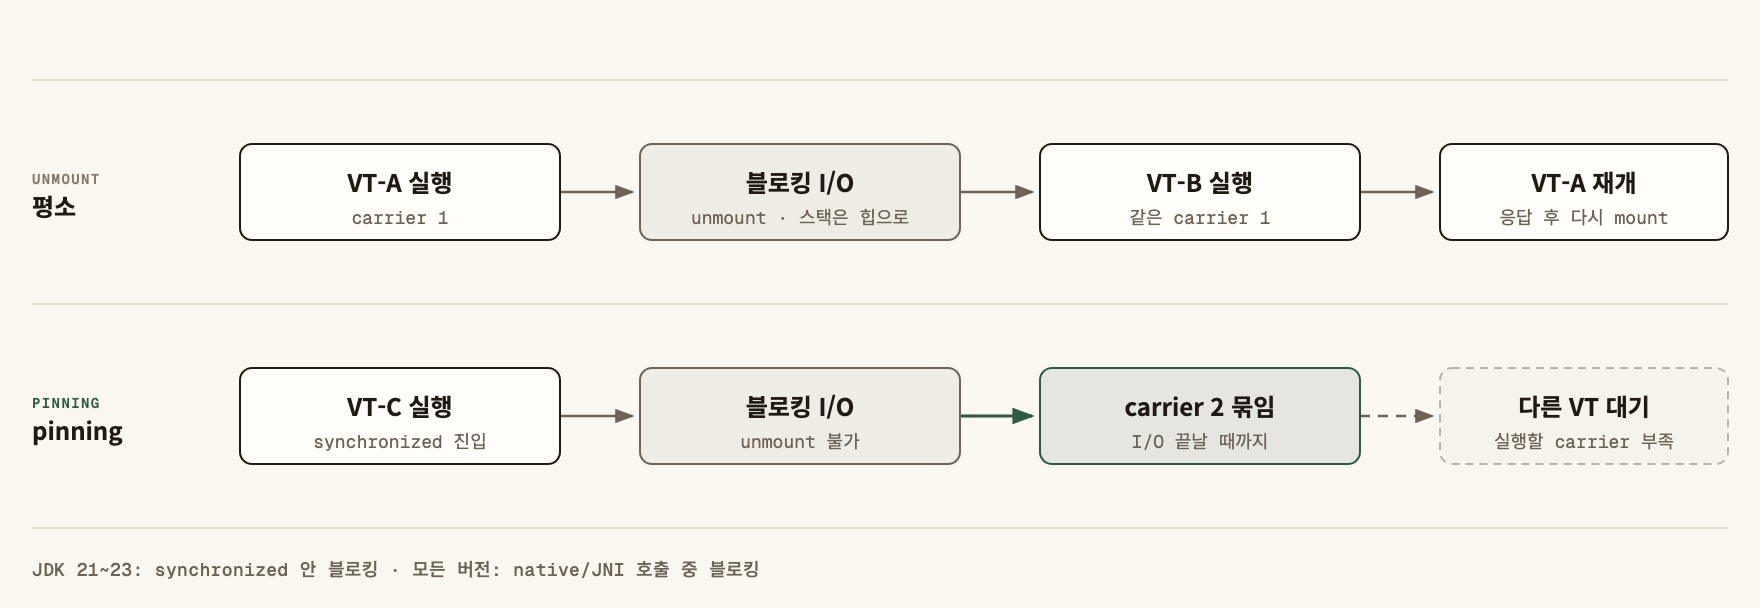
핵심은 블로킹 순간의 동작이다. Virtual Thread가 소켓 읽기나 Thread.sleep()에서 멈추면 JVM은 그 스택을 힙에 저장하고 carrier에서 내린다. 비어 있는 carrier는 다른 Virtual Thread를 실행한다. 응답이 오면 Virtual Thread는 아무 carrier에나 다시 올라가 이어서 실행된다.
그래서 바뀌는 것은 처리량이지 한 요청의 응답 시간이 아니다. DB 쿼리가 50ms 걸리면 Virtual Thread에서도 50ms 걸린다. 늘어나는 것은 같은 시간에 동시에 기다릴 수 있는 요청 수다. 스레드가 커널에서 어떻게 스케줄되는지는 Linux Process와 Thread의 Kernel 관점 분석에서 다뤘다.
Pinning: carrier를 붙잡는 두 가지 경우
Virtual Thread가 블로킹되는데도 carrier에서 내려가지 못하는 상태를 pinning이라고 한다. 대표 원인은 두 가지다.
synchronized안에서 블로킹. JDK 21~23에서는synchronized블록·메서드 안에서 I/O를 기다리면 모니터를 쥔 채 carrier에 고정된다. JDK 24에서 JEP 491로 이 제약이 풀렸다. JDK 21 LTS를 쓰는 동안에는 여전히 조심해야 한다.- native 메서드나 foreign function 호출 중. JNI 호출 안에서 블로킹되면 JVM이 스택을 옮길 수 없다. 이 경우는 JDK 버전과 상관없이 남는다.
pinning 한 번이 바로 장애는 아니다. 문제는 동시에 여러 개가 걸릴 때다. carrier가 8개인 서버에서 pinning된 Virtual Thread 8개가 각각 느린 I/O를 기다리면, 나머지 수천 개 Virtual Thread는 실행할 carrier가 없어 멈춘다. CPU 사용률은 낮은데 응답이 전부 멈추는 모양이 된다.
JDK 21에서 가장 흔한 수정은 블로킹 구간의 synchronized를 ReentrantLock으로 바꾸는 것이다.
// 변경 전: JDK 21~23에서 HTTP 호출 동안 carrier가 묶인다
public synchronized Token refresh() {
    return authClient.requestToken();   // 블로킹 I/O
}

// 변경 후: 대기 중에도 Virtual Thread가 carrier에서 내려간다
private final ReentrantLock lock = new ReentrantLock();

public Token refresh() {
    lock.lock();
    try {
        return authClient.requestToken();
    } finally {
        lock.unlock();
    }
}
직접 고칠 수 없는 라이브러리(오래된 JDBC 드라이버, 커넥션 풀 내부)에 synchronized가 있으면 라이브러리 버전을 올리거나 JDK 24 이상으로 가는 쪽이 현실적이다.
Pinning 찾기: JFR과 새 스레드 덤프
추측으로 고치지 말고 측정부터 한다.
- JFR 이벤트
jdk.VirtualThreadPinned. pinning된 채 일정 시간 이상 블로킹되면 기록되고, 스택 트레이스가 같이 남는다. 운영에서 상시로 켜 두기에 가장 부담이 적다. -Djdk.tracePinnedThreads=full. JDK 21~23에서 pinning 지점의 스택을 표준 출력으로 찍는다. JDK 24에서 제거됐으니 버전별 릴리스 노트를 확인하고 JFR을 기본으로 삼는다.- JSON 스레드 덤프.
jstack은 Virtual Thread를 보여 주지 않는다.jcmd <pid> Thread.dump_to_file -format=json <파일>로 받은 덤프에는 Virtual Thread까지 들어 있다.
# 운영 JVM에 JFR 기록을 붙이고 pinning 이벤트만 뽑아 본다
jcmd <pid> JFR.start name=vt duration=10m filename=/tmp/vt.jfr
jfr print --events jdk.VirtualThreadPinned /tmp/vt.jfr
덤프를 읽는 순서와 BLOCKED 스레드 묶어 보기는 JVM Thread Dump와 Heap Dump로 장애 원인 분석하기의 방법을 그대로 쓰면 된다.
자원 고갈: 스레드가 싸지면 다른 것이 비싸진다
기존 구조에서는 Tomcat 스레드 풀 200개가 동시 요청 수를 막아 주는 문 역할을 했다. Virtual Thread를 켜면 요청마다 스레드가 하나씩 생기고 이 문이 사라진다. 그러면 병목이 그다음 자원으로 내려간다.
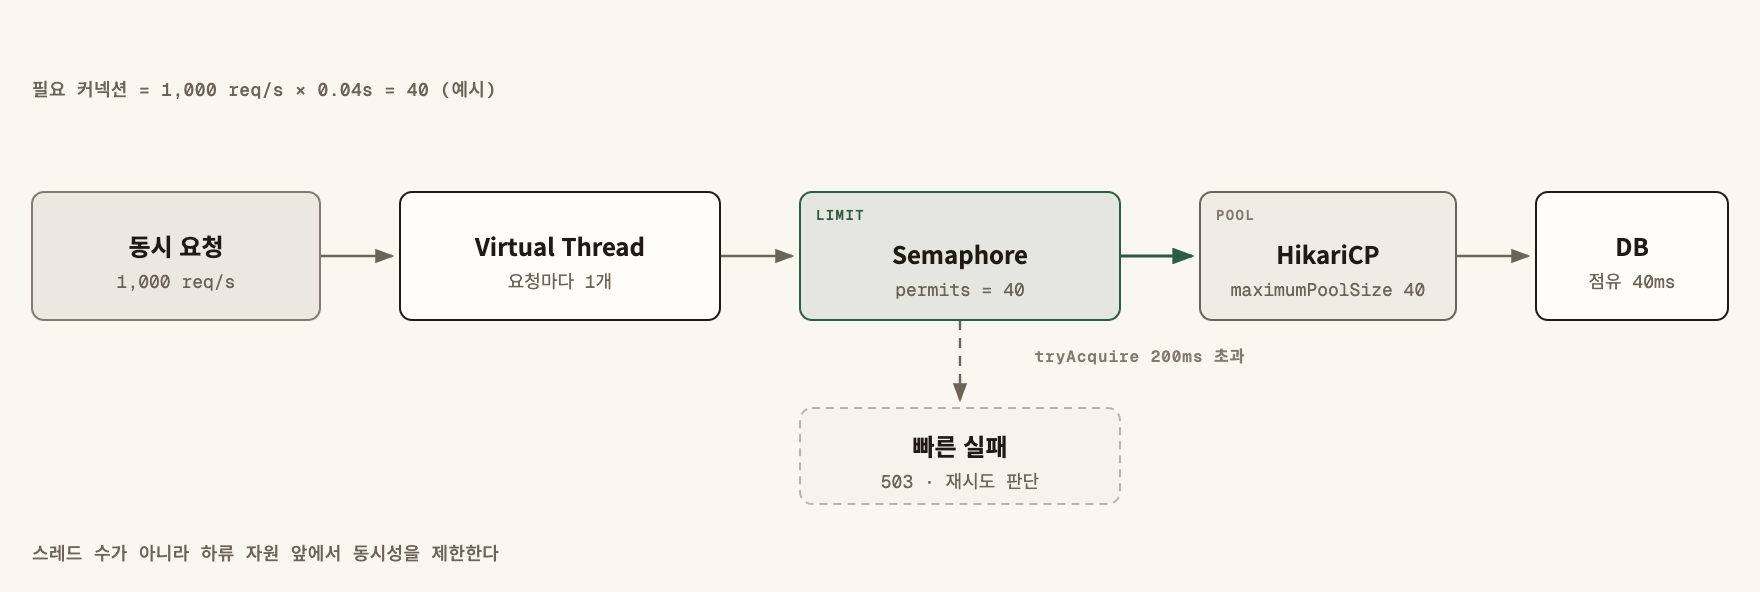
예시로 계산해 보자. 초당 1,000건이 들어오고 요청마다 DB 커넥션을 40ms 쥔다면, 리틀의 법칙으로 평균 40개 커넥션이 동시에 필요하다(1,000 × 0.04). 커넥션 풀이 20개면 처리 한계는 초당 500건(20 ÷ 0.04)이다. 기존에는 넘치는 요청이 Tomcat 앞에서 기다렸지만, 이제는 수백 개 Virtual Thread가 getConnection()에서 기다린다. 대기가 connectionTimeout(HikariCP 기본 30초)을 넘으면 요청이 한꺼번에 실패한다. 커넥션 풀 크기를 정하는 기준은 HikariCP Connection Pool 고갈 원인과 용량 산정에 정리했다.
같은 일이 외부 API에도 생긴다. 스레드 상한이 없어지면 상대 서버의 호출 한도를 순식간에 넘긴다. 상대 쪽 한도를 어떻게 지키는지는 Rate Limiting 알고리즘 비교와 분산 환경 구현에서 다룬다.
메모리도 본다. Virtual Thread 스택은 힙에 저장되므로 동시 요청이 늘면 힙 사용량과 GC 부담이 같이 는다. GC 선택은 JVM G1 GC와 ZGC의 동작 원리 및 선택 기준을 참고한다.
동시성 제한: Semaphore로 문을 다시 만든다
Virtual Thread를 풀에 넣어 수를 제한하지 않는다. 풀링은 생성 비용이 비쌀 때 쓰는 방법이고, Virtual Thread는 작업마다 새로 만드는 것이 전제다. 수를 제한해야 하는 대상은 스레드가 아니라 자원이다.
// 자원마다 한도를 둔다. 허가 수는 커넥션 풀 크기 이하로 맞춘다
private final Semaphore dbPermits = new Semaphore(40);

public Order load(long id) throws InterruptedException {
    if (!dbPermits.tryAcquire(200, TimeUnit.MILLISECONDS)) {
        throw new ServiceBusyException("DB 동시 요청 한도 초과");   // 503으로 응답
    }
    try {
        return orderRepository.findById(id);
    } finally {
        dbPermits.release();
    }
}
tryAcquire에 짧은 대기 시간을 두면 30초 동안 매달리는 대신 0.2초 안에 실패를 돌려준다. 실패를 빨리 돌려주면 호출자가 재시도나 대체 응답을 고를 시간이 생긴다. 메시지 소비자도 같은 원리다. 리스너 동시성을 무제한으로 두면 처리 지연이 다른 형태로 터지는데, 이는 Kafka Consumer Group Rebalancing과 Consumer Lag 대응과 이어진다.
Spring Boot에서 켤 때 바꿀 설정
Spring Boot 3.2 이상, Java 21 이상에서 spring.threads.virtual.enabled=true 한 줄로 켠다. 그러면 Tomcat 요청 처리와 @Async·@Scheduled의 기본 실행기가 Virtual Thread를 쓴다. 메시지 리스너 등 적용 범위는 Boot 버전 문서에서 확인한다.
| 설정·코드 | 왜 바꾸나 | 안 바꾸면 생기는 일 |
|---|---|---|
spring.threads.virtual.enabled=true |
Virtual Thread 사용 | 기존 스레드 풀 그대로 |
spring.main.keep-alive=true |
Virtual Thread는 데몬 스레드라 JVM을 붙잡지 않는다 | 스케줄러만 도는 앱이 시작 직후 종료될 수 있다 |
@Async 실행기 동시성 한도 |
기본 실행기는 작업마다 스레드를 만든다 | 대량 비동기 작업이 하류 자원을 한꺼번에 친다 |
자원별 Semaphore |
Tomcat 스레드 상한이 사라졌다 | 커넥션 풀 대기와 대량 타임아웃 |
ThreadLocal 캐시 정리 |
스레드가 수만 개가 된다 | 스레드마다 큰 객체를 들고 있어 힙이 커진다 |
| JFR 상시 기록 | pinning과 대기를 증거로 본다 | 멈춤의 원인을 추측으로 고친다 |
ThreadLocal에 포매터나 버퍼를 캐시하던 코드는 스레드 하나당 객체 하나라는 전제가 깨진다. 요청 범위 값 전달에는 ScopedValue가 대안으로 나와 있지만, JDK 버전별 정식 여부를 확인하고 쓴다.
자주 하는 실수
- Virtual Thread를 풀에 넣는다.
Executors.newFixedThreadPool처럼 수를 묶으면 장점이 사라진다. 작업마다Executors.newVirtualThreadPerTaskExecutor()로 새로 만든다. - CPU 계산 작업에 기대한다. carrier 수는 코어 수 그대로라 계산량이 많은 작업은 빨라지지 않는다.
- 커넥션 풀 크기를 같이 키운다. 풀을 200으로 올리면 병목이 DB 자체로 옮겨 간다. 앞에서 동시성을 제한하는 쪽이 맞다.
- JDK 21에서
synchronized블로킹을 그대로 둔다. 부하가 몰릴 때만 전체 멈춤으로 나타나 테스트에서 놓친다. jstack으로만 장애를 본다. Virtual Thread가 덤프에 나오지 않아 "스레드는 멀쩡하다"는 잘못된 결론을 내린다.
점검표
- 운영 JDK 버전을 확인했고, JDK 21~23이면
synchronized안 블로킹 지점을 찾았다. - JFR
jdk.VirtualThreadPinned이벤트를 부하 테스트 중에 수집했다. - 장애 대응 문서의 스레드 덤프 명령을 JSON 덤프로 바꿨다.
- DB 커넥션 풀 크기를 리틀의 법칙(도착률 × 점유 시간)으로 다시 계산했다.
- DB·외부 API마다
Semaphore같은 동시성 한도와 짧은 대기 시간을 뒀다. - 한도 초과 시 응답 코드(503 등)와 호출자 재시도 규칙을 정했다.
- Virtual Thread를 풀링하는 코드가 없다.
-
ThreadLocal에 큰 객체를 캐시하는 코드를 정리했다. - 스케줄러 전용 앱에
spring.main.keep-alive=true를 넣었다. - 도입 전후 처리량, p99 응답 시간, 힙 사용량을 같은 부하로 비교했다.
Virtual Thread는 스레드 비용을 없애 주는 대신 동시성 제한을 개발자에게 돌려주므로, pinning을 측정으로 찾아 없애고 DB와 외부 API 앞에 자원별 한도를 다시 세운 뒤 켜야 한다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.