Java 서비스가 멈추거나 느려졌을 때 가장 흔한 대응은 재시작이고, 재시작하는 순간 원인의 증거도 함께 사라진다. Thread Dump는 그 순간 모든 스레드가 무엇을 기다리는지, Heap Dump는 메모리를 무엇이 붙잡고 있는지를 보여 주는 유일한 기록이다. 이 글은 증상별로 어떤 덤프를 언제 어떻게 뜨는지, 덤프에서 원인을 찾는 읽는 법, 장애 전에 미리 해 둘 설정을 정리한 것이다.
증상별로 한눈에
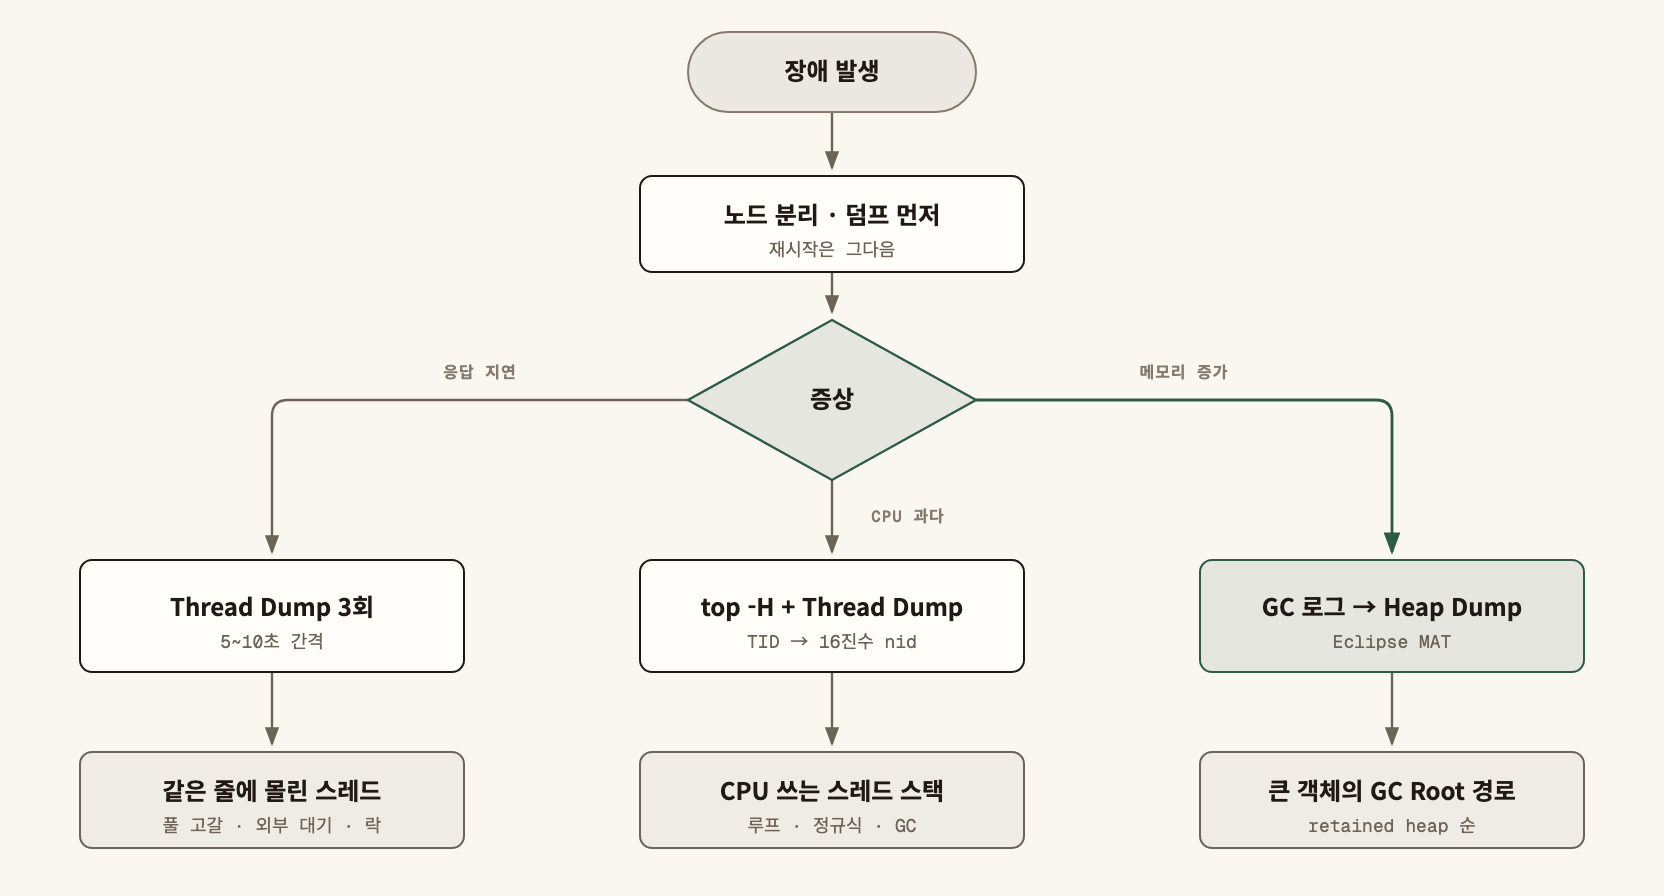
| 증상 | 먼저 뜰 것 | 볼 곳 | 흔한 원인 |
|---|---|---|---|
| 응답이 멈추거나 매우 느림, CPU는 낮음 | Thread Dump 3회 | 같은 곳에서 기다리는 스레드 무리 | 커넥션 풀 고갈, 외부 호출 타임아웃 없음, 락 경합, 데드락 |
| CPU가 계속 높음 | top -H + Thread Dump |
CPU를 쓰는 스레드의 스택 | 무한 루프, 정규식 폭주, 잦은 GC |
| 메모리가 계속 늘다 OOM | GC 로그 → Heap Dump | 큰 객체를 붙잡은 참조 경로 | 무제한 캐시, ThreadLocal 미정리, 대량 조회 |
덤프 뜨기 전에 정할 것
재시작보다 덤프가 먼저다. 운영 담당과 "장애 시 덤프를 뜨고 재시작한다"를 절차로 합의해 두지 않으면 급한 순간에 재시작부터 한다.
- 이중화 환경이면 문제 노드를 로드밸런서에서 먼저 뺀다. 사용자 영향을 줄이고 덤프를 뜰 시간을 번다.
- 덤프는 JVM을 띄운 사용자와 같은 계정으로 뜬다. 다른 계정으로
jcmd를 실행하면 프로세스에 붙지 못한다. - Heap Dump 파일은 사용 중인 힙 크기만큼 커진다. 힙 8GB면 디스크도 그만큼 비어 있어야 한다.
- Heap Dump를 뜨는 동안 JVM은 멈춘다(Stop-The-World). 힙이 클수록 오래 걸린다. Thread Dump는 보통 짧게 끝난다.
명령
jcmd <pid> Thread.print -l > td-$(date +%H%M%S).txt      # 스레드 덤프(락 정보 포함)
jstack -l <pid> > td.txt                                  # 같은 내용, 예전 도구
kill -3 <pid>                                             # 표준 출력(catalina.out 등)으로 출력
jcmd <pid> GC.heap_dump /dumps/app-$(date +%H%M).hprof   # 힙 덤프(기본은 살아 있는 객체만, Full GC 발생)
Thread Dump 읽는 법
스레드 하나는 이렇게 생겼다(일부 줄은 생략했다).
"http-nio-8080-exec-37" #85 daemon prio=5 ... nid=0x5e3f waiting on condition
   java.lang.Thread.State: TIMED_WAITING (parking)
	at jdk.internal.misc.Unsafe.park(Native Method)
	...
	at com.zaxxer.hikari.util.ConcurrentBag.borrow(ConcurrentBag.java)
	at com.zaxxer.hikari.pool.HikariPool.getConnection(HikariPool.java)
	...
	at com.example.apply.ApplyService.submit(ApplyService.java:88)
- 이름:
http-nio-8080-exec-*는 Tomcat 요청 처리 스레드다. 이름으로 어느 풀의 스레드인지 안다. - 상태:
RUNNABLE(실행 중 또는 I/O 대기),BLOCKED(synchronized 락 대기),WAITING/TIMED_WAITING(조건·시간 대기). - 스택: 위에서 아래로 읽으면 "지금 무엇을 하는가", 아래에서 위로 읽으면 "어디서 불렀는가"다. 원인은 보통 맨 위의 JDK 코드가 아니라 그 아래 처음 나오는 우리 패키지(
com.example...) 줄에 있다. - 락:
- locked <0x...>는 이 스레드가 쥔 락,- waiting to lock <0x...>는 기다리는 락이다. 같은 주소를 찾아가면 누가 쥐고 있는지 보인다.
상태만으로 판단하지 않는다. RUNNABLE이어도 소켓 읽기에서 멈춰 있을 수 있고, WAITING이어도 할 일이 없어 쉬는 정상 스레드일 수 있다.
세 번 뜨고 비교한다
덤프 한 장은 사진 한 장이다. 그 순간 우연히 거기 있던 스레드와 계속 거기 머무는 스레드를 구분하려면 5~10초 간격으로 세 번 뜬다.
for i in 1 2 3; do jcmd <pid> Thread.print -l > td-$i.txt; sleep 10; done
# 요청 스레드 스택에 나온 우리 코드 줄을 세어, 많이 겹치는 줄을 본다
grep -A30 '"http-nio' td-3.txt | grep 'at com.example' | sort | uniq -c | sort -rn | head
세 장 모두에서 같은 스택에 머무는 스레드가 원인 후보다. 스레드 수십 개가 같은 줄에 몰려 있으면 거의 확실하다. fastThread 같은 분석 도구나 IDE의 덤프 뷰어를 쓰면 같은 스택끼리 묶어 보여 준다.
패턴 1: 응답 없음, CPU 낮음
커넥션 풀 고갈
요청 스레드 대부분이 위 예시처럼 HikariPool.getConnection에서 기다린다. 풀의 커넥션이 다 나가 있다는 뜻이다. 다음으로 커넥션을 쥔 스레드가 무엇을 하는지 본다.
- 커넥션을 쥔 스레드가 느린 쿼리 실행 중이면 쿼리와 인덱스 문제다. DB 쪽에서 실행 중 쿼리와 락 대기를 함께 확인한다.
- 커넥션을 쥔 스레드가 없는데 풀이 비어 있으면 커넥션 누수다. 반환하지 않는 코드가 있다. HikariCP의
leakDetectionThreshold를 켜면 오래 반환되지 않은 커넥션을 빌린 스택을 로그로 남긴다. - 트랜잭션 안에서 외부 API를 호출해 커넥션을 쥔 채 기다리는 경우가 흔하다.
외부 호출 대기
요청 스레드가 소켓 읽기(SocketInputStream.read, NioSocketImpl.read 등)에서 RUNNABLE로 멈춰 있다. 상대 시스템이 응답하지 않는데 읽기 타임아웃이 없다. HTTP 클라이언트마다 연결·읽기 타임아웃을 명시한다.
데드락
jstack과 jcmd Thread.print는 Java 수준 데드락을 찾으면 덤프 끝에 따로 적는다.
Found one Java-level deadlock:
=============================
"pool-1-thread-2":
  waiting to lock monitor 0x... (object 0x..., a com.example.Account),
  which is held by "pool-1-thread-1"
"pool-1-thread-1":
  waiting to lock monitor 0x... (object 0x..., a com.example.Ledger),
  which is held by "pool-1-thread-2"
두 스레드가 서로의 락을 기다린다. 락을 잡는 순서를 전 코드에서 하나로 정하면 없어진다.
패턴 2: CPU가 계속 높음
어떤 스레드가 CPU를 쓰는지 운영체제에서 먼저 찾고, 그 스레드를 덤프에서 찾는다.
top -H -p <pid>              # 스레드별 CPU. 높은 스레드의 PID(예: 24127)를 적는다
printf '%x\n' 24127          # 16진수로 바꾸면 5e3f
grep -A20 'nid=0x5e3f' td-3.txt
- 우리 코드의 반복문에 계속 있으면 무한 루프나 종료 조건 오류다.
java.util.regex안에 있으면 입력에 따라 폭주하는 정규식(되추적 폭발)을 의심한다.- CPU를 쓰는 스레드가
GC Thread#0,G1 Conc#0같은 GC 스레드라면 문제는 CPU가 아니라 메모리다. 힙이 거의 차서 GC가 쉬지 않는 상태이므로 다음 절로 간다.
패턴 3: 메모리가 계속 늘다 OOM
GC 로그부터 본다
GC 직후에도 남는 힙(사용량의 바닥선)이 시간이 갈수록 올라가면 누수다. 바닥선은 일정한데 순간 사용량만 튀면 한 번에 큰 데이터를 올리는 요청이 있는 것이다.
OOM 메시지로 영역을 가린다
| 메시지 | 부족한 곳 | 볼 것 |
|---|---|---|
Java heap space |
힙 | Heap Dump |
GC overhead limit exceeded |
힙(GC에 시간을 거의 다 씀) | Heap Dump |
Metaspace |
클래스 메타데이터 | 재배포 때 클래스로더 누수, 동적 클래스 생성 |
unable to create native thread |
운영체제 스레드 한도 | Thread Dump의 스레드 수, ulimit -u |
Direct buffer memory |
힙 밖 다이렉트 버퍼 | NIO·네트워크 라이브러리 버퍼 설정 |
Heap Dump 분석: Eclipse MAT
.hprof 파일은 Eclipse Memory Analyzer(MAT)로 연다. 덤프가 크면 MAT의 최대 힙(MemoryAnalyzer.ini의 -Xmx)도 키워야 한다.
- Leak Suspects 보고서: 열자마자 메모리를 많이 붙잡은 객체 후보를 보여 준다. 출발점으로 쓴다.
- Dominator Tree: 객체마다 retained heap(그 객체가 사라지면 함께 풀리는 메모리)을 보여 준다. shallow heap(객체 자체 크기)이 아니라 retained heap 순으로 정렬한다.
- Path to GC Roots: 의심 객체를 누가 붙잡고 있는지 따라 올라간다. 약한 참조는 빼고(
exclude weak/soft references) 본다. 끝에static필드나 스레드가 나오면 그것이 원인이다.
자주 나오는 원인은 정해져 있다.
static Map에 크기 제한 없이 넣는 직접 만든 캐시- 스레드 풀 스레드의
ThreadLocal을 요청 끝에remove()하지 않음 - 조회 결과 수십만 건을 한 번에
List로 올리는 엑셀 다운로드·배치 - 세션에 큰 객체를 넣어 사용자 수만큼 쌓임
장애 전에 해 둘 설정
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/dumps/                     # 힙 크기 이상 비어 있는 디스크
-XX:+ExitOnOutOfMemoryError                  # OOM 뒤 반쯤 살아 있는 상태로 두지 않고 종료
-Xlog:gc*:file=/logs/gc.log:time,uptime:filecount=10,filesize=20M   # JDK 9 이상 형식
ExitOnOutOfMemoryError는 이중화와 자동 재기동이 있을 때 쓴다. 덤프는 종료 전에 먼저 써진다.- 덤프 경로의 용량과 보관 기간을 정한다. 덤프가 쌓여 디스크가 차면 그것이 다음 장애가 된다.
- 덤프는 민감 정보다. Heap Dump에는 메모리에 있던 주민등록번호, 비밀번호, 세션 값이 문자열로 그대로 들어 있다. 외부 반출, 메일 첨부, 공개 분석 사이트 업로드를 금지하고 분석이 끝나면 지운다.
덤프와 도구를 왜 미리 준비하는가
| 준비 | 주로 쓰는 사람 | 없으면 생기는 일 |
|---|---|---|
| "덤프 후 재시작" 운영 절차 | 운영 | 재시작으로 증거가 사라지고 같은 장애 반복 |
| 덤프용 계정·명령 문서 | 운영, 개발 | 급한 순간에 jcmd 권한 오류로 시간 낭비 |
| HeapDumpOnOutOfMemoryError | 개발 | 새벽 OOM의 원인을 다음 장애까지 기다림 |
| GC 로그 | 개발 | 누수인지 순간 폭증인지 구분하지 못함 |
| 덤프 디스크 용량 | 인프라 | 덤프가 중간에 잘려 열리지 않음 |
| 덤프 반출 통제 | 보안 | 개인정보가 분석 과정에서 유출 |
자주 하는 실수
- 덤프 없이 재시작한다. 서비스는 돌아오지만 원인은 영영 모른다.
- Thread Dump를 한 장만 본다. 우연히 그 자리에 있던 스레드를 원인으로 착각한다.
- 스레드 상태만 센다.
WAITING이 많다는 사실보다 그 스레드들이 같은 줄에 몰려 있는지가 중요하다. - shallow heap 순으로 본다.
byte[]와String이 맨 위에 보일 뿐, 그것을 붙잡은 진짜 원인은 retained heap에서 보인다. - 덤프 파일을 아무 데나 옮긴다. 힙 덤프는 운영 데이터의 사본이다.
장애 대응 점검표
- 장애 시 "덤프 후 재시작" 절차가 운영 문서에 있다
- 덤프를 뜰 계정과
jcmd명령이 서버별로 정리돼 있다 - 이중화 노드를 로드밸런서에서 빼는 방법을 안다
- Thread Dump는 5~10초 간격으로 세 번 뜬다
- CPU 과다 때
top -H의 스레드 번호를 16진수로 바꿔 덤프의nid와 맞춘다 -
HeapDumpOnOutOfMemoryError와 덤프 경로가 설정돼 있다 - 덤프 경로의 빈 용량이 최대 힙보다 크다
- GC 로그가 남고 보관 개수가 정해져 있다
- 분석용 PC에 MAT가 있고 큰 덤프를 열 만큼 메모리 설정이 돼 있다
- 덤프 파일의 보관·반출·삭제 규칙이 있다
장애 분석은 재시작 전에 남긴 기록의 질로 정해진다. 응답이 멈추면 Thread Dump를 세 번, 메모리가 새면 Heap Dump를 한 번 뜨고, 같은 자리에 몰린 스레드와 큰 객체를 붙잡은 참조 경로를 따라가면 원인 코드 줄에 닿는다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.