Kafka 컨슈머 장애의 상당수는 메시지가 아니라 그룹에서 생긴다. 컨슈머 하나가 늦게 응답하면 그룹 전체가 파티션을 다시 나누느라 멈추고, 쌓인 Lag가 다음 rebalance를 부른다. 이 글은 rebalance가 일어나는 계기, 멈추는 범위를 줄이는 설정, Lag를 읽고 원인별로 대응하는 순서를 정리한 것이다.
한눈에 보기
| 증상 | 흔한 원인 | 첫 조치 |
|---|---|---|
| 배포·재시작 때마다 전체 처리가 수십 초 멈춤 | eager 방식 rebalance, 동적 멤버십 | CooperativeStickyAssignor, group.instance.id |
| 같은 컨슈머가 몇 분마다 그룹에서 빠졌다 들어옴 | 배치 처리 시간이 max.poll.interval.ms 초과 |
max.poll.records 축소, 처리 시간 측정 |
| Lag가 꾸준히 증가 | 소비 속도 < 생산 속도 | 컨슈머·파티션 수, 하위 시스템 병목 확인 |
| 한 파티션만 Lag가 큼 | 키 쏠림(hot key) | 키 설계, 파티션별 처리 시간 확인 |
| rebalance 뒤 같은 메시지가 다시 처리됨 | 넘겨주기 전에 오프셋을 커밋하지 않음 | onPartitionsRevoked에서 동기 커밋 |
중복 자체를 없애는 방법은 Exactly-Once Processing은 정말 가능한가에서 다뤘다. 이 글은 중복과 지연의 빈도를 줄이는 쪽이다.
Rebalance는 언제 일어나나
그룹 코디네이터(브로커)는 멤버나 구독 대상이 바뀌면 배정을 다시 한다.
- 멤버 합류: 새 인스턴스가 뜨거나 스케일 아웃을 했다.
- 정상 이탈: 컨슈머가
close()를 부르며 LeaveGroup을 보냈다. - heartbeat 끊김:
session.timeout.ms동안 heartbeat가 없어 코디네이터가 멤버를 뺐다. 프로세스 종료, 긴 GC 정지, 네트워크 단절이 원인이다. - poll 간격 초과:
poll()호출 사이가max.poll.interval.ms를 넘으면 컨슈머가 스스로 그룹을 떠난다. heartbeat는 별도 스레드가 보내므로 살아 있어도 이 조건에 걸린다. - 구독 변화: 토픽 파티션 수가 늘었거나 패턴 구독에 새 토픽이 잡혔다.
가장 흔한 것은 네 번째다. max.poll.records × 건당 처리 시간이 max.poll.interval.ms를 넘으면 처리 중에 그룹에서 빠지고, 다시 들어와 같은 배치를 또 받는다. 예시로 500건 × 0.8초 = 400초면 기본값 300초를 넘어 같은 자리를 맴돈다.
멈추는 범위 줄이기: Eager, Cooperative, KIP-848
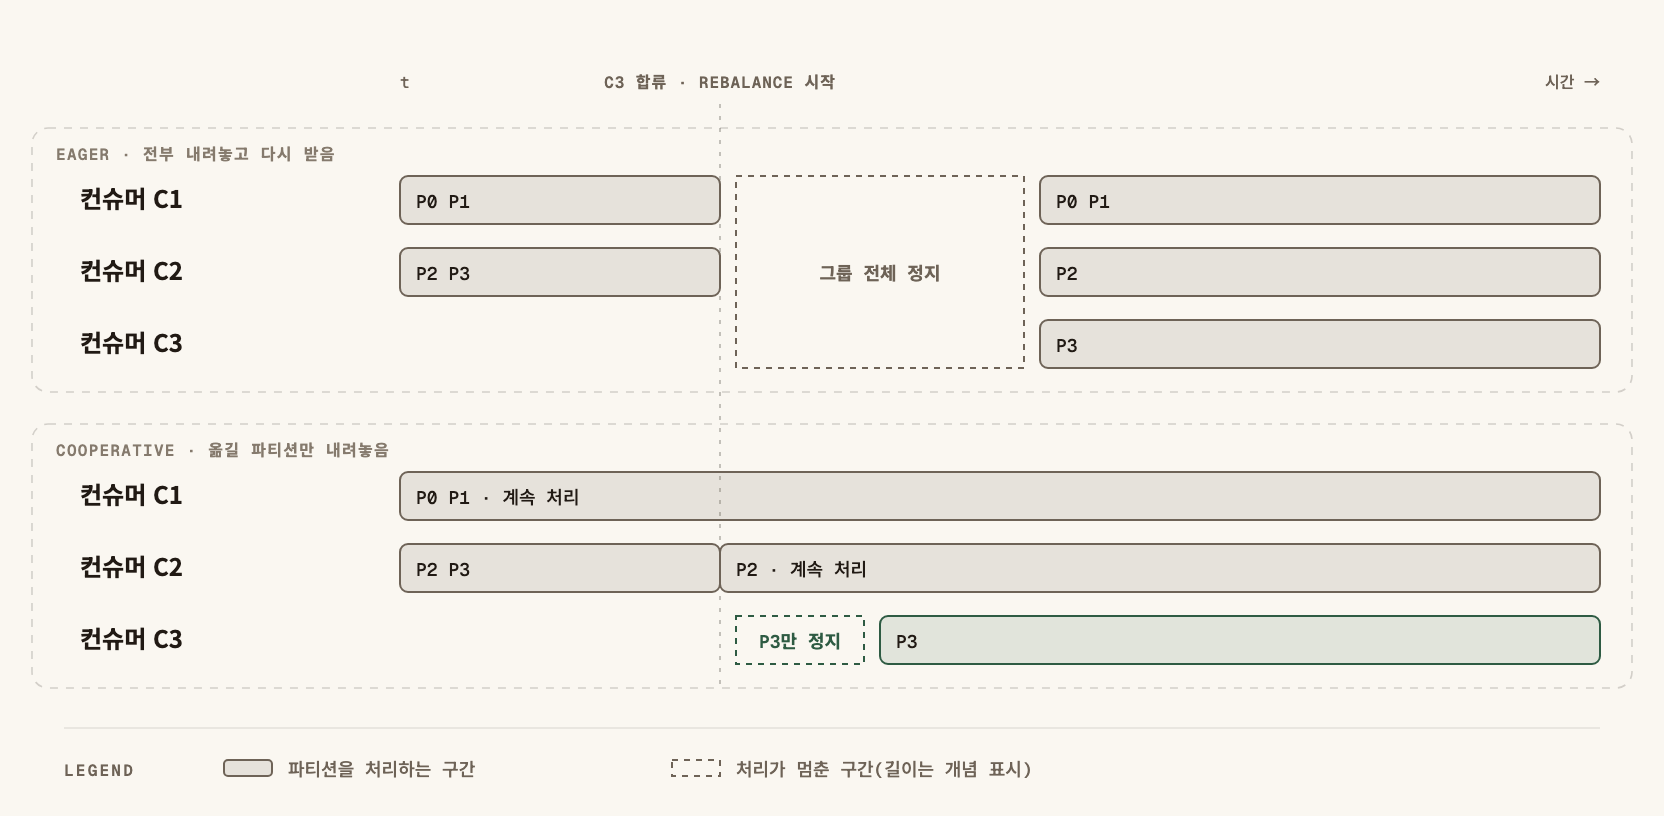
Eager(기존 방식): 모든 멤버가 파티션을 전부 내려놓고(revoke) 새 배정을 받는다. 하나만 옮기면 될 때도 그룹 전체가 멈춘다. RangeAssignor, RoundRobinAssignor가 이 방식이다.
Cooperative(점진 방식): 계속 가질 파티션은 쥔 채로 두고, 옮겨 갈 파티션만 내려놓는다. 두 번의 짧은 라운드로 나뉘지만 나머지 파티션은 처리가 멈추지 않는다. partition.assignment.strategy에 CooperativeStickyAssignor를 쓴다.
운영 중인 그룹은 두 번에 나눠 배포한다. 첫 배포에서 기존 assignor와 CooperativeStickyAssignor를 함께 두고, 모두 바뀐 뒤 기존 것을 뺀다. 한 번에 바꾸면 방식이 섞인 멤버끼리 배정을 맞추지 못한다.
KIP-848(새 그룹 프로토콜): 배정 계산과 조정을 브로커가 맡고, 멤버마다 따로 점진적으로 배정을 바꾼다. 그룹 전체가 한꺼번에 맞추는 동기화 단계가 없다. 클라이언트에서 group.protocol=consumer로 켠다. Apache Kafka 4.0에서 정식 기능이 됐지만, 브로커·클라이언트 라이브러리 지원 버전을 먼저 확인한다. 세션 타임아웃, assignor 같은 일부 설정은 브로커 쪽 그룹 설정으로 옮겨 간다.
Static Membership: 재시작을 rebalance로 만들지 않기
인스턴스 열 개를 롤링 재시작하면 동적 멤버십에서는 이탈과 합류마다 rebalance가 일어나 최대 스무 번이 된다.
group.instance.id를 주면 멤버가 고정 ID를 갖는다. 고정 멤버는 종료할 때 LeaveGroup을 보내지 않고, session.timeout.ms 안에 같은 ID로 돌아오면 이전 배정을 그대로 받는다. rebalance가 없다.
- ID는 재시작해도 바뀌지 않아야 한다. Kubernetes라면 StatefulSet의 Pod 이름이 맞다.
session.timeout.ms는 재시작 시간보다 길게 둔다. 대가는 진짜 장애를 늦게 감지하는 것이다. 60초로 두면 죽은 인스턴스의 파티션이 최대 60초 동안 처리되지 않는다.- 종료 처리 순서는 Kubernetes Pod Lifecycle과 Graceful Shutdown 설계와 맞춘다. SIGTERM을 받으면 poll 루프를 멈추고 커밋한 뒤
close()한다.
group.instance.id=${HOSTNAME}
partition.assignment.strategy=org.apache.kafka.clients.consumer.CooperativeStickyAssignor
session.timeout.ms=60000
heartbeat.interval.ms=3000
max.poll.interval.ms=300000
max.poll.records=100
| 설정 | 정하는 것 | 잘못 두면 |
|---|---|---|
session.timeout.ms |
죽은 멤버를 판정하는 시간 | 짧으면 GC 정지에도 빠짐, 길면 장애 감지 지연 |
heartbeat.interval.ms |
heartbeat 주기 | 세션 타임아웃의 1/3보다 길면 일시 지연에 빠짐 |
max.poll.interval.ms |
poll 사이 최대 처리 시간 | 배치 처리 시간보다 짧으면 rebalance 반복 |
max.poll.records |
한 번에 받는 건수 | 크면 위 조건에 걸림, 작으면 왕복이 늘어 처리량 감소 |
group.instance.id |
고정 멤버 ID | 재시작마다 바뀌면 static membership 효과 없음 |
Consumer Lag 측정과 읽는 법
Lag는 파티션마다 로그 끝 오프셋 − 커밋한 오프셋이다. 건수라서 소비 속도로 나눠 시간으로 바꿔 읽는다.
kafka-consumer-groups.sh --bootstrap-server broker1:9092 \
  --describe --group order-service
CURRENT-OFFSET, LOG-END-OFFSET, LAG 열을 파티션별로 본다. 상시 감시는 이 값을 Prometheus 같은 시계열에 모으고 클라이언트 지표 records-lag-max를 함께 본다.
계산 예시(수치는 예시다): 초당 1,200건이 들어오는 토픽을 파티션 6개, 컨슈머 3개가 각각 초당 300건씩, 합계 900건으로 처리한다. 초당 300건씩 모자라 10분이면 Lag가 180,000건이 된다. 컨슈머를 6개로 늘리면 처리 능력이 1,800건이 되고, 남는 600건으로 180,000건을 300초, 즉 5분 만에 따라잡는다. 7개로 늘리면 파티션이 6개라 하나는 논다. 그룹 병렬도의 상한은 파티션 수다.
Lag가 쌓일 때 원인별 대응
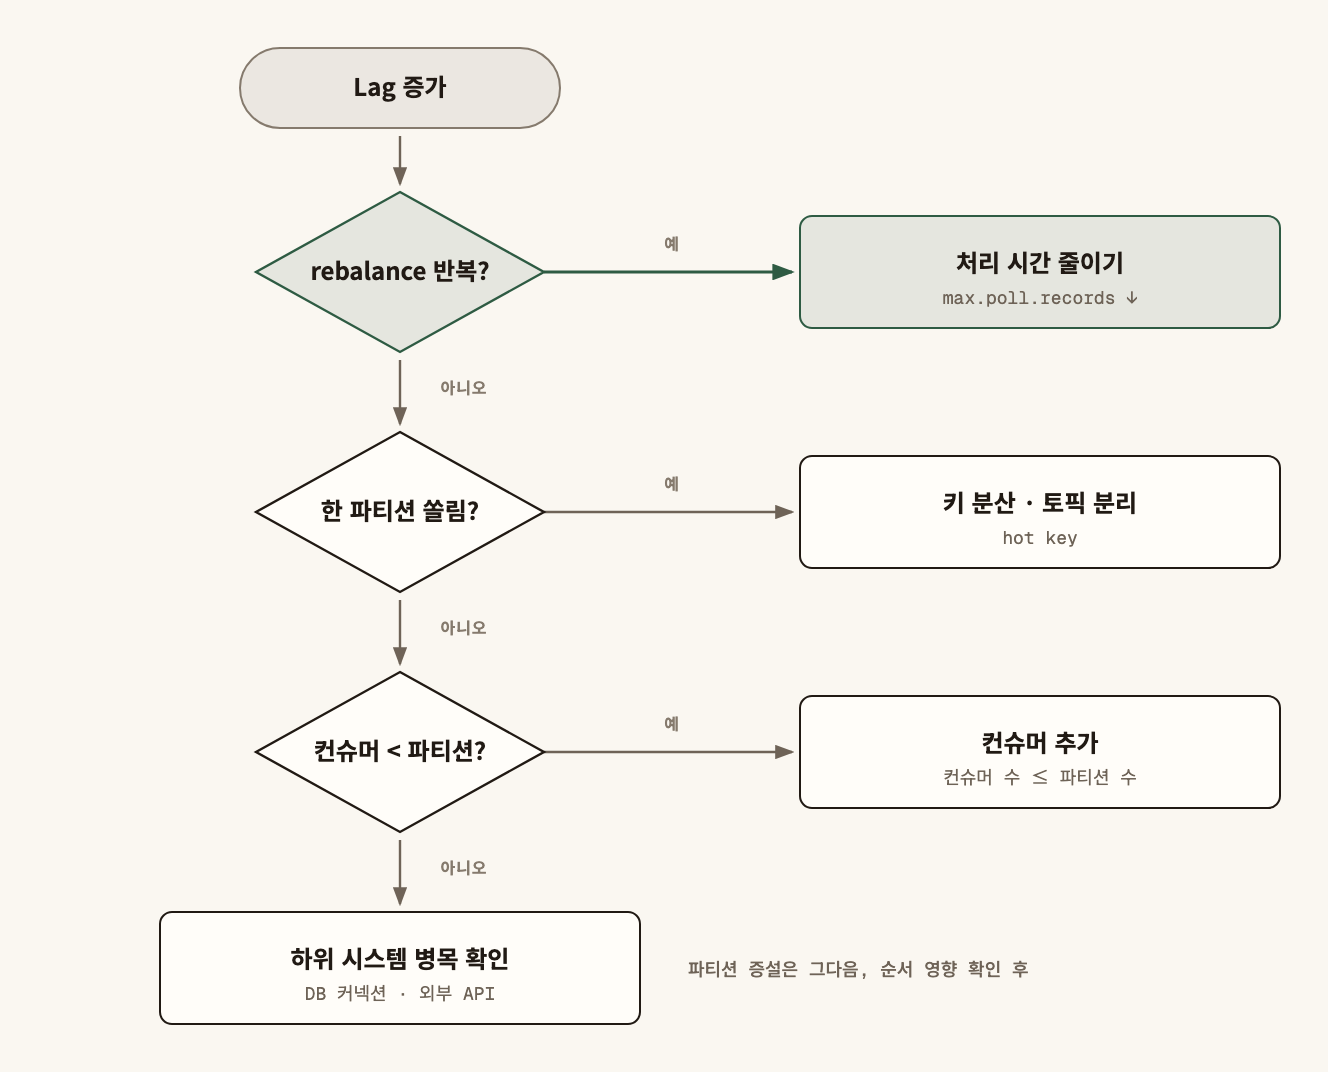
- rebalance가 반복되는가. 그룹 재합류 로그가 몇 분마다 찍히면 처리 시간 문제다. 배치 처리 시간을 재고
max.poll.records를 줄인다. 느린 외부 호출이 원인이면pause()한 채 처리하고resume()한다. - 한 파티션에만 몰렸는가. 특정 키가 쏠렸다. 그 파티션은 컨슈머를 늘려도 하나만 읽는다. 키 설계를 바꾸거나 쏠린 키를 별도 토픽으로 뺀다.
- 전체 소비 속도가 모자라는가. 컨슈머가 파티션보다 적으면 늘린다. 같으면 하위 시스템을 본다. 처리 시간 대부분이 DB 쓰기라면 컨슈머를 늘릴수록 DB 커넥션이 먼저 바닥난다. 컨슈머 안에서 가상 스레드로 처리를 병렬화할 때도 같은 함정이 있다(Java Virtual Thread 도입 시 Pinning과 자원 고갈 함정).
- 파티션 수를 늘려야 하는가. 마지막 수단이다. 키와 파티션의 대응이 바뀌어 같은 키의 순서가 잠시 깨진다. 순서가 중요하면 새 토픽으로 옮긴다. 새 구조를 먼저 넓히고 옛것을 나중에 걷는 순서는 무중단 DB 스키마 변경을 위한 Expand-Contract 패턴과 같다.
생산 쪽 설계는 CDC와 Debezium, Outbox·Inbox 패턴 글을 함께 본다.
파티션을 넘기기 전에 커밋하기
파티션을 내려놓을 때 처리한 오프셋을 커밋하지 않으면 새 주인이 같은 메시지를 다시 처리한다. ConsumerRebalanceListener로 넘기기 직전에 커밋한다. 콜백은 poll() 안에서 같은 스레드로 불리므로 여기서 컨슈머를 써도 안전하다.
Map<TopicPartition, OffsetAndMetadata> processed = new HashMap<>();

consumer.subscribe(List.of("orders"), new ConsumerRebalanceListener() {
    @Override
    public void onPartitionsRevoked(Collection<TopicPartition> partitions) {
        Map<TopicPartition, OffsetAndMetadata> toCommit = new HashMap<>();
        for (TopicPartition tp : partitions) {
            OffsetAndMetadata om = processed.remove(tp);
            if (om != null) toCommit.put(tp, om);
        }
        if (!toCommit.isEmpty()) consumer.commitSync(toCommit); // 넘기기 전 동기 커밋
    }

    @Override
    public void onPartitionsAssigned(Collection<TopicPartition> partitions) { }

    @Override
    public void onPartitionsLost(Collection<TopicPartition> partitions) {
        partitions.forEach(processed::remove); // 이미 남의 것일 수 있어 커밋하지 않는다
    }
});

while (running) {
    for (ConsumerRecord<String, String> r : consumer.poll(Duration.ofMillis(500))) {
        handle(r);
        processed.put(new TopicPartition(r.topic(), r.partition()),
                      new OffsetAndMetadata(r.offset() + 1));
    }
    consumer.commitAsync(new HashMap<>(processed), null);
}
onPartitionsLost의 기본 구현은 onPartitionsRevoked를 부른다. 세션 만료로 잃은 파티션은 이미 다른 컨슈머 것일 수 있어, 그대로 두면 커밋이 실패하거나 남의 진행 위치를 덮는다. 그래서 따로 구현한다. cooperative 방식에서 onPartitionsRevoked는 실제로 옮겨 가는 파티션에만 불린다.
자주 하는 실수
max.poll.interval.ms만 늘린다. 처리 시간이 길어진 원인을 가린다. 진짜 멈춘 컨슈머도 그만큼 늦게 감지된다.
Lag 합계만 감시한다. 파티션 하나에 몰린 Lag는 합계에서 작게 보인다. 파티션별 최댓값과 시간 환산 값으로 경보를 건다.
컨슈머를 파티션 수보다 많이 띄운다. 넘는 컨슈머는 배정을 못 받고 놀며, 합류할 때마다 rebalance만 일으킨다.
Deployment Pod 이름으로 group.instance.id를 준다. 재시작마다 ID가 바뀌어 효과가 없고, 옛 ID는 세션 타임아웃까지 파티션을 쥔 채 남는다.
점검표
- 배치당 최대 처리 시간(
max.poll.records× 건당 처리 시간)이max.poll.interval.ms보다 충분히 짧다. -
partition.assignment.strategy가CooperativeStickyAssignor이거나 KIP-848 프로토콜을 쓴다. - 롤링 배포 컨슈머에 고정된
group.instance.id가 있다. -
session.timeout.ms가 재시작 시간보다 길고, 그만큼의 장애 감지 지연을 받아들였다. -
onPartitionsRevoked에서 처리한 오프셋을 동기 커밋하고,onPartitionsLost에서는 커밋하지 않는다. - SIGTERM을 받으면 poll 루프를 멈추고 커밋한 뒤
close()한다. - Lag를 파티션별로 수집하고, 소비 속도로 나눈 시간 값으로 경보를 건다.
- 컨슈머 수가 파티션 수 이하다.
- 파티션 수를 늘리기 전에 같은 키 순서가 깨져도 되는지 확인했다.
Rebalance는 멈추는 범위를 줄이고(cooperative, static membership), 처리 시간을 poll 간격 안에 두고, 넘기기 전에 커밋하면 길들일 수 있고, Lag는 파티션별로 시간으로 바꿔 읽어야 원인이 보인다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.