분산 추적은 서비스마다 span을 남기는 것만으로 완성되지 않는다. 요청이 HTTP, Kafka, 스레드 풀을 건널 때마다 같은 trace-id가 넘어가야 하고, 한 곳에서 빠지면 trace가 둘로 끊긴다. 이 글은 W3C Trace Context 형식, Propagator와 Baggage, 메시징·비동기 구간의 전파, Head·Tail 샘플링, 로그 연결까지 OpenTelemetry Java를 기준으로 정리한다.
한눈에 보기
| 구성요소 | 하는 일 | 빠지면 생기는 일 |
|---|---|---|
traceparent 헤더 |
trace-id, 부모 span-id, 샘플링 여부 전달 | 다음 서비스가 새 trace를 시작한다 |
| Propagator | 헤더를 넣고(inject) 꺼낸다(extract) | 계측은 됐는데 서비스 사이가 이어지지 않는다 |
| Context | 현재 스레드의 활성 span 보관 | 스레드 풀로 넘어간 작업이 부모를 잃는다 |
| Sampler | 남길 trace를 고른다 | 저장 비용이 폭증하거나 오류 trace를 놓친다 |
| Collector | 받아서 거르고 내보낸다 | 내보낼 곳·샘플링 규칙이 서비스마다 흩어진다 |
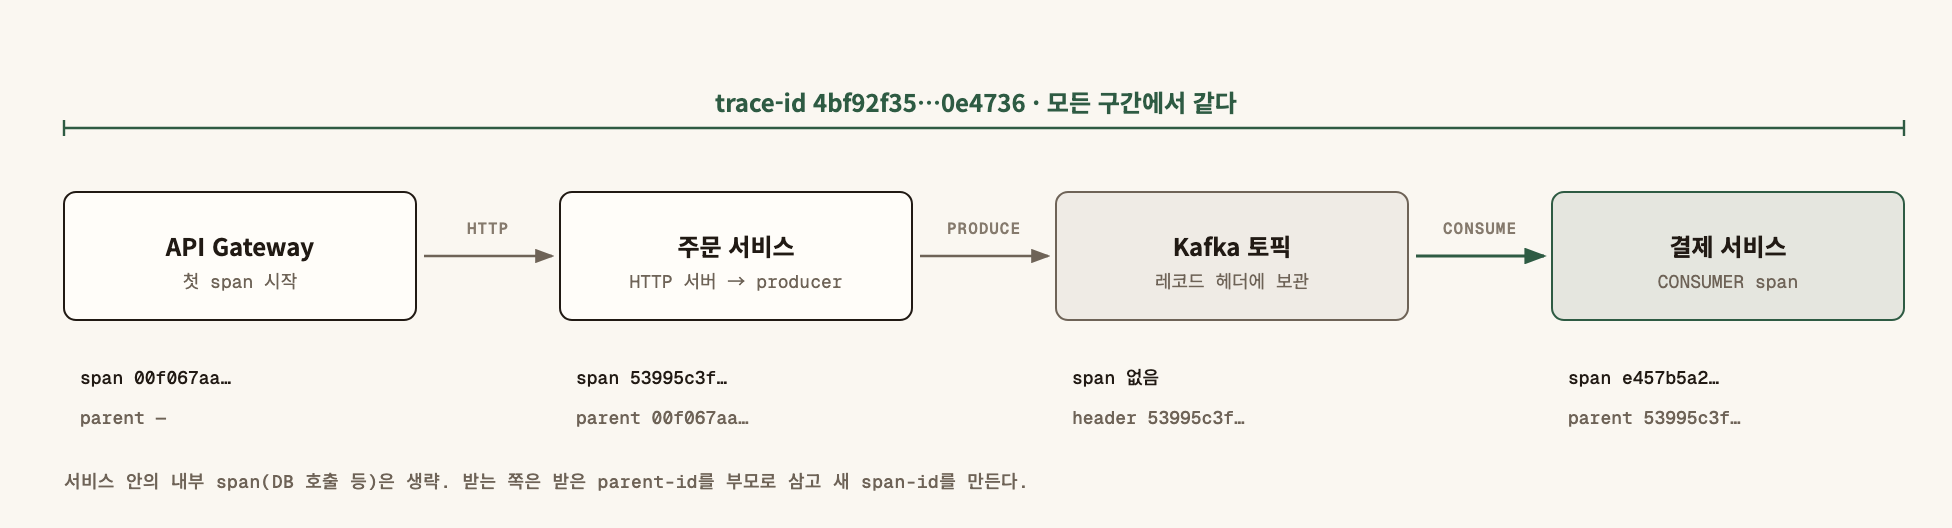
traceparent 한 줄에 담긴 것
W3C Trace Context는 HTTP 헤더 두 개를 정의한다. 핵심은 traceparent다.
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
             │  │                                │                └ trace-flags (01 = sampled)
             │  │                                └ parent-id: 호출한 쪽 span-id, 16진수 16자
             │  └ trace-id: 요청 전체의 ID, 16진수 32자
             └ version
- trace-id는 끝까지 그대로고, 서비스를 지날 때마다 parent-id가 바뀐다.
- 받는 쪽은 parent-id를 자기 span의 부모로 삼고, 새 span-id를 만들어 다음 호출의 parent-id로 보낸다.
- 모두 0인 ID나 형식이 틀린 헤더를 받으면 새 trace를 시작한다.
- 마지막
01은 "앞에서 이 trace를 남기기로 했다"는 표시다. 뒤쪽 샘플러가 이 값을 따를지 정한다.
tracestate와 baggage는 무엇이 다른가
tracestate는 추적 벤더가 자기 정보를 덧붙이는 칸(vendor=값 목록)으로, 애플리케이션이 직접 쓸 일은 드물다.
baggage는 별도의 W3C Baggage 표준으로, 애플리케이션이 다음 서비스에 넘기고 싶은 키·값을 싣는다.
baggage: tenant=gov-a,channel=mobile
- baggage는 span 속성에 자동으로 들어가지 않는다. 보려면 받은 쪽에서 span에 직접 넣는다.
- 모든 하위 호출로 퍼지고 외부 API까지 따라갈 수 있다. 주민번호·토큰·이메일은 넣지 않는다.
Propagator: 헤더를 넣고 꺼내는 쪽
Propagator는 Context를 헤더에 넣고(inject) 헤더에서 꺼낸다(extract). OpenTelemetry Java agent를 붙이면 Spring MVC, WebClient, RestTemplate, Kafka 클라이언트에서 이 일을 대신한다.
java -javaagent:/opt/otel/opentelemetry-javaagent.jar \
  -Dotel.service.name=order-service \
  -Dotel.exporter.otlp.endpoint=http://otel-collector:4318 \
  -Dotel.propagators=tracecontext,baggage \
  -Dotel.traces.sampler=parentbased_traceidratio \
  -Dotel.traces.sampler.arg=1.0 \
  -jar order-service.jar
otel.propagators기본값이tracecontext,baggage다. Zipkin 계열 서비스와 섞여 있으면b3multi를 더해 두 형식을 모두 읽게 한다.- 4318은 OTLP/HTTP, 4317은 OTLP/gRPC 포트다. 기본 프로토콜은 agent 버전마다 다를 수 있어
otel.exporter.otlp.protocol을 명시한다. - 중간의 Gateway·Nginx·WAF가 헤더를 지우지 않는지 먼저 본다.
HTTP를 넘어: Kafka 헤더로 전파하기
agent가 Kafka producer·consumer를 계측하면 레코드 헤더에 traceparent가 자동으로 붙는다. 사내 큐 라이브러리처럼 계측이 안 되는 경로는 같은 일을 직접 한다.
TextMapPropagator propagator = GlobalOpenTelemetry.getPropagators().getTextMapPropagator();

// 보내는 쪽: 현재 Context를 레코드 헤더에 넣는다
TextMapSetter<Headers> setter = (headers, key, value) ->
        headers.add(key, value.getBytes(StandardCharsets.UTF_8));
ProducerRecord<String, String> record = new ProducerRecord<>("payment.requested", orderId, payload);
propagator.inject(Context.current(), record.headers(), setter);

// 받는 쪽: 헤더에서 부모 Context를 꺼내 CONSUMER span을 시작한다
TextMapGetter<Headers> getter = new TextMapGetter<>() {
    public Iterable<String> keys(Headers h) {
        return StreamSupport.stream(h.spliterator(), false).map(Header::key).toList();
    }
    public String get(Headers h, String key) {
        Header last = h == null ? null : h.lastHeader(key);
        return last == null ? null : new String(last.value(), StandardCharsets.UTF_8);
    }
};
Context parent = propagator.extract(Context.current(), consumerRecord.headers(), getter);
Span span = tracer.spanBuilder("payment.requested process")
        .setParent(parent).setSpanKind(SpanKind.CONSUMER).startSpan();
try (Scope ignored = span.makeCurrent()) {
    handle(consumerRecord);
} catch (RuntimeException e) {
    span.recordException(e);
    span.setStatus(StatusCode.ERROR);
    throw e;
} finally {
    span.end();
}
배치 consumer는 부모가 여럿이므로 각 메시지의 Context를 span link로 붙인다. Outbox로 늦게 보내는 구조라면 Outbox 행에 traceparent를 같이 저장해야 trace가 이어진다(관련 글: Outbox·Inbox 패턴으로 연계 데이터 정합성 확보하기).
비동기 스레드에서 컨텍스트가 사라지는 이유
Context는 ThreadLocal에 있다. 작업이 다른 스레드로 넘어가면 Context가 없어 새 trace가 시작된다.
- Java agent는
ExecutorService,CompletableFuture, Spring@Async, Reactor를 계측해 Context를 넘긴다. - agent 없이 SDK만 쓰면 직접 감싼다:
Context.taskWrapping(executor)로 실행기를 감싸거나Context.current().wrap(runnable)로 작업을 감싼다. - 직접 만든 스레드나 스케줄러 콜백은 agent도 놓칠 수 있다. trace 하나의 span 수가 예상과 맞는지 본다.
샘플링: Head, Tail, ParentBased
모든 trace를 저장하면 비용을 감당할 수 없다. 고르는 시점에 따라 두 방식이 있다.
| 방식 | 결정 시점 | 장점 | 한계 |
|---|---|---|---|
Head (traceidratio) |
첫 span 시작 때 | 싸고 단순, 서비스 부담 적음 | 오류·지연 trace인지 모르고 버린다 |
Tail (Collector tail_sampling) |
trace가 끝난 뒤 | 오류·느린 trace를 골라 남긴다 | Collector 메모리, 같은 trace를 한 인스턴스로 모아야 함 |
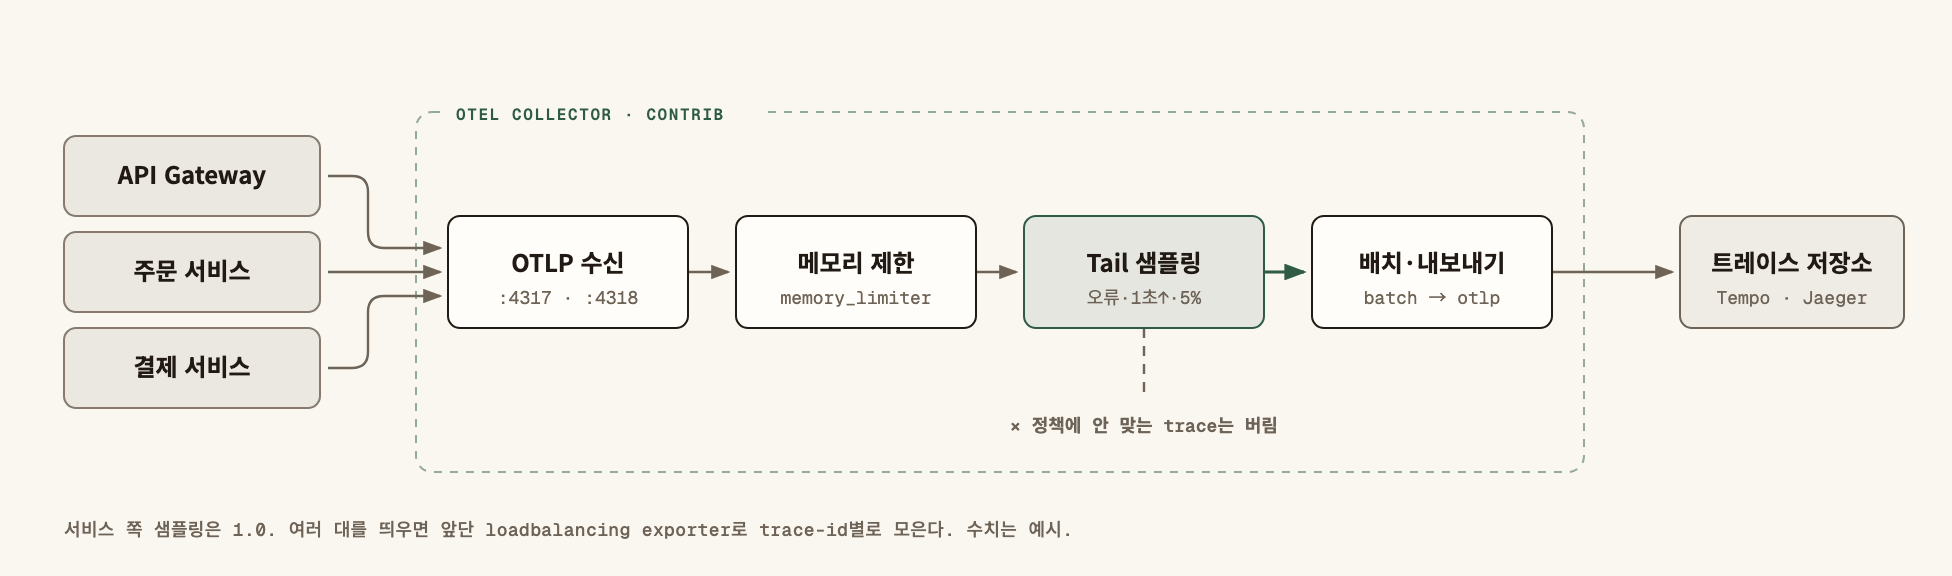
parentbased_* 샘플러는 부모의 trace-flags를 따른다. 루트 서비스만 비율을 정하고 나머지는 결정을 이어받으므로 trace 중간이 비는 일이 없다. Tail 샘플링을 쓸 때는 서비스 쪽 비율을 1.0으로 두어야 한다. 앞에서 버린 trace는 Collector가 볼 수 없다.
receivers:
  otlp:
    protocols:
      grpc: { endpoint: 0.0.0.0:4317 }
      http: { endpoint: 0.0.0.0:4318 }
processors:
  memory_limiter: { check_interval: 1s, limit_mib: 1500 }
  tail_sampling:
    decision_wait: 10s
    policies:
      - { name: errors, type: status_code, status_code: { status_codes: [ERROR] } }
      - { name: slow,   type: latency,     latency: { threshold_ms: 1000 } }
      - { name: base,   type: probabilistic, probabilistic: { sampling_percentage: 5 } }
  batch: {}
exporters:
  otlp/traces:
    endpoint: tempo:4317
    tls: { insecure: true }   # 예시용 평문 전송, 운영은 TLS 인증서 사용
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, tail_sampling, batch]
      exporters: [otlp/traces]
tail_sampling은 contrib 배포판에 있다. Collector를 여러 대 띄우면 앞단에 loadbalancing exporter를 두고 trace-id 기준으로 나눠야 한 trace의 span이 한 인스턴스에 모인다. 위 숫자(10초, 1000ms, 5%)는 예시이며 서비스의 P99와 저장 예산으로 정한다(관련 글: P95와 P99가 평균 응답 시간보다 중요한 이유).
로그와 트레이스 잇기
trace는 어디서 느렸는지, 로그는 왜 그랬는지를 알려 준다. 둘은 trace-id로 잇는다.
- Java agent는 Logback·Log4j MDC에
trace_id,span_id,trace_flags를 넣는다.
<pattern>%d{HH:mm:ss.SSS} %-5level [%X{trace_id},%X{span_id}] %logger{36} - %msg%n</pattern>
- Spring Boot 3의 Micrometer Tracing은 MDC 키가
traceId,spanId다. 섞어 쓰면 키 이름부터 맞춘다. - 경보는 메트릭으로 받고 원인은 trace와 로그로 좁힌다. 메트릭 쪽은 Prometheus·Grafana·Micrometer로 SLO 모니터링 구축 글에서 다뤘다.
정리
| 구간 | 전파 수단 | 누가 처리 | 확인 방법 |
|---|---|---|---|
| HTTP 호출 | traceparent, baggage 헤더 |
agent 자동 | 게이트웨이 앞뒤 헤더 덤프 |
| Kafka·MQ | 레코드 헤더 | agent 또는 직접 inject/extract | consumer span의 부모가 producer span인지 |
| 스레드 풀 | ThreadLocal Context | agent 또는 Context.taskWrapping |
trace당 span 수 |
자주 하는 실수
- 프록시가 헤더를 지운다. 계측은 정상인데 trace가 게이트웨이에서 끊긴다.
- 서비스마다 샘플링 비율을 따로 정한다. 부모는 남고 자식은 버려져 trace 중간이 빈다.
- Head 10%에 Tail 샘플링을 겹친다. 오류 trace의 90%는 Collector에 닿기 전에 사라진다.
- baggage에 개인정보를 넣는다. 외부 API 호출 헤더로 그대로 나간다.
- 배치 consumer에서 첫 메시지만 부모로 잡는다. 나머지 trace는 거기서 끊긴다.
점검표
- 모든 서비스의
otel.propagators가 같은 형식을 포함한다. - API Gateway·프록시를 지난 뒤에도
traceparent헤더가 남아 있다. - Kafka consumer span의 부모가 producer span으로 보인다.
-
@Async·스레드 풀 작업이 같은 trace-id로 기록된다. - 루트 서비스만 샘플링 비율을 정하고 나머지는
parentbased다. - Tail 샘플링을 쓰면 서비스 쪽 비율이 1.0이다.
- Collector를 여러 대 두면 trace-id 기준 로드밸런싱을 한다.
- 로그 한 줄에 trace_id·span_id가 찍힌다.
분산 추적의 품질은 span을 얼마나 많이 남기느냐가 아니라 trace-id가 모든 경계를 빠짐없이 건너느냐로 정해진다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.