LLM 서빙 비용과 응답 속도는 모델 크기보다 GPU 메모리를 어떻게 나눠 쓰는지에 더 크게 좌우된다. 이 글은 추론이 prefill과 decode 두 단계로 나뉘는 이유에서 시작해, KV Cache 메모리 계산, PagedAttention과 Prefix Caching, Quantization, Continuous Batching을 차례로 정리하고 vLLM 설정 예시와 점검표로 마무리한다.
한눈에 보기
| 기법 | 겨냥하는 병목 | 얻는 것 | 대가 |
|---|---|---|---|
| KV Cache | 같은 계산의 반복 | 토큰마다 앞 문맥을 다시 계산하지 않음 | 시퀀스 길이에 비례하는 메모리 |
| GQA·MQA | KV Cache 크기 | KV 메모리 감소 | 모델 구조에서 정해짐(서빙에서 못 바꿈) |
| PagedAttention | 메모리 단편화 | 같은 GPU에 더 많은 동시 요청 | 블록 관리 오버헤드 |
| Prefix Caching | 공통 프롬프트 재계산 | 첫 토큰까지 시간 단축 | 캐시 적중률에 따라 효과가 갈림 |
| Quantization | 가중치·KV를 읽는 바이트 수 | 메모리 절약, decode 가속 | 품질 저하 가능성 |
| Continuous Batching | GPU 유휴 슬롯 | 처리량 증가 | 스케줄러 튜닝 필요 |
Prefill과 Decode, 그리고 TTFT·TPOT
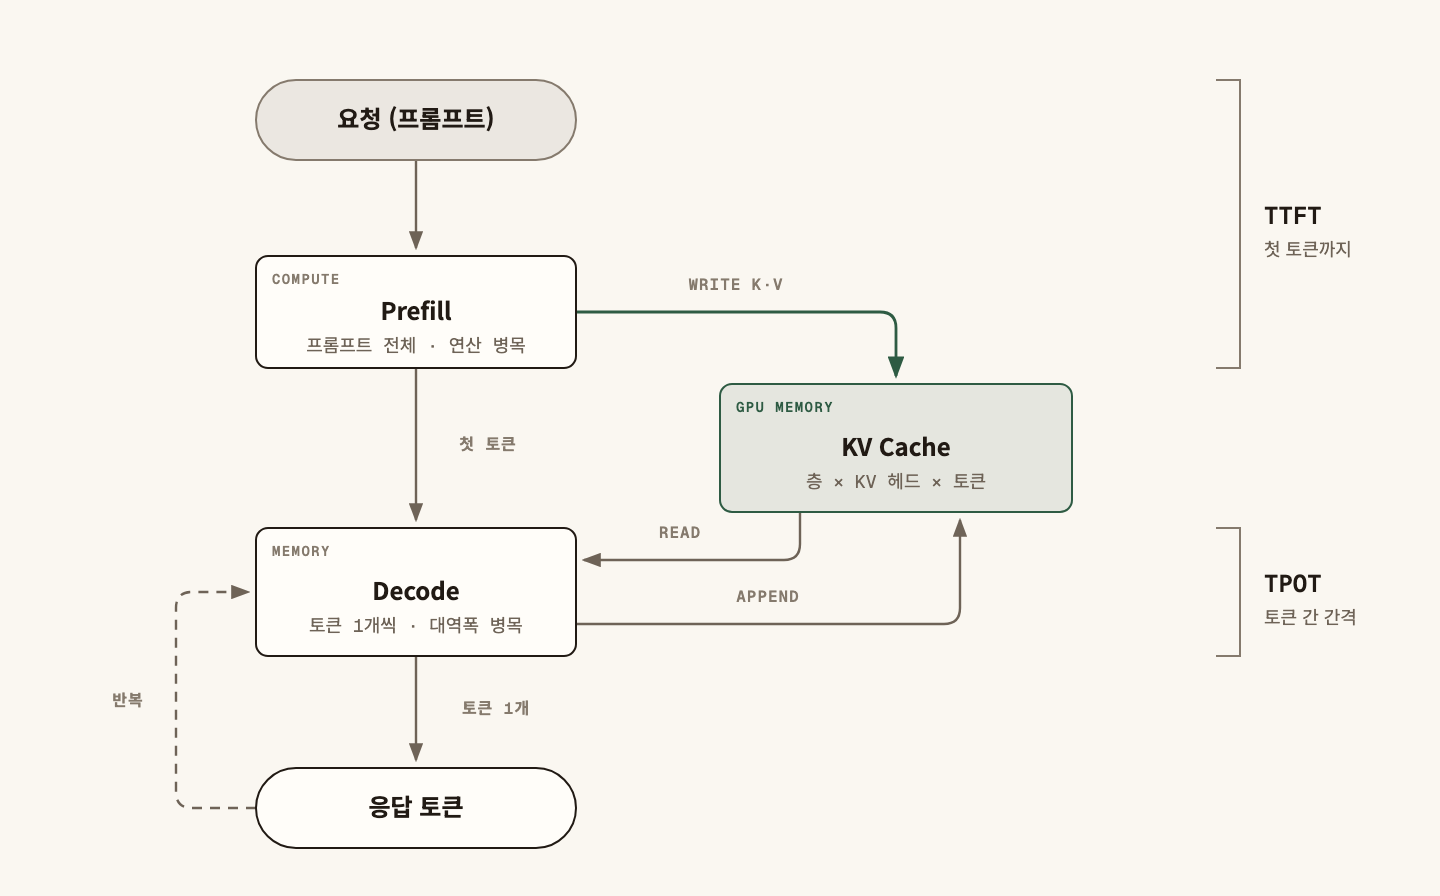
추론 한 번은 두 단계다.
- Prefill: 입력 프롬프트 전체를 한 번에 처리해 각 층의 Key·Value를 만든다. 토큰 수천 개를 행렬 곱 하나로 계산하므로 연산량이 병목이다(compute-bound).
- Decode: 토큰을 하나씩 만든다. 한 단계마다 모델 가중치 전체와 지금까지 쌓인 KV Cache를 메모리에서 읽지만 계산할 토큰은 하나뿐이다. 그래서 메모리 대역폭이 병목이다(memory-bandwidth-bound).
예시로 계산해 보면 감이 온다. FP16 8B 모델의 가중치는 약 16GB다. 대역폭이 2TB/s인 GPU라면 가중치를 한 번 읽는 데 약 8ms가 걸리므로, 요청 하나만 처리할 때 decode 속도의 이론상 상한은 초당 약 125토큰이다(KV 읽기는 뺀 값). 같은 8ms 동안 요청 32개를 함께 처리하면 가중치를 한 번 읽어 32개 토큰을 만든다. 배칭이 decode에서 효과가 큰 이유다.
두 단계는 사용자가 느끼는 지표도 다르다.
| 지표 | 정의 | 주로 결정하는 단계 |
|---|---|---|
| TTFT (Time To First Token) | 요청부터 첫 토큰까지 | prefill, 대기열 |
| TPOT (Time Per Output Token) | 첫 토큰 이후 토큰 간 평균 간격 | decode |
| 처리량 | 초당 생성 토큰 수(전체 요청 합) | 배치 크기 |
처리량을 올리려고 배치를 키우면 TPOT가 늘어난다. 그래서 목표는 "TTFT p95 1초 이내, TPOT p95 50ms 이내에서 처리량 최대"처럼 지연 상한을 먼저 정하고 그 안에서 처리량을 올리는 식으로 잡는다.
KV Cache 메모리 계산하기
KV Cache 크기는 공식 하나로 나온다.
KV 바이트 = 2(K와 V) × 층 수 × KV 헤드 수 × head_dim × 시퀀스 길이 × 배치 크기 × 원소당 바이트
예시: 32층, KV 헤드 8개, head_dim 128인 모델(Llama 3 8B와 같은 구성, 실제 값은 모델의 config.json에서 확인)을 FP16(2바이트)으로 돌린다.
- 토큰 하나: 2 × 32 × 8 × 128 × 2 = 131,072바이트 = 128KiB
- 8,192토큰 시퀀스 하나: 1GiB
- 8,192토큰 × 동시 16개: 16GiB
가중치 16GB에 KV 16GiB가 더해진다. 긴 문맥을 여러 개 받으면 KV가 가중치보다 커지는 일이 흔하다. 동시 요청 수를 정하는 것은 연산 능력이 아니라 이 메모리다.
같은 모델이 KV 헤드를 32개(쿼리 헤드 수와 같음, MHA) 썼다면 위 예시는 64GiB가 된다. GQA(Grouped-Query Attention)는 여러 쿼리 헤드가 KV 헤드 하나를 나눠 쓰고, MQA(Multi-Query Attention)는 KV 헤드를 하나만 둔다. 둘 다 학습 때 정해지는 구조라 서빙에서는 바꿀 수 없다. 모델을 고를 때 KV 헤드 수를 같이 보는 이유다.
PagedAttention과 Prefix Caching
초기 서빙 엔진은 요청마다 최대 길이만큼 KV 메모리를 연속으로 미리 잡았다. 실제로는 대부분 짧게 끝나므로 예약해 놓고 쓰지 않는 공간이 많았다.
vLLM의 PagedAttention(논문 "Efficient Memory Management for Large Language Model Serving with PagedAttention")은 운영체제의 페이징처럼 KV를 고정 크기 블록으로 나눠 필요할 때마다 할당한다. 블록 테이블이 논리 위치와 물리 블록을 잇기 때문에 메모리가 연속일 필요가 없다. 같은 GPU에 동시 요청을 더 많이 올릴 수 있게 된다.
블록 단위로 관리하면 공유도 쉬워진다. Prefix Caching은 시스템 프롬프트나 긴 문서처럼 앞부분이 같은 요청들이 그 부분의 KV 블록을 다시 계산하지 않고 재사용하게 한다. 효과를 보려면 프롬프트 앞부분을 고정해야 한다.
- 시스템 프롬프트, 도구 정의, 공통 문서를 맨 앞에 둔다.
- 날짜·요청 ID처럼 매번 바뀌는 값은 뒤로 보낸다. 앞에 하나만 끼어도 그 뒤 전체가 적중하지 않는다.
응답 자체를 재사용하는 캐시는 층위가 다르다. 그 설계는 LLM Semantic Cache 설계와 캐시 오염 방지에서 다룬다.
Quantization: 줄이는 바이트와 잃는 품질
양자화는 숫자를 적은 비트로 표현해 메모리와 대역폭을 아낀다. 대상에 따라 세 갈래다.
- 가중치 전용(weight-only) INT8·INT4: GPTQ, AWQ가 대표적이다. 8B 모델 가중치가 FP16 약 16GB에서 INT4 약 4GB대로 줄어든다(스케일 값 등 부가 정보는 별도). 연산 직전에 다시 풀어 FP16으로 계산하므로, decode처럼 메모리를 읽는 시간이 지배하는 구간에서 이득이 크고 큰 배치로 연산이 병목이 되면 이득이 줄어든다.
- FP8 가중치·활성화: FP8 텐서 연산을 지원하는 GPU에서 연산 자체를 FP8로 한다. prefill처럼 연산이 병목인 구간에도 효과가 있다.
- KV Cache 양자화: KV를 FP8로 저장하면 위 예시의 16GiB가 8GiB가 된다. 같은 메모리로 동시 요청을 두 배 받을 수 있다. 긴 문맥에서 정확도가 떨어지는지 따로 확인해야 한다.
품질 저하는 평균 점수에서 잘 안 보이고 특정 작업에서 드러난다. 수학 풀이, 코드 생성, 긴 문서 인용, 한국어처럼 학습 비중이 작은 언어가 먼저 흔들린다. 양자화 전후로 같은 평가 세트를 돌려 작업별로 비교한다. 평가 세트를 회귀 테스트로 굳히는 방법은 AI Agent Eval 파이프라인과 회귀 테스트 자동화에 정리했다.
Batching: Static에서 Continuous로
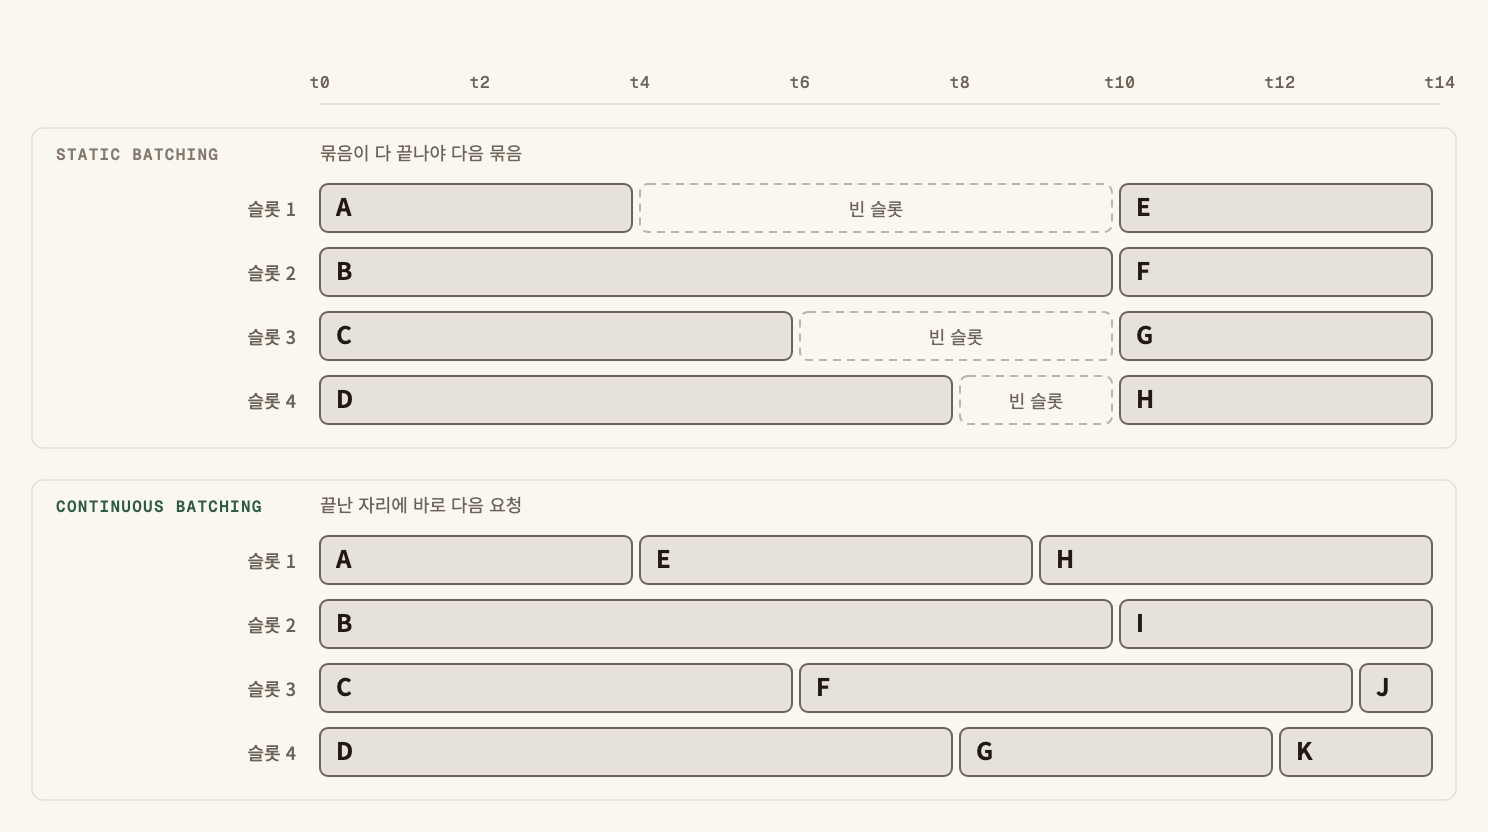
Static batching은 요청 여러 개를 묶어 시작하고 묶음 전체가 끝날 때까지 새 요청을 받지 않는다. 짧은 응답이 먼저 끝나도 그 자리는 가장 긴 응답이 끝날 때까지 빈다.
Continuous batching(Orca 논문의 iteration-level scheduling)은 decode 한 단계마다 배치를 다시 짠다. 끝난 요청은 바로 빠지고 대기 중인 요청이 그 자리에 들어간다.
새로 들어온 요청의 prefill이 길면 진행 중인 요청들의 decode가 그동안 멈춰 TPOT가 튄다. Chunked prefill은 긴 prefill을 조각으로 나눠 decode 단계 사이에 섞어 이 문제를 줄인다.
Speculative decoding은 작은 초안 모델이 토큰 몇 개를 먼저 제안하고 큰 모델이 한 번의 forward로 검증하는 방식이다. 검증 규칙을 지키면 출력 분포는 큰 모델과 같다. 효과는 제안이 받아들여지는 비율에 달려 있고, GPU가 놀고 있는 작은 배치에서 이득이 크다.
vLLM 설정 예시
아래는 AWQ 4비트 모델을 FP8 KV Cache로 띄우는 예시다. 옵션 이름과 기본값은 버전마다 달라지므로 설치한 버전의 vllm serve --help와 공식 문서로 확인한다.
vllm serve ./models/my-8b-awq \
  --quantization awq \
  --kv-cache-dtype fp8 \
  --max-model-len 8192 \
  --max-num-seqs 64 \
  --gpu-memory-utilization 0.90 \
  --enable-prefix-caching
--max-model-len: 요청 하나의 최대 토큰 수. 실제 필요보다 크게 잡으면 동시 요청 수가 줄어든다.--max-num-seqs: 한 번에 decode하는 최대 요청 수. TPOT 상한을 보며 조정한다.--gpu-memory-utilization: GPU 메모리 중 vLLM이 쓸 비율. 가중치를 뺀 나머지가 KV 블록이 된다.--enable-prefix-caching: 버전에 따라 기본으로 켜져 있다.
| 조정 | 누가 보나 | 안 하면 생기는 일 |
|---|---|---|
max-model-len을 실제 분포에 맞춤 |
서빙 운영자 | 쓰지 않는 길이에 KV 메모리 예약 |
| KV dtype·가중치 양자화 | ML 엔지니어 | 같은 GPU로 받을 수 있는 동시 요청이 절반 |
| 프롬프트 앞부분 고정 | 애플리케이션 개발자 | Prefix Caching 적중 0 |
| 지연 상한 SLO | 서비스 책임자 | 처리량만 올리다 TPOT가 늘어남 |
어떤 요청을 큰 모델로 보낼지 정하는 것은 서빙 위 계층의 일이다. AI Agent의 비용 최적화: Model Routing과 Token Budget에서 이어서 다룬다.
자주 하는 실수
- 평균 지연만 본다. 배치가 커질 때 늘어나는 것은 p95·p99 TPOT라서 평균으로는 늦게 발견한다.
max-model-len을 모델 최대치로 둔다. 대부분 요청이 2천 토큰인데 128K를 허용하면 그만큼 KV를 대비하느라 동시 처리 수가 줄어든다.- 양자화 품질을 벤치마크 평균 하나로 판단한다. 작업별로 갈라 보지 않으면 코드·수학·한국어 같은 특정 영역의 하락을 놓친다.
- 프롬프트 맨 앞에 시각이나 요청 ID를 넣는다. 공통 접두사가 깨져 Prefix Caching이 거의 적중하지 않는다.
- 처리량을 배치 크기 하나로 해결하려 한다. KV 메모리가 차면 요청이 대기하거나 밀려나므로 메모리 계산을 먼저 해야 한다.
점검표
- 모델
config.json에서 층 수, KV 헤드 수, head_dim을 확인하고 토큰당 KV 바이트를 계산했다. - 실제 요청 길이 분포(p50·p95)를 보고
max-model-len을 정했다. - TTFT·TPOT의 p95 목표를 숫자로 정했다.
- 부하 테스트에서 동시 요청 수를 늘려 가며 TPOT p95가 목표를 넘는 지점을 찾았다.
- 양자화 전후로 같은 평가 세트를 작업별로 비교했다.
- KV Cache FP8을 켰다면 긴 문맥 요청의 정확도를 따로 확인했다.
- 시스템 프롬프트와 도구 정의를 프롬프트 맨 앞에 고정했다.
- Prefix Caching 적중률을 지표로 보고 있다.
- 서빙 엔진 버전을 고정하고 옵션 기본값을 그 버전 문서로 확인했다.
LLM 추론 최적화는 KV Cache 메모리를 계산해 동시 요청 수의 한계를 알고, 양자화와 페이징으로 그 한계를 넓히고, continuous batching으로 빈 슬롯을 없애되 TTFT·TPOT 상한 안에서만 처리량을 올리는 일이다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.