Semantic Cache는 "뜻이 같은 질문"에 지난 답을 돌려줘서 LLM 호출 비용과 지연을 줄인다. 대신 틀린 답, 다른 사용자의 개인정보, 프롬프트 인젝션에 오염된 답까지 그대로 재사용될 수 있다. 이 글은 Exact-match 캐시와의 차이, 캐시 키 구성, 유사도 임계값을 정하는 방법, 그리고 캐시 오염이 들어오는 네 갈래와 이를 막는 장치를 정리한다.
한눈에 보기
| 단계 | 하는 일 | 잘못하면 |
|---|---|---|
| 키 만들기 | 질문 정규화 + 모델·프롬프트 버전·테넌트·로케일로 범위 결정 | 다른 사용자·다른 버전의 답이 섞인다 |
| 조회 | 범위 안에서만 벡터 검색, 유사도가 임계값 이상이면 hit | 비슷하지만 다른 질문에 엉뚱한 답(false hit) |
| 생성 | miss면 LLM 호출 | 비용은 그대로 |
| 저장 허용 | 검증된 답만 TTL·버전 태그와 함께 저장 | 오염된 답이 계속 재사용된다 |
| 사후 관리 | 부정 피드백 삭제, 버전 무효화, 감사 로그 | 오염을 찾아도 지울 방법이 없다 |
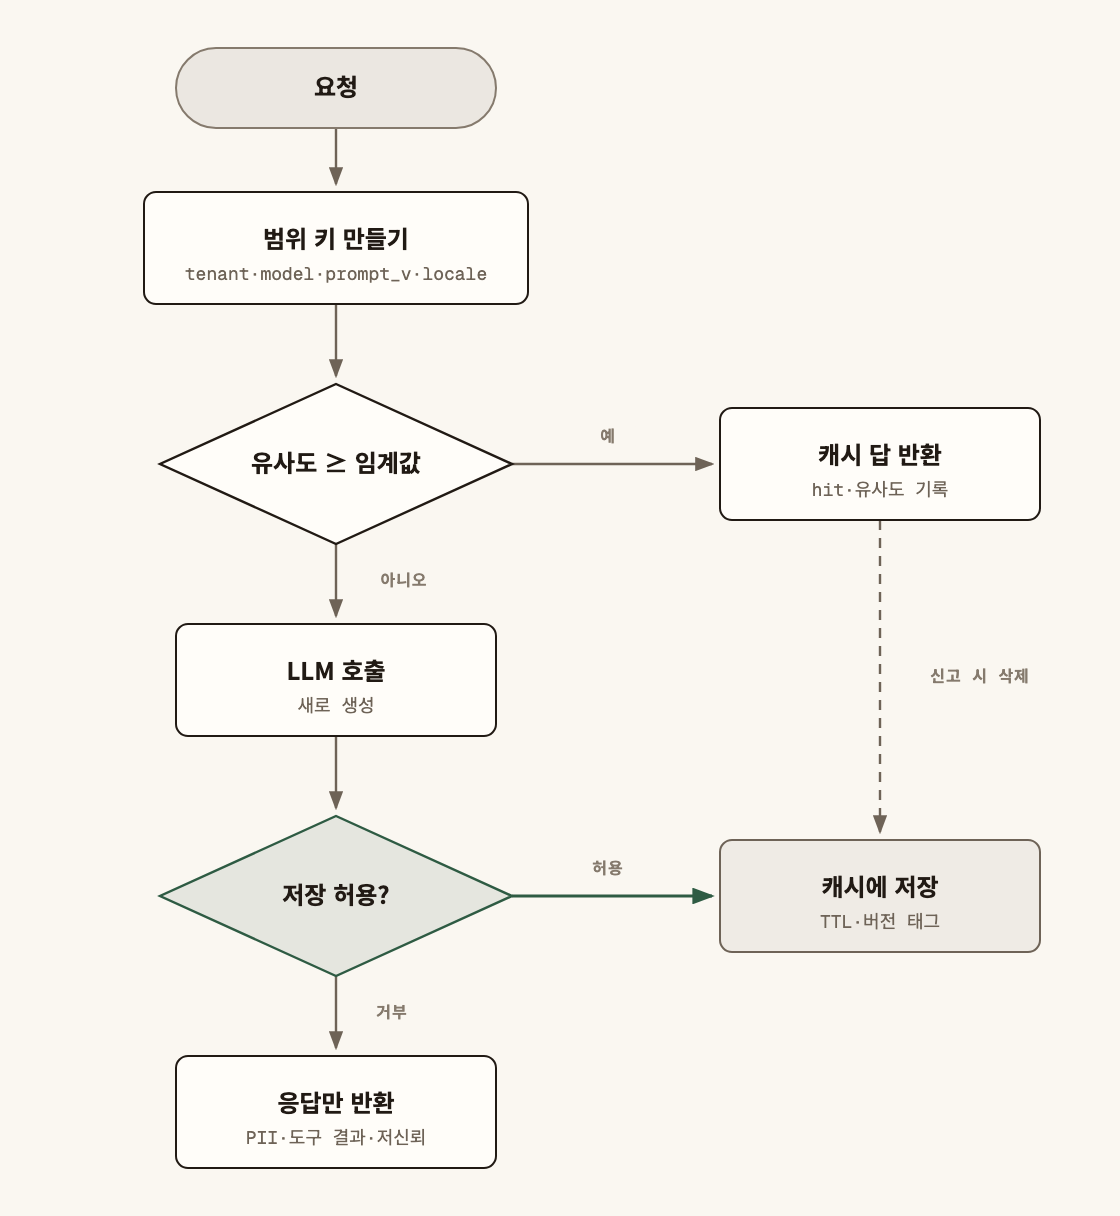
핵심은 두 개의 판정이다. 조회 쪽 "유사도가 임계값 이상인가"와 저장 쪽 "이 답을 남겨도 되는가". 대부분의 사고는 저장 쪽 판정을 빼먹어서 생긴다.
Exact-match 캐시와 Semantic Cache는 무엇이 다른가
Exact-match 캐시는 정규화한 프롬프트 문자열의 해시를 키로 쓴다. 글자 하나만 달라도 miss지만, hit이면 같은 입력이므로 답이 틀릴 위험은 원래 답의 위험과 같다. 일반 Redis Look-aside 캐시와 같은 구조다.
Semantic Cache는 질문을 임베딩 벡터로 바꾸고, 저장된 질문 벡터와 코사인 유사도를 비교한다. "비밀번호 재설정 방법"과 "비번 어떻게 바꿔요"가 같은 답을 받는다. hit률은 오르지만, hit 자체가 "아마 같은 질문일 것"이라는 추정이 된다. 이 추정이 틀리는 경우가 false hit이다.
Provider의 Prompt Caching과는 다른 것이다. Anthropic·OpenAI 같은 제공자의 prompt caching은 같은 프롬프트 앞부분(prefix)의 계산 결과를 재사용해 입력 처리 비용과 첫 토큰 지연을 줄인다. 답은 매번 새로 생성된다. Semantic Cache는 답 자체를 재사용한다. 둘은 같이 쓸 수 있고, 오염 위험은 Semantic Cache 쪽에만 있다.
캐시 키는 질문 문장만이 아니다
임베딩은 질문 문장으로 만들지만, 검색 범위는 답을 바꾸는 모든 조건으로 나눈다. 같은 질문이라도 아래 값이 다르면 다른 답이 맞다.
scope = (
  tenant_id,            # 고객사·조직. 개인 데이터가 있으면 user_id까지
  model,                # 모델 이름과 버전
  system_prompt_ver,    # 시스템 프롬프트·정책 버전
  kb_ver,               # RAG 문서 색인 버전
  params,               # temperature, 사용 가능한 도구 목록
  locale,               # 답 언어·지역
)
vector = embed(normalize(question))
- 정규화: 앞뒤 공백, 연속 공백, 전각·반각 정도만 맞춘다. 불용어를 지우거나 숫자를 지우면 "3월 청구서"와 "4월 청구서"가 같은 키가 된다.
- 범위는 벡터 검색의 필터로 건다. 전체에서 검색한 뒤 범위를 거르면, 상위 결과가 다른 테넌트 것일 때 hit이 사라지거나, 필터를 빼먹은 코드 한 줄로 바로 유출된다.
- 대화형 서비스는 마지막 질문만 키로 쓰면 안 된다. "그럼 그건 얼마예요?"는 앞 대화 없이는 뜻이 없다. 이런 후속 질문은 캐시를 건너뛰거나 앞 대화 요약까지 키에 넣는다.
임계값은 측정해서 정한다
유사도 임계값은 모델과 도메인마다 다르다. 다른 서비스의 값을 그대로 가져오면 안 된다.
false hit이 잘 나는 질문
- 부정어 하나 차이: "환불 가능한 경우"와 "환불 불가능한 경우"는 임베딩이 가깝게 나오기 쉽다.
- 고유명사·숫자 차이: "서울 지점 영업시간"과 "부산 지점 영업시간".
- 조건 추가: "요금제 해지"와 "약정 중 요금제 해지".
섀도 모드로 재는 순서
- 캐시를 켜되 답은 반환하지 않는다. hit이었을 경우의 후보 답과 유사도만 기록하고, LLM은 그대로 호출한다.
- 유사도 구간별(예시: 0.90
0.92, 0.920.94 …)로 후보 답과 실제 생성 답을 표본 비교한다. 사람이 보거나 LLM 판정기를 쓰고, 판정기는 사람 표본으로 한 번 맞춰 둔다. - 구간마다 false hit 비율을 구하고, 서비스가 허용할 수 있는 비율 아래인 가장 낮은 구간을 임계값으로 잡는다.
- 모델·임베딩 모델·문서가 바뀌면 다시 잰다.
허용 비율은 업무가 정한다. 사내 FAQ와 금융 상담은 같은 숫자를 쓸 수 없다. 숫자를 정하기 어렵다면 위험한 의도(결제, 계정, 의료)는 아예 캐시 대상에서 뺀다.
캐시 오염은 네 갈래로 들어온다
| 오염 경로 | 막는 장치 | 없으면 생기는 일 |
|---|---|---|
| 틀린 답 저장 | 저장 허용 규칙, 부정 피드백 삭제 | 한 번 틀린 답을 수천 명이 받는다 |
| 사용자 간 개인정보 유출 | 범위 분리, PII 검사 | A의 주문 내역이 B의 화면에 나온다 |
| 프롬프트 인젝션 결과 저장 | 도구·외부 문서 기반 답 저장 금지, 감사 로그 | 공격자 한 명의 입력이 모든 사용자 답이 된다 |
| 오래된 사실 | TTL, 문서·프롬프트 버전 무효화 | 바뀐 요금·정책을 계속 안내한다 |
세 번째가 가장 위험하다. 공격자가 문서나 입력에 숨긴 지시로 오염된 답을 만들고, 그 답이 캐시에 들어가면 공격자가 없는 다른 사용자 요청에도 재생된다. 인젝션 자체의 방어는 Tool Calling 보안과 Prompt Injection 방어에서 다뤘고, 캐시는 그 피해를 퍼뜨리는 증폭기라는 점만 기억하면 된다.
오염을 막는 다섯 가지 장치
1. 범위 분리: 앞의 scope로 인덱스나 네임스페이스를 나눈다. 개인 데이터가 들어간 답은 user_id 범위, 공용 지식만 쓴 답만 테넌트 범위에 둔다.
2. 저장 허용(write admission): miss 뒤 생성한 답을 무조건 저장하지 않는다. 다음을 모두 통과한 답만 저장한다.
- 응답이 정상 종료됐고 길이 제한·필터에 걸리지 않았다.
- PII 탐지에 걸리지 않았다.
- 도구 호출 결과, 실시간 값(재고·시세·날짜), 사용자 업로드 문서에 기댄 답이 아니다.
- 생성 설정이 캐시 정책과 맞다. temperature가 높은 창작형 응답은 저장하지 않는다.
- 가능하면 근거 확인(인용 문서 일치)이나 판정기 점수를 통과했다.
3. TTL과 버전 무효화: 모든 항목에 TTL을 둔다. 모델, 시스템 프롬프트, 문서 색인 버전이 바뀌면 키의 버전 값이 달라져 옛 항목은 자연히 조회되지 않는다. 남은 항목은 TTL로 사라진다.
4. 부정 피드백 삭제: 캐시에서 나간 답에 "틀렸어요"가 붙으면 그 항목을 즉시 지우거나 격리한다. 그러려면 응답에 캐시 항목 ID가 붙어 있어야 한다.
5. 감사 로그: hit마다 항목 ID, 유사도, 원래 질문, 저장 시각, 저장한 요청 ID를 남긴다. 오염을 발견했을 때 "누가 이 답을 받았는가"를 거꾸로 찾을 수 있어야 한다.
구현 예시
아래는 조회와 저장 허용 판정의 뼈대다. index, embed, detect_pii는 가상 인터페이스이며, 실제로는 Redis 벡터 검색, GPTCache 같은 도구나 직접 만든 저장소에 맞춰 바꾼다.
from dataclasses import dataclass

THRESHOLD = 0.93          # 예시 값. 섀도 모드로 잰 값으로 바꾼다
TTL_SECONDS = 6 * 3600    # 예시 값

@dataclass(frozen=True)
class Scope:
    tenant_id: str
    user_id: str | None   # 개인 데이터 답일 때만 채운다
    model: str
    system_prompt_ver: str
    kb_ver: str
    locale: str

def lookup(index, embed, scope: Scope, question: str):
    vec = embed(normalize(question))
    hit = index.search(vector=vec, filter=scope, k=1)   # 범위는 검색 필터로
    if hit is None or hit.score < THRESHOLD:
        return None
    audit_log("hit", entry_id=hit.id, score=hit.score, question=question)
    return hit

def admit(answer, *, used_tools: bool, temperature: float, detect_pii) -> bool:
    if answer.finish_reason != "stop":
        return False
    if used_tools or temperature > 0.3:   # 예시 기준
        return False
    if detect_pii(answer.text):
        return False
    return answer.grounded                # 근거 확인을 통과한 답만

def normalize(q: str) -> str:
    return " ".join(q.strip().split())
admit이 False를 돌려도 사용자는 정상 응답을 받는다. 저장만 하지 않을 뿐이다. 이 비대칭이 중요하다. 저장 규칙을 엄하게 잡아도 품질은 떨어지지 않고 hit률만 조금 내려간다.
비용 쪽 효과는 hit률과 모델 단가로 계산할 수 있다. 캐시를 모델 라우팅과 함께 쓰는 방법은 AI Agent의 비용 최적화에서, 캐시가 끼면 테스트 재현성이 어떻게 흔들리는지는 LLM 서비스의 비결정성과 재현 가능한 테스트 설계에서 다룬다.
자주 하는 실수
전체 인덱스에서 검색한 뒤 범위를 거른다. 필터 한 줄이 빠지면 바로 다른 테넌트 답이 나간다. 범위는 검색 조건이어야 한다.
다른 팀의 임계값을 그대로 쓴다. 임베딩 모델과 질문 분포가 다르면 같은 숫자가 전혀 다른 false hit 비율을 만든다.
생성한 답을 전부 저장한다. 틀린 답, 인젝션 결과, 개인정보가 한 번에 공용 자산이 된다.
모델·프롬프트를 바꾸고 캐시는 그대로 둔다. 새 버전을 배포했는데 사용자는 옛 버전 답을 계속 받는다. 버전 값을 키에 넣으면 따로 지울 필요가 없다.
캐시 hit을 로그에 남기지 않는다. 오염을 찾아도 영향 범위를 모르고, 피드백으로 항목을 지울 수도 없다.
점검표
- 캐시 범위에 tenant, 모델, 시스템 프롬프트 버전, 문서 색인 버전, 로케일이 들어 있다.
- 개인 데이터가 들어간 답은 user_id 범위에만 저장된다.
- 범위는 벡터 검색의 필터로 적용되고, 검색 후 거르기가 아니다.
- 임계값은 섀도 모드에서 구간별 false hit 비율을 재서 정했다.
- 저장 허용 규칙이 도구 결과, 실시간 값, PII, 비정상 종료 답을 거른다.
- 모든 항목에 TTL이 있다.
- 응답에 캐시 항목 ID가 붙고, 부정 피드백으로 그 항목을 지울 수 있다.
- hit마다 항목 ID, 유사도, 저장 요청 ID가 감사 로그에 남는다.
- 결제·계정·의료처럼 위험한 의도는 캐시 대상에서 빠져 있다.
- 모델이나 임베딩 모델을 바꾸면 임계값을 다시 잰다.
Semantic Cache는 조회 판정보다 저장 판정이 더 중요하다. 범위를 나눠 검색하고, 검증된 답만 버전과 TTL을 붙여 저장하고, 나간 답을 추적해 지울 수 있을 때 비용 절감이 사고로 바뀌지 않는다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.