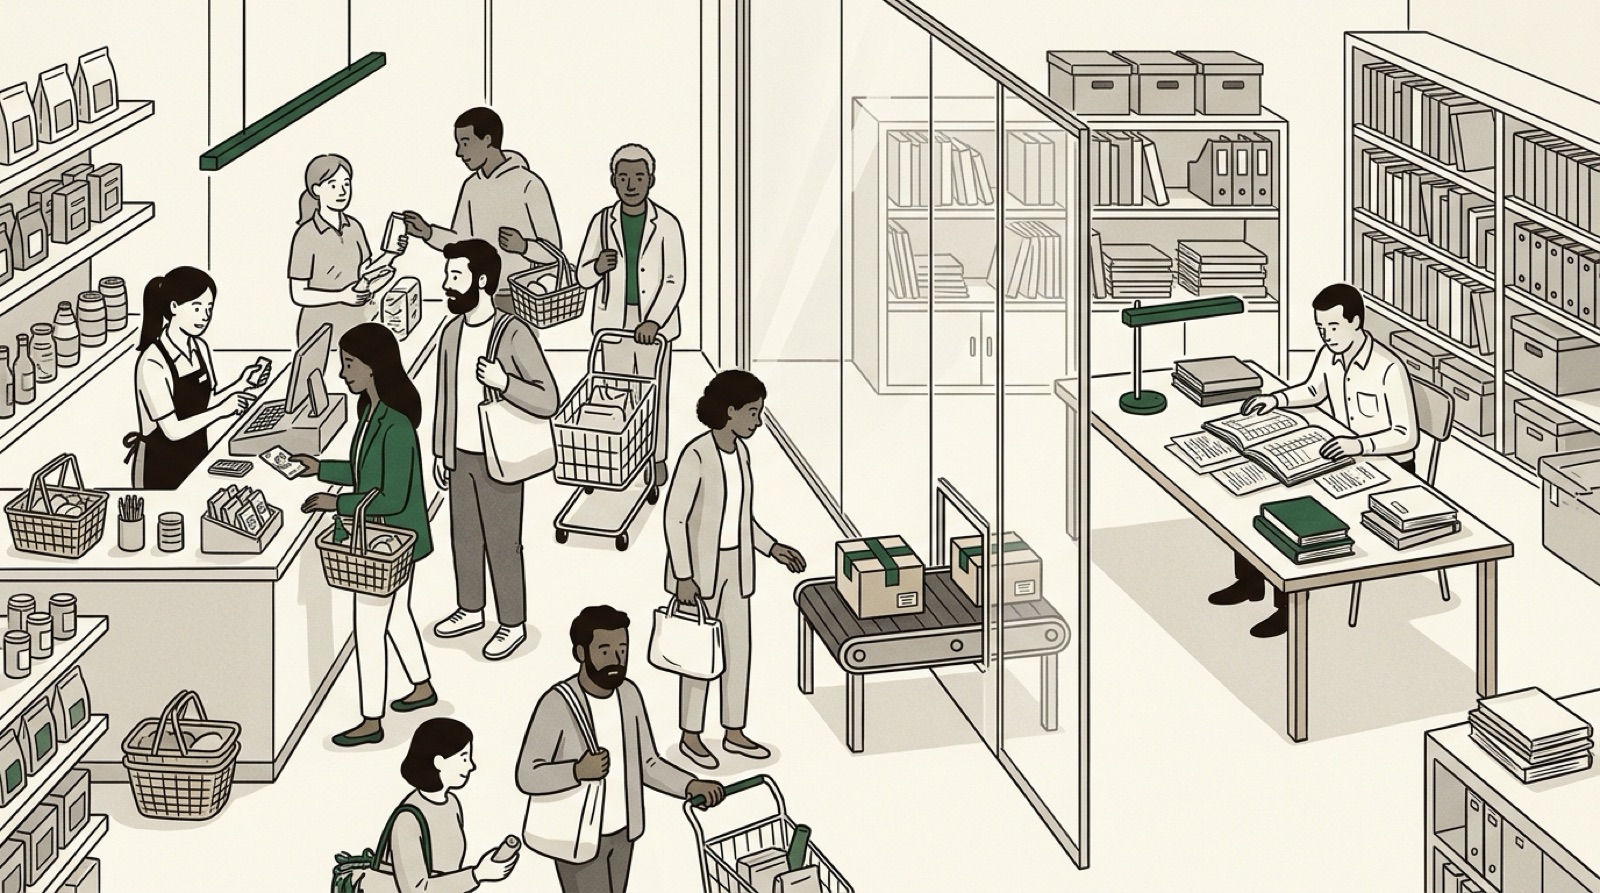
운영 DB 하나로 업무 처리와 통계를 함께 하면, 월말 집계 쿼리 한 번에 민원 접수 화면이 느려지는 일이 생긴다. 두 일은 데이터를 읽는 방식이 정반대라서 저장소를 나누는 것이 맞다. 다만 나누는 순간 "두 곳의 숫자가 같은가"라는 새 문제가 생긴다. 이 글은 OLTP와 OLAP를 왜, 어떤 순서로 분리하는지, 그리고 동기화 방식을 고르고 정합성을 검증하는 방법을 정리한 것이다.
한눈에 보기
| 단계 | 분석 쿼리가 도는 곳 | 데이터 지연 | 이 단계로 넘어가는 신호 |
|---|---|---|---|
| 0. 같은 DB | 운영 DB | 없음 | 집계 쿼리 시간에 운영 응답이 느려진다 |
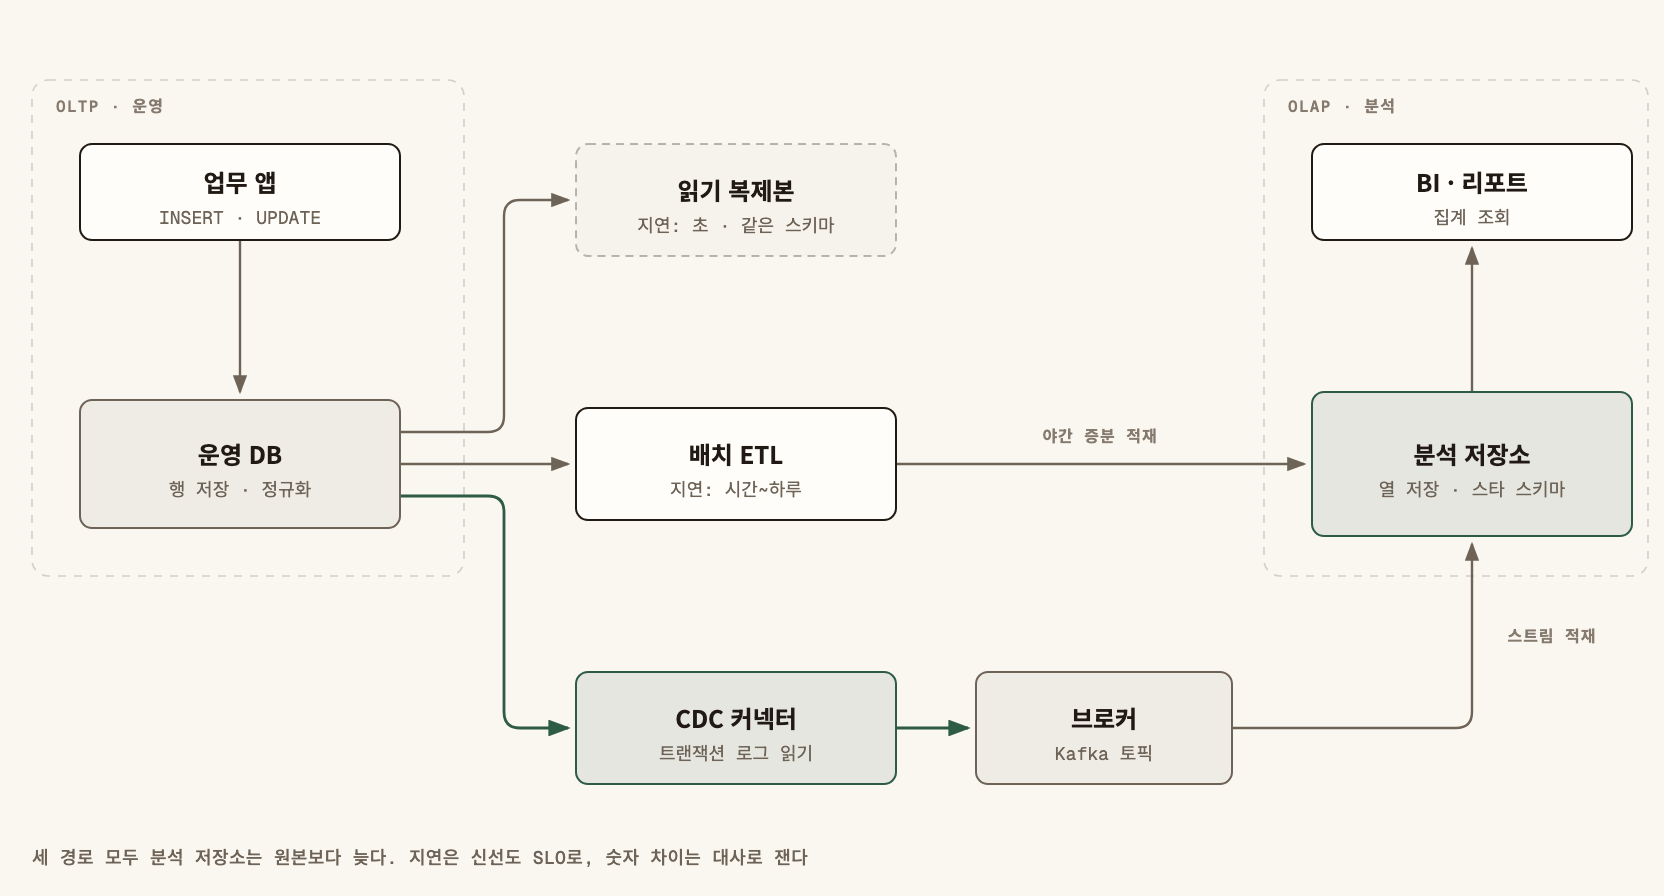
| 1. 읽기 복제본 | 복제본 | 초 단위 | 복제본에서도 쿼리가 수십 분 걸리거나 복제가 밀린다 |
| 2. 배치 ETL + DW | 분석 저장소 | 시간~하루 | 업무 부서가 "오늘 숫자"를 원한다 |
| 3. CDC 스트리밍 | 분석 저장소 | 초~분 | 원천 시스템이 늘고 원본 이력을 오래 보관해야 한다 |
| 4. 레이크하우스 | 객체 저장소 위 테이블 | 분 단위 | 여러 엔진(SQL, Spark, ML)이 같은 데이터를 읽어야 한다 |
모든 시스템이 4단계까지 갈 필요는 없다. 지금 겪는 문제를 해결하는 가장 낮은 단계에서 멈추는 것이 운영 비용이 가장 적다.
행 저장과 열 저장: 같은 데이터, 다른 질문
OLTP는 "신청 번호 2026-0001의 상태를 바꿔라" 같은 질문을 초당 수백 번 받는다. 행 하나를 찾아 행 전체를 읽고 쓴다. 그래서 행의 모든 컬럼을 한 페이지에 붙여 저장하는 행 저장이 유리하다.
OLAP는 "지난 3년간 기관별 신청 금액 합계" 같은 질문을 가끔 받는다. 행 수천만 개를 훑지만 컬럼은 세 개만 필요하다. 행 저장이면 필요 없는 컬럼 수십 개까지 디스크에서 읽어야 한다. 열 저장은 컬럼별로 따로 저장하므로 필요한 컬럼만 읽고, 같은 컬럼 값끼리 모여 있어 압축도 잘 된다.
| 항목 | OLTP (행 저장) | OLAP (열 저장) |
|---|---|---|
| 대표 질의 | PK로 한 건 조회·수정 | 넓은 범위 집계 |
| 한 번에 읽는 양 | 행 몇 개 | 행 수백만~수억 개, 컬럼 몇 개 |
| 쓰기 | 잦은 단건 INSERT/UPDATE | 묶음 적재 |
| 모델링 | 정규화(중복 제거) | 비정규화(스타 스키마) |
| 대표 제품 | PostgreSQL, Oracle, MySQL | ClickHouse, BigQuery, Redshift, Parquet 파일 |
모델링 방향이 반대라는 점이 중요하다. 같은 DB에서 둘을 다 하려면 어느 한쪽이 손해를 본다.
운영 DB에서 분석 쿼리를 돌리면 생기는 일
"새벽에만 돌리면 괜찮다"는 생각은 다음 세 가지 때문에 자주 깨진다.
장기 트랜잭션이 정리 작업을 막는다. MVCC DB는 오래 열린 트랜잭션이 볼 수 있는 옛 행 버전을 지우지 못한다. PostgreSQL에서는 VACUUM이 진행하지 못해 테이블이 부풀고, Oracle에서는 언두 공간이 모자라 ORA-01555 snapshot too old가 난다. 40분짜리 집계 하나가 하루 종일의 정리 작업을 미룬다.
DDL 락 대기가 줄을 세운다. 읽기는 쓰기를 막지 않지만 스키마 변경은 다르다. 집계 쿼리가 테이블을 읽는 동안 배포 스크립트의 ALTER TABLE이 배타 락을 기다리고, 그 뒤에 들어온 평범한 조회까지 모두 그 락 뒤에 줄을 선다. 배포 시각에 장애처럼 보이는 이유다.
I/O와 메모리를 운영 쿼리와 나눠 쓴다. 큰 테이블 전체 스캔은 디스크 대역폭을 차지하고, DBMS에 따라 자주 쓰던 페이지를 캐시에서 밀어낸다. 운영 쿼리의 실행 계획은 그대로인데 응답만 느려지므로 원인을 찾기 어렵다. 인덱스가 있어도 범위가 넓으면 Full Scan으로 가는 이유는 DB 인덱스가 있는데도 Full Scan이 발생하는 이유에 정리했다.
분리 4단계: 복제본에서 레이크하우스까지
1단계: 읽기 복제본. 가장 싸다. 운영 쿼리와 분석 쿼리를 물리적으로 떼어 놓는다. 하지만 스키마는 여전히 정규화된 운영 스키마이고, 복제본 쿼리도 원본에 영향을 준다. PostgreSQL은 hot_standby_feedback = on이면 복제본의 장기 쿼리가 원본의 VACUUM을 막고, off면 복제본 쿼리가 canceling statement due to conflict with recovery로 취소된다. 둘 중 하나는 감수해야 한다.
2단계: 배치 ETL과 데이터 웨어하우스. 밤마다 바뀐 데이터를 뽑아 분석용 모델로 바꿔 적재한다. 모델링 자유가 생기고 원본 부하는 추출 시간에만 생긴다. 대신 데이터는 하루 늦다.
3단계: CDC 스트리밍. DB 트랜잭션 로그에서 변경을 읽어 이벤트로 흘린다. 원본 테이블을 조회하지 않으므로 부하가 적고, 삭제까지 잡힌다. 커넥터와 브로커라는 운영 대상이 늘어난다. 구성과 운영 방법은 함께 올린 CDC와 Debezium으로 DB 변경 이벤트 수집하기에 있다.
4단계: 레이크하우스. 변경 이벤트를 객체 저장소의 열 저장 테이블(Iceberg 등)에 쌓고, 여러 엔진이 같은 테이블을 읽는다. 자세한 구조는 Data Lakehouse 아키텍처와 Apache Iceberg를 참고한다.
분석 저장소는 언제나 원본보다 늦다. 이 지연을 받아들이는 것은 일관성과 지연 사이의 선택이며, CAP Theorem과 PACELC로 분산 시스템 설계 결정하기의 "정상일 때도 지연과 일관성을 고른다"는 이야기와 같다. 업무 화면용 읽기 모델을 따로 두는 방식은 Event Sourcing과 CQRS를 도입해야 하는 시점에서 다뤘다.
| 방식 | 지연 | 원본 부하 | 삭제 감지 | 구축·운영 복잡도 |
|---|---|---|---|---|
| 읽기 복제본 | 초 | 복제 + 복제본 쿼리 영향 | 해당 없음(원본 그대로) | 낮음 |
| 전체 덤프 배치 | 하루 | 추출 시간에 큼 | 됨(전체 비교) | 낮음 |
| 증분 배치(워터마크) | 시간 | 중간 | 안 됨 | 중간 |
| CDC 스트리밍 | 초~분 | 로그 읽기만 | 됨 | 높음 |
증분 적재와 워터마크의 함정
증분 배치는 보통 updated_at > 지난번 최댓값 조건으로 바뀐 행만 읽는다. 단순하지만 세 군데에서 데이터를 잃는다.
- 삭제가 안 보인다. 지워진 행은 조건에 걸릴 행 자체가 없다. 논리 삭제(
deleted_at)로 바꾸거나, 주기적으로 PK 목록 전체를 비교하거나, CDC로 간다. - 늦게 커밋된 행을 놓친다.
updated_at은 보통 문장 실행 시각인데, 커밋은 더 늦을 수 있다. 10:00:00에 값을 쓰고 10:00:30에 커밋한 행은, 10:00:10에 추출이 돌아 워터마크를 10:00:09로 올렸다면 다음 실행에서 영영 빠진다. updated_at을 안 바꾸는 쓰기가 있다. 운영자가 SQL로 직접 고치거나 일괄 보정 배치가 컬럼을 갱신하지 않으면 그 변경은 사라진다. 트리거나 DB 기본값으로 강제한다.
늦은 커밋은 겹쳐 읽기와 PK 기준 병합으로 막는다. 몇 분을 다시 읽어도 결과가 같도록 적재를 멱등하게 만드는 것이 핵심이다.
-- 1) 추출: 지난 워터마크보다 5분 앞부터 다시 읽고, 방금 쓰인 1분은 다음 실행으로 미룬다
SELECT id, org_id, status, amount, created_at, updated_at
FROM application
WHERE updated_at >= :last_watermark - INTERVAL '5 minutes'
  AND updated_at <  :run_started_at - INTERVAL '1 minute';

-- 2) 적재: PK로 병합하므로 겹쳐 읽은 행은 덮어쓰기만 된다 (PostgreSQL 15 이상 MERGE)
MERGE INTO dw.fact_application t
USING stg.application s ON t.application_id = s.id
WHEN MATCHED AND s.updated_at > t.source_updated_at THEN
  UPDATE SET status = s.status, amount = s.amount, source_updated_at = s.updated_at
WHEN NOT MATCHED THEN
  INSERT (application_id, org_id, status, amount, created_at, source_updated_at)
  VALUES (s.id, s.org_id, s.status, s.amount, s.created_at, s.updated_at);
겹치는 폭 5분은 예시다. 운영 DB에서 가장 긴 쓰기 트랜잭션 시간보다 크게 잡는다. 다음 워터마크는 이번에 읽은 updated_at 최댓값으로 저장한다.
스타 스키마로 분석 모델 만들기
분석 저장소에 운영 테이블을 그대로 복사하면 조인 10개짜리 쿼리를 분석가가 매번 다시 짜야 한다. 스타 스키마는 이것을 팩트 하나와 디멘션 여러 개로 정리한다.
- 팩트: 측정 대상 사건. 신청 1건, 결제 1건처럼 숫자(금액, 건수)를 가진다.
- 디멘션: 사건을 자르는 기준. 기관, 날짜, 신청 유형, 지역.
- 그레인부터 정한다. "팩트 한 행은 신청 1건"인지 "기관별 하루 합계"인지 먼저 적는다. 그레인이 섞이면 합계가 두 번 더해진다.
- 바뀌는 디멘션은 이력을 남긴다. 기관이 통폐합되면 지난달 통계를 옛 기관명으로 볼지 새 기관명으로 볼지 정해야 한다. 옛 이름을 유지하려면 유효 기간 컬럼(
valid_from,valid_to)을 둔 SCD Type 2로 만든다.
운영 DB의 대용량 이력 테이블을 기간별로 나눠 관리하는 방법은 PostgreSQL Partitioning과 대용량 테이블 관리에 정리했다. 분석 저장소의 팩트 테이블도 같은 기준(날짜)으로 나누면 적재와 보관 정책이 단순해진다.
신선도 SLO와 대사 검증
분리하고 나면 두 가지를 숫자로 감시해야 한다. 얼마나 늦은지(신선도)와 숫자가 맞는지(정합성)다.
신선도. "분석 저장소의 데이터는 업무 시간 99%에서 15분 이내로 최신이다(예시)"처럼 SLO로 정한다. now() - max(source_updated_at)로 재면 원본에 변경이 없는 새벽에 지연이 커 보인다. 운영 DB에 1분마다 시각을 갱신하는 하트비트 행을 두고, 그 행이 분석 저장소에 도착한 시각으로 지연을 잰다.
대사. 같은 기간을 양쪽에서 집계해 비교한다. 건수만 맞추면 금액이 틀린 행을 못 잡으므로 합계를 함께 본다.
-- 운영 DB와 분석 저장소에서 같은 기간, 같은 시간대 기준으로 실행해 결과를 비교한다
SELECT CAST(created_at AS DATE) AS d, COUNT(*) AS cnt, SUM(amount) AS total
FROM application
WHERE created_at >= :from AND created_at < :to   -- :to 는 현재 시각보다 1시간 이전
GROUP BY CAST(created_at AS DATE)
ORDER BY d;
아직 전달 중인 데이터 때문에 생기는 차이를 오류로 보지 않도록 최근 1시간은 빼고 비교한다. 차이가 나면 해당 날짜의 PK 목록을 비교해 빠진 행을 찾는다. 이 검증을 규칙으로 만들어 매일 돌리는 방법은 함께 올린 데이터 정합성 검증 자동화와 Data Contract 설계에서 다룬다.
자주 하는 실수
복제본이면 원본에 영향이 없다고 믿는다. hot_standby_feedback 설정에 따라 복제본 장기 쿼리가 원본 VACUUM을 막거나, 반대로 분석 쿼리가 계속 취소된다.
워터마크를 >로 딱 맞게 끊는다. 늦게 커밋된 행과 같은 시각의 행이 빠진다. 겹쳐 읽고 PK로 병합한다.
하드 삭제를 증분 배치로 따라가려 한다. 지워진 행은 조건에 걸리지 않는다. 분석 저장소에는 지워진 신청이 계속 남는다.
시간대를 맞추지 않고 대사한다. 운영 DB는 KST, 분석 저장소는 UTC로 날짜를 자르면 매일 자정 근처 9시간치가 다른 날로 넘어가 건수가 어긋난다.
운영 스키마를 그대로 복사하고 DW라고 부른다. 분석가가 매번 조인을 다시 짜고, 사람마다 다른 숫자가 나온다. 그레인과 팩트·디멘션을 먼저 정한다.
점검표
- 운영 DB에서 실행 중인 분석·통계 쿼리 목록과 최장 실행 시간을 안다.
- 현재 분리 단계(0~4)와 다음 단계로 넘어갈 신호를 문서에 적었다.
- 동기화 방식별 지연·원본 부하·삭제 감지 여부를 비교해 선택 이유를 남겼다.
- 증분 추출이 겹쳐 읽기와 PK 병합으로 멱등하게 동작한다.
- 겹치는 폭이 운영 DB의 가장 긴 쓰기 트랜잭션보다 길다.
- 삭제를 논리 삭제, 전체 PK 비교, CDC 중 하나로 감지한다.
- 팩트 테이블마다 그레인을 한 문장으로 적었다.
- 신선도 SLO가 있고 하트비트로 지연을 잰다.
- 날짜별 건수·합계 대사가 매일 돌고, 같은 시간대 기준을 쓴다.
OLTP와 OLAP를 나누는 일은 저장소를 하나 더 두는 일이 아니라, 지연을 얼마나 허용할지 정하고 그 지연과 숫자 차이를 매일 재는 체계를 갖추는 일이다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.