일반 RAG는 질문을 한 번 검색하고 찾은 문서를 붙여 바로 답한다. 질문이 여러 단계를 거치거나 답이 여러 저장소에 흩어져 있으면 이 한 번의 검색이 빗나가고, 모델은 빈약한 근거로 그럴듯한 답을 만든다. 이 글은 검색 자체를 판단의 대상으로 만드는 Agentic RAG가 일반 RAG와 구조적으로 어디가 다른지, 그리고 그 대가로 무엇을 관리해야 하는지 정리한다.
한눈에 보기
| 구분 | 일반 RAG | Agentic RAG |
|---|---|---|
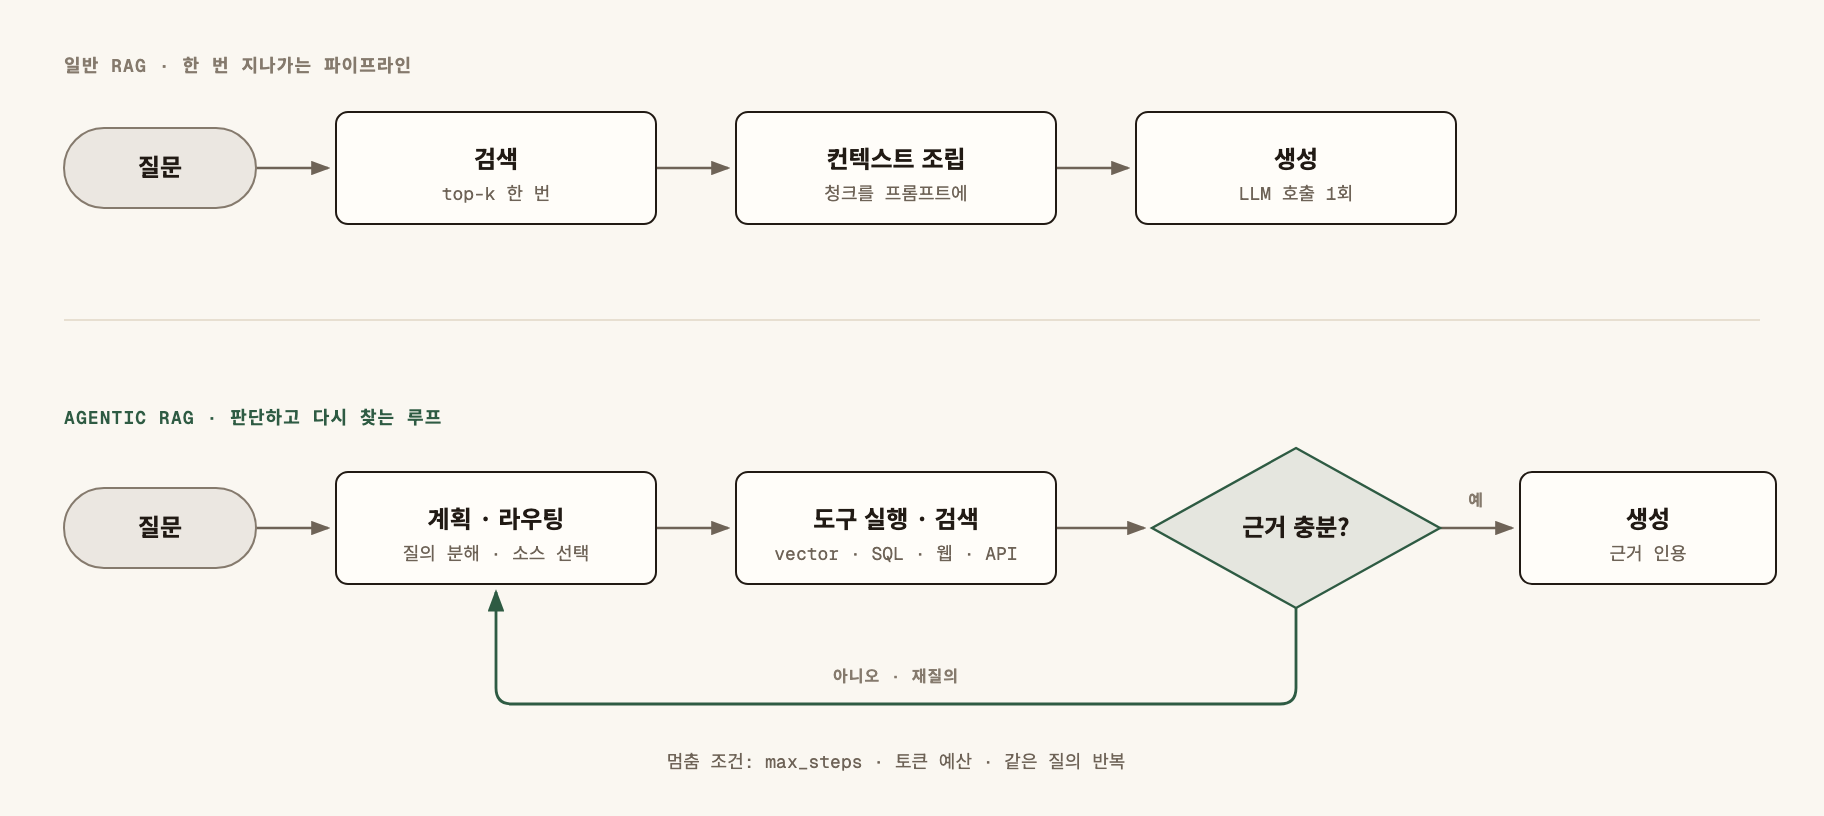
| 흐름 | 질문 → 검색 → 조립 → 생성, 한 번 | 계획 → 검색 → 평가 → 재질의, 반복 |
| 검색 대상 | 벡터 인덱스 하나 | 벡터 DB, SQL, 웹, 내부 API 중 선택 |
| 검색 횟수 | 고정(보통 1회) | 질문마다 다름, 상한으로 제한 |
| 근거 확인 | 없음. top-k를 그대로 믿음 | 문서별 관련성 평가 + 충분성 판단 |
| 비용·지연 | 예측 가능 | 반복 횟수만큼 늘어남 |
| 실패 모습 | 엉뚱한 문서로 답함 | 반복, 도구 오용, 컨텍스트 비대 |
일반 RAG의 구조와 한계
일반 RAG는 파이프라인이다. 질문을 임베딩해 top-k 청크를 가져오고, 프롬프트에 붙여 LLM을 한 번 호출한다. 단계가 고정이라 지연과 비용을 예측하기 쉽고, 문제가 생기면 어느 단계가 틀렸는지 찾기도 쉽다.
한계는 "검색은 한 번, 결과는 무조건 믿는다"는 전제에서 나온다.
- 여러 단계 질문(multi-hop). "A 시스템을 만든 팀이 작년에 바꾼 인증 방식은?"은 팀을 먼저 찾아야 두 번째 검색어가 생긴다. 한 번의 검색으로는 두 번째 사실에 닿지 못한다.
- 흩어진 소스. 정책은 문서에, 수치는 DB에, 최신 공지는 웹에 있으면 벡터 인덱스 하나로는 다 모을 수 없다.
- 빗나간 검색을 모른다. top-k가 관련 없는 청크여도 파이프라인은 그대로 생성한다. 모델은 근거 없이 답을 지어낸다.
검색 품질 자체가 낮은 문제라면 루프보다 먼저 Hybrid Search와 Reranking으로 한 번의 검색을 좋게 만드는 편이 싸다. Agentic RAG는 검색을 잘해도 한 번으로는 풀 수 없는 질문을 위한 구조다.
Agentic RAG의 구성 요소
Agentic RAG는 LLM이 검색을 "언제, 어디서, 몇 번 할지" 정한다. ReAct 계열의 추론·행동 반복을 검색에 적용한 형태다. 구성 요소는 다섯 가지다.
- 계획(planner). 질문을 하위 질의로 나누고 각 질의를 어느 소스에 보낼지 정한다.
- 라우터와 도구. 하위 질의를 벡터 검색, SQL, 웹 검색, 내부 API 호출 같은 도구로 실행한다.
- 평가(grader). 가져온 문서가 그 질의에 관련 있는지 하나씩 판정해 걸러 낸다.
- 판단(judge). 모인 근거로 원래 질문에 답할 수 있는지, 빠진 정보가 무엇인지 말한다.
- 제어기(controller). 단계 수, 토큰 예산, 반복 질의를 보고 루프를 끊는다. LLM이 아니라 코드다.
라우팅은 소스별 성격을 계획 단계에 알려 주는 일이다.
| 소스 | 맞는 질문 | 주의할 점 |
|---|---|---|
| 벡터 DB | 문서 속 설명·절차 | 숫자·고유 코드에 약함 |
| SQL | 집계, 기간 조건, 정확한 값 | 읽기 전용 계정, 허용 테이블 제한 |
| 웹 검색 | 최신 공지, 외부 사실 | 출처 신뢰도, 프롬프트 주입 |
| 내부 API | 실시간 상태, 사용자별 데이터 | 권한 범위, 호출 한도 |
웹과 API에서 온 텍스트는 지시문이 섞여 들어올 수 있는 입력이다. 도구 권한과 주입 방어는 AI Agent의 Tool Calling 보안과 Prompt Injection 방어에서 다룬 기준을 그대로 적용한다.
근거 평가와 재질의
일반 RAG와 가장 크게 다른 지점이 평가다. 검색 결과를 생성에 넘기기 전에 두 번 거른다.
문서 단위 평가. 각 문서가 하위 질의에 관련 있는지 예/아니오로 판정한다. 관련 없는 문서를 버리면 생성 단계의 컨텍스트가 짧아지고, 엉뚱한 근거를 인용할 일이 줄어든다. 검색 결과를 평가하고 부족하면 다른 검색으로 보완하는 생각은 Corrective RAG(CRAG), 생성 중에 검색 필요 여부와 근거를 스스로 비평하는 생각은 Self-RAG라는 이름의 연구에서 다뤄졌다.
충분성 판단. 걸러진 근거 전체로 원래 질문에 답할 수 있는지 본다. 부족하면 "빠진 것"을 문장으로 받아 다음 질의를 만든다. "팀 이름은 찾았고 인증 방식 변경 이력이 없다"처럼 구체적이어야 재질의가 같은 검색을 되풀이하지 않는다.
평가에는 생성보다 작은 모델을 써도 되는 경우가 많다. 단계마다 어떤 모델을 쓸지 정하는 방법은 AI Agent의 비용 최적화: Model Routing과 Token Budget에 정리했다.
멈춤 조건과 예산
루프는 멈추는 조건이 먼저다. 판단이 계속 "부족"이라고 말하면 Agentic RAG는 끝없이 검색한다. 멈춤 조건은 LLM의 판단이 아니라 코드가 강제한다.
- 최대 단계(max_steps). 계획–검색–평가 한 바퀴를 한 단계로 센다.
- 토큰 예산. 누적 입력·출력 토큰이 상한을 넘으면 멈춘다.
- 반복 질의 차단. 이미 던진 질의와 같은 질의가 나오면 새 정보가 없다는 뜻이다.
- 시간 상한. 사용자 응답 지연의 상한을 넘으면 그때까지의 근거로 답한다.
멈췄을 때는 "근거가 부족한 채로 답한다"는 표시를 남긴다. 확인된 것과 확인 못 한 것을 나눠 말하게 하면, 예산 때문에 끊긴 답이 확신에 찬 답처럼 보이지 않는다.
구현 예시: max_steps와 grader가 있는 루프
특정 프레임워크에 묶이지 않은 의사 코드다. planner, grader, judge, replan, generate는 각각 LLM 호출, TOOLS는 허용한 도구만 담은 사전이다.
MAX_STEPS = 4            # 예시 값
TOKEN_BUDGET = 12_000    # 예시 값

def answer(question: str) -> str:
    evidence, seen, used = [], set(), 0
    verdict = Verdict(enough=False, missing=[question])
    plan = planner(question)                      # 하위 질의 + 소스
    for _ in range(MAX_STEPS):
        pending = [q for q in plan.subqueries if q.text not in seen]
        if not pending:
            break                                 # 새 질의가 없으면 반복이다
        for q in pending:
            seen.add(q.text)
            tool = TOOLS.get(q.source)            # 허용 목록 밖 소스는 실행하지 않음
            if tool is None:
                continue
            docs = [d for d in tool(q.text) if grader(q.text, d).relevant]
            evidence.extend(docs)
            used += sum(d.tokens for d in docs)   # 단순화: 실제로는 LLM 호출 토큰도 더한다
        verdict = judge(question, evidence)       # enough + missing
        if verdict.enough or used > TOKEN_BUDGET:
            break
        plan = replan(question, verdict.missing, seen)
    return generate(question, evidence, partial=not verdict.enough)
핵심은 세 줄이다. seen이 같은 질의의 반복을 막고, TOOLS.get이 계획이 지어낸 도구 이름을 걸러 내고, partial 표시가 예산 때문에 끊긴 답을 구분한다. LangGraph 같은 그래프 기반 프레임워크로 옮겨도 이 세 가지는 노드와 조건 분기로 그대로 남아야 한다.
비용·지연과 실패 유형
Agentic RAG의 비용은 "검색 한 번 + 생성 한 번"이 아니라 "단계 수 × (계획 + 도구 + 평가)"에 생성이 더해진 값이다. 평가 호출은 문서 수만큼 늘어난다. 그래서 평균보다 꼬리 지연이 먼저 나빠진다.
| 실패 유형 | 모습 | 막는 장치 |
|---|---|---|
| 반복 루프 | 같은 질의를 표현만 바꿔 계속 던짐 | seen 비교, max_steps |
| 도구 오용 | SQL에 서술형 질문, 웹에 내부 코드 검색 | 소스별 설명을 계획 프롬프트에, 허용 목록 |
| 컨텍스트 비대 | 단계마다 문서가 쌓여 생성 입력이 넘침 | 문서 평가로 거르기, 단계별 요약 |
| 판단 과신 | 근거가 없는데 "충분"이라고 함 | 인용 필수, 인용 없는 문장 거부 |
| 독립 하위 질의의 직렬 실행 | 서로 무관한 검색을 하나씩 기다림 | 병렬 실행 후 합치기 |
쌓이는 근거를 어디까지 컨텍스트에 남길지는 Context Engineering과 메모리 계층 설계의 계층 구분을, 독립 하위 질의를 나눠 돌리는 방법은 Multi-Agent Orchestration에서 병렬 처리와 충돌 방지를 참고한다.
일반 RAG로 충분한 경우
Agentic RAG를 기본값으로 두면 대부분의 질문에서 비용만 늘어난다. 다음이면 일반 RAG를 쓴다.
- 질문 대부분이 문서 한 곳에서 답이 나오는 FAQ·매뉴얼 검색이다.
- 응답 지연 상한이 짧아 LLM 호출을 여러 번 할 여유가 없다.
- 소스가 벡터 인덱스 하나뿐이라 라우팅할 대상이 없다.
- 평가 데이터가 없어 루프가 정말 나아졌는지 잴 수 없다.
현실적인 구성은 둘을 섞는 것이다. 질문 분류기가 단순 질문은 일반 RAG로, 여러 단계 질문만 Agentic 경로로 보낸다. 이렇게 하면 비용은 어려운 질문에만 든다.
자주 하는 실수
- 멈춤 조건을 LLM에게 맡긴다. "충분하면 멈춰라"만 있으면 판단이 흔들릴 때 루프가 끝나지 않는다.
- 검색 품질 문제를 루프로 덮는다. 청크 분할이나 임베딩이 나쁘면 몇 번을 다시 찾아도 같은 문서가 나온다.
- 평가 없이 반복만 붙인다. 문서를 거르지 않으면 단계가 늘수록 잡음이 쌓여 답이 오히려 나빠진다.
- 도구 결과를 지시로 읽게 둔다. 웹 페이지 안의 "이전 지시를 무시하라"가 계획 단계로 흘러 들어간다.
- 단계별 기록을 남기지 않는다. 어떤 질의가 어느 도구로 갔는지 없으면 틀린 답의 원인을 찾을 수 없다.
점검표
- Agentic 경로가 필요한 질문 유형을 예시와 함께 정의했다.
- 단순 질문은 일반 RAG로 보내는 분류 단계가 있다.
- max_steps, 토큰 예산, 시간 상한이 코드에 상수로 있다.
- 이미 던진 질의를 기록하고 같은 질의를 다시 실행하지 않는다.
- 계획이 고를 수 있는 도구는 허용 목록 안에만 있다.
- SQL 도구는 읽기 전용 계정과 허용 테이블로 제한했다.
- 문서마다 관련성 평가를 거친 뒤에만 근거로 쓴다.
- 예산 때문에 멈춘 답에는 근거 부족 표시가 붙는다.
- 단계별 질의·도구·평가 결과·토큰을 추적 로그로 남긴다.
- 같은 평가 세트로 일반 RAG와 정확도·비용·지연을 비교했다.
일반 RAG는 검색을 한 번 하고 믿는 파이프라인이고, Agentic RAG는 검색을 계획하고 결과를 의심하며 코드가 정한 예산 안에서 다시 찾는 루프다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.