LLM 답변은 다 만들어질 때까지 수 초에서 수십 초가 걸리므로, 첫 글자를 빨리 보여 주는 스트리밍이 체감 속도를 좌우한다. 그런데 로컬에서 잘 흐르던 SSE가 운영에서는 한꺼번에 쏟아지거나, 60초마다 끊기거나, 창을 닫아도 LLM 호출이 끝까지 돌아 비용이 나간다. 이 글은 브라우저–Nginx–Spring–LLM API 경로에서 SSE 형식, fetch 파서, WebFlux 중계, 프록시 설정, 취소 전파, 끝 이벤트 설계를 정리한 것이다.
한눈에 보기
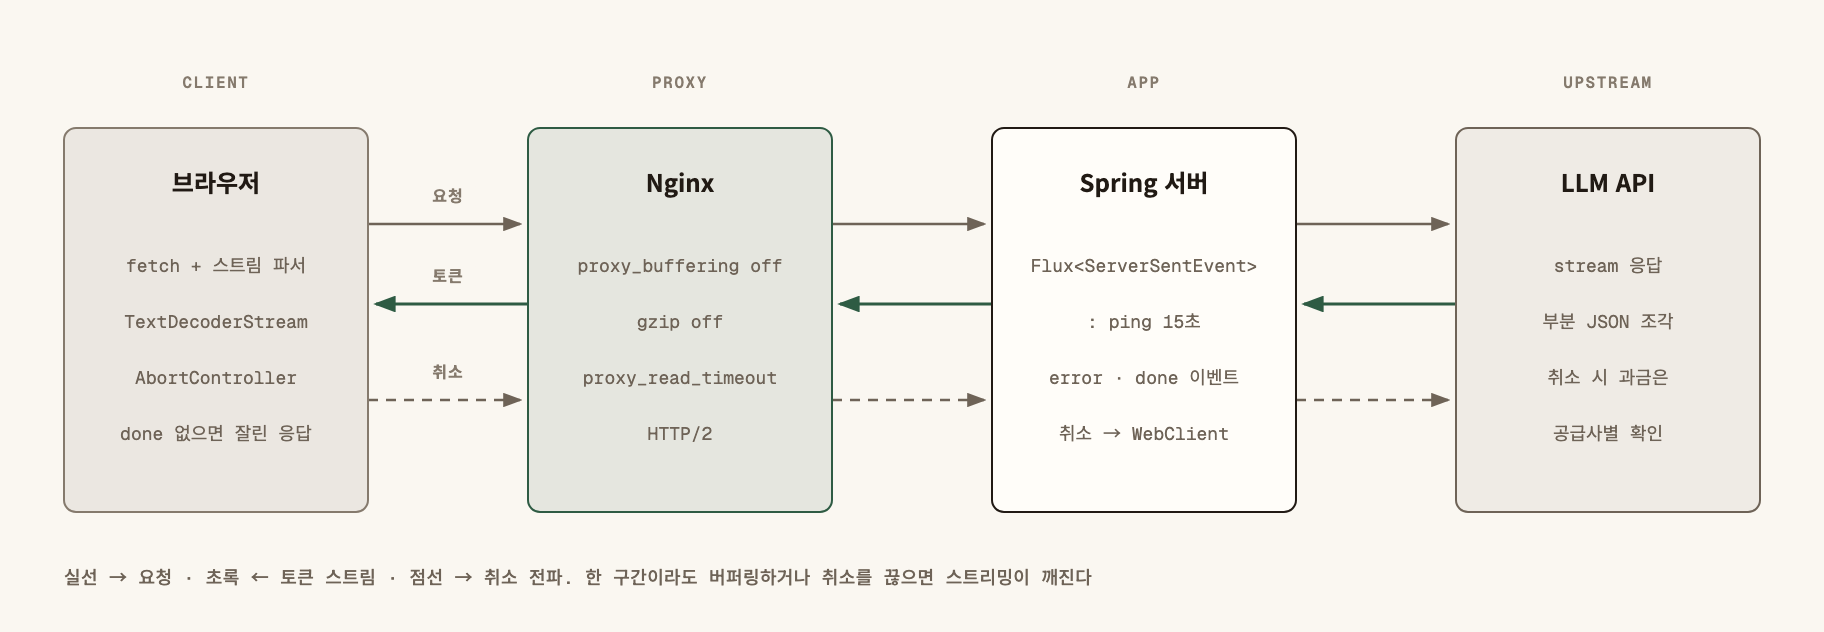
스트리밍이 줄이는 것은 전체 응답 시간이 아니라 첫 토큰까지의 시간(TTFT, Time To First Token)이다. 500토큰 답변이 초당 50토큰으로 생성되면 일괄 응답은 10초 뒤에 화면이 바뀌지만, 스트리밍은 1초 안팎부터 글자가 찍힌다(예시 수치). 대신 연결이 10초 넘게 열려 있고, 모든 구간이 "조금씩 보내기"를 지켜야 한다.
| 구간 | 흔한 문제 | 대응 |
|---|---|---|
| 브라우저 | EventSource는 GET만, 헤더 불가 |
fetch + ReadableStream 파싱 |
| Nginx·로드밸런서 | 응답 버퍼링, gzip, 유휴 타임아웃 | proxy_buffering off, 압축 제외, heartbeat |
| Spring 서버 | 클라이언트가 떠나도 상류 호출 계속 | 취소를 LLM 요청까지 전파 |
| LLM API | 중간 오류, 부분 JSON | 끝 이벤트로 사용량·오류 전달, 다 모은 뒤 파싱 |
SSE 형식: 필드 네 개와 빈 줄
SSE(Server-Sent Events)는 Content-Type: text/event-stream 응답 본문에 줄 단위 텍스트를 이어 쓰는 형식이고, 이벤트 하나는 빈 줄로 끝난다.
retry: 3000
: ping

id: 42
event: delta
data: {"text":"안녕"}

event: done
data: {"inputTokens":812,"outputTokens":164}
data:본문. 여러 줄이면 줄바꿈으로 이어 붙인다.event:이벤트 이름. 없으면message다.id:이벤트 번호.EventSource는 재연결 때 이 값을Last-Event-ID헤더로 보낸다.retry:재연결 대기 시간(밀리초).:로 시작하는 줄은 주석이라 무시된다. heartbeat에 쓴다.
빈 줄이 오기 전까지 이벤트는 끝나지 않는다. 빈 줄을 빠뜨리면 클라이언트는 아무것도 받지 못한 것처럼 보인다.
EventSource 대신 fetch로 읽는다
EventSource는 GET만 보내고 Authorization 같은 헤더를 붙일 수 없어, 대화 기록을 본문에 담아 POST로 보내는 LLM 채팅에 맞지 않는다. 같은 출처의 쿠키 인증은 되지만, 토큰을 쿼리 문자열로 넘기면 접근 로그에 남는다.
fetch는 메서드·헤더·본문이 자유롭고 AbortController로 취소된다. 대신 파싱을 직접 한다.
export async function streamChat(message, onEvent, signal) {
  const res = await fetch('/api/chat/stream', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json', Accept: 'text/event-stream' },
    body: JSON.stringify({ message }),
    signal,
  });
  if (!res.ok || !res.body) throw new Error(`stream failed: ${res.status}`);

  // TextDecoderStream: 청크 경계에서 잘린 한글(UTF-8 3바이트)을 이어 붙여 준다
  const reader = res.body.pipeThrough(new TextDecoderStream()).getReader();
  let buf = '';
  for (;;) {
    const { value, done } = await reader.read();
    if (done) return;
    buf += value;
    let m;
    while ((m = buf.match(/\r?\n\r?\n/))) {
      const ev = parseFrame(buf.slice(0, m.index));
      buf = buf.slice(m.index + m[0].length);
      if (ev) onEvent(ev);
    }
  }
}

function parseFrame(frame) {
  let event = 'message', id = null;
  const data = [];
  for (const line of frame.split(/\r?\n/)) {
    if (line.startsWith(':')) continue;            // heartbeat 주석
    const i = line.indexOf(':');
    const field = i < 0 ? line : line.slice(0, i);
    const value = i < 0 ? '' : line.slice(i + 1).replace(/^ /, '');
    if (field === 'event') event = value;
    else if (field === 'id') id = value;
    else if (field === 'data') data.push(value);
  }
  return data.length ? { event, id, data: data.join('\n') } : null;
}
Spring WebFlux로 중계한다
서버는 LLM API 스트림을 받아 자기 형식의 SSE로 다시 내보낸다. 공급사 이벤트를 그대로 넘기면 공급사를 바꿀 때 프런트까지 바뀐다. OpenAI Chat Completions 스트림의 마지막 data: [DONE] 같은 공급사별 표기는 서버에서 done 이벤트 하나로 바꾼다.
@PostMapping(value = "/api/chat/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public Flux<ServerSentEvent<String>> stream(@RequestBody ChatRequest req) {
    Flux<ServerSentEvent<String>> body = llmClient.stream(req)      // 예시용 래퍼: 내부에서 WebClient bodyToFlux로 공급사 스트림을 읽는다
        .map(c -> c.isFinal()
                ? sse("done", c.usageJson())
                : sse("delta", c.textJson()))
        .onErrorResume(e -> Flux.just(
                sse("error", "{\"code\":\"UPSTREAM_ERROR\"}"),
                sse("done", "{}")))
        .doOnCancel(() -> log.info("client left"));

    Flux<ServerSentEvent<String>> ping = Flux.interval(Duration.ofSeconds(15))
        .map(i -> ServerSentEvent.<String>builder().comment("ping").build());

    return body.mergeWith(ping)
        .takeUntil(ev -> "done".equals(ev.event()));   // done 뒤 ping도 멈춤
}

private static ServerSentEvent<String> sse(String event, String json) {
    return ServerSentEvent.builder(json).event(event).build();
}
WebFlux는 클라이언트 연결이 끊기면 구독을 취소하고, 그 취소가 WebClient까지 올라가 LLM API 연결을 닫는다. Spring MVC SseEmitter는 자동이 아니므로 onCompletion·onTimeout·onError 콜백에서 상류 요청을 직접 닫는다.
백프레셔는 Reactor가 네트워크 쓰기 속도에 맞춰 요청량(demand)을 조절해 준다. 토큰마다 이벤트를 보내 이벤트 수가 부담되면 30~50ms 단위로 묶어 보낸다.
중간 구간: 버퍼링, 압축, 타임아웃
운영에서 스트림이 끝에 한꺼번에 오면 대개 중간 프록시가 응답을 모아 두는 것이다. Nginx는 기본으로 upstream 응답을 버퍼링한다.
location /api/chat/stream {
    proxy_pass http://app;
    proxy_http_version 1.1;
    proxy_set_header Connection "";
    proxy_buffering off;          # 응답 헤더 X-Accel-Buffering: no 로 요청별로 꺼도 된다
    proxy_cache off;
    gzip off;
    proxy_read_timeout 300s;      # 두 번의 읽기 사이 간격 기준. heartbeat 주기보다 길게
}
| 설정 | 위치 | 없으면 생기는 일 |
|---|---|---|
proxy_buffering off 또는 X-Accel-Buffering: no |
Nginx / 응답 헤더 | 토큰이 모였다가 한꺼번에 도착한다 |
압축 제외(gzip off, 압축 MIME에서 text/event-stream 제외) |
Nginx, 앱 서버 | 압축기가 버퍼를 채울 때까지 내보내지 않는다 |
proxy_read_timeout > heartbeat 주기 |
Nginx | 모델이 오래 생각하는 동안 60초(기본값)에 끊긴다 |
15초 안팎의 : ping 주석 |
앱 서버 | 로드밸런서 유휴 타임아웃에 끊기고, 끊김 감지도 늦다 |
proxy_read_timeout은 두 번 읽기 사이의 간격이라 heartbeat가 15초마다 오면 기본값 60초로도 끊기지 않는다. Nginx 앞 로드밸런서·CDN의 유휴 타임아웃도 따로 확인한다. HTTP/1.1에서는 탭 여러 개가 도메인당 연결 6개를 다 써 다른 요청이 멈추므로 HTTP/2를 켠다. 적용 지점은 TLS를 끊는 곳이다(TLS 종료 지점과 Reverse Proxy 신뢰 경계 설계).
취소와 재연결
사용자가 "중지"를 누르거나 탭을 닫아도 서버의 LLM 호출은 계속 도는 경우가 많다. 아무도 보지 않는 토큰에 비용을 내는 셈이다. 취소는 세 홉을 모두 건너야 한다.
- 브라우저:
AbortController.abort()로fetch를 끊는다. - 서버: 끊김을 감지해 상류 요청을 취소한다. 보통 다음 쓰기 때 끊김을 알게 되므로 heartbeat가 감지 주기가 된다.
- LLM API: 연결이 닫히면 생성을 멈추는지, 이미 만든 토큰을 과금하는지는 공급사마다 다르다. 문서에서 확인한다.
Last-Event-ID를 받아도 모델은 중간부터 다시 생성하지 못한다. 이어 받기가 꼭 필요하면 서버가 이벤트를 id와 함께 Redis 같은 저장소에 짧은 TTL로 쌓아 두고 재연결 때 그 뒤부터 보낸다. 그럴 필요가 없다면 끊긴 응답은 실패로 보고 "다시 생성" 버튼을 보여 주는 편이 단순하다. 배포 중에는 긴 SSE 연결이 드레인을 막으므로 종료 순서도 맞춘다(Kubernetes Pod Lifecycle과 Graceful Shutdown 설계).
끝 이벤트: 사용량, 오류, 부분 JSON
스트리밍은 첫 바이트와 함께 200 OK가 이미 나갔다. 중간에 LLM이 실패해도 상태 코드를 바꿀 수 없으므로 오류는 error 이벤트로 알리고, 정상이든 오류든 마지막에 done을 보낸다. 클라이언트는 done 없이 닫힌 연결을 잘린 응답으로 처리한다. 이 구분이 없으면 잘린 답변이 완성본처럼 저장된다.
done에는 토큰 수, 모델 이름, 종료 사유를 담아 비용 집계에 쓴다(AI Agent의 비용 최적화: Model Routing과 Token Budget).
구조화 출력이나 tool call 인자는 JSON 조각으로 나뉘어 온다. 도구 호출 단위로 문자열을 모았다가 끝난 뒤 한 번 파싱하고 검증한다. 검증은 LLM Structured Output과 응답 스키마 검증 설계의 3단 검증을 그대로 쓴다.
자주 하는 실수
- 로컬에서만 확인한다. 로컬에는 프록시가 없어 버퍼링이 드러나지 않는다.
- gzip을 전역으로 켠다. 이벤트 스트림이 압축되면 덩어리로 도착한다.
- 오류를 상태 코드로 알리려 한다. 이미 200이 나가 정상 종료와 구분되지 않는다.
- 취소를 상류로 전파하지 않는다. 사용자가 떠난 뒤에도 LLM 호출이 비용과 동시 호출 한도를 쓴다.
- 부분 JSON을 조각마다 파싱한다. 오류가 쏟아지고, 잘못하면 미완성 인자로 도구를 실행한다.
점검표
- 운영과 같은 프록시 경로에서 첫 토큰이 바로 도착한다.
- 스트림 경로에
proxy_buffering off또는X-Accel-Buffering: no가 적용되어 있다. -
text/event-stream이 Nginx·앱 서버 압축 대상에서 빠져 있다. - heartbeat 주기가 경로의 모든 유휴 타임아웃보다 짧다.
- 청크 경계에 걸친 한글이 깨지지 않는다.
- 중지·탭 닫기가 LLM API 요청 취소로 이어지는 것을 로그로 확인했다.
- 모든 스트림이 사용량을 담은
done으로 끝나고,done없는 종료는 잘린 응답으로 처리한다. - tool call·구조화 출력은 다 모은 뒤 한 번 파싱하고 검증한다.
LLM 스트리밍의 핵심은 SSE 형식보다, 브라우저에서 LLM API까지 모든 구간이 조금씩 보내고 함께 끊기게 맞추는 데 있다.
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.